La fabrication des circuits intégrés : lithographie, FinFET et rendement
Étapes du procédé, lithographie et critère de Rayleigh, EUV, FinFET et grille enrobante, rendement de Poisson démontré, coût par puce avec un exemple, chiplets.
https://www.electronics-engineering.com/fr/fabrication-des-circuits-integres-lithographie-rendement/
Un processeur moderne contient des dizaines de milliards de transistors sur quelques centimètres carrés de silicium, avec des détails de quelques nanomètres, et il est produit à des millions d’exemplaires. La leçon de Dispositifs électroniques sur la logique CMOS a présenté la fabrication. Ici, nous la regardons de plus près : les étapes du procédé, la lithographie et sa limite de résolution, les structures des transistors modernes, et le rendement, avec la démonstration du modèle de Poisson et de son effet sur le coût d’une puce, ce qui explique pourquoi les grandes puces sont désormais scindées en chiplets.
Les étapes du procédé
On part d’une plaquette (wafer), un disque de silicium monocristallin ultra-pur de 300 mm de diamètre. On y construit les circuits couche par couche, en répétant des centaines de fois quelques opérations de base :
- oxydation et dépôt de couches isolantes, conductrices et semi-conductrices ;
- lithographie : on étale une résine photosensible, on l’expose à travers un masque qui porte le motif de la couche, et on la développe ;
- gravure, chimique ou par plasma, qui enlève le matériau non protégé par la résine ;
- dopage par implantation ionique, suivi d’un recuit rapide qui répare le réseau cristallin et active les atomes dopants ;
- métallisation : interconnexions en cuivre, jusqu’à 15-20 niveaux superposés séparés par des isolants à faible constante diélectrique, réalisées avec le procédé damascène (on creuse des tranchées dans l’isolant, on les remplit de cuivre et l’on aplanit le tout par polissage mécano-chimique).
La partie inférieure, avec les transistors, s’appelle le front end ; la partie supérieure, avec les interconnexions, le back end. À la fin, les circuits sont testés sur la plaquette, qui est découpée en puces (dies) individuelles, puis mises en boîtier.
La lithographie
La taille minimale qu’on peut imprimer est limitée par la diffraction de la lumière. Le critère de Rayleigh donne la résolution
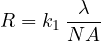
avec  la longueur d’onde,
 l’ouverture numérique de l’optique et
 un facteur de procédé, que les techniques les plus raffinées poussent vers la limite théorique de 0,25. Pendant des années, on a utilisé de la lumière ultraviolette à 193 nm, améliorée par l’immersion dans l’eau (qui porte au-dessus de 1) et par la multiplication des motifs (multiple patterning : répartir un motif dense sur deux ou quatre masques). Aujourd’hui, les couches les plus fines sont imprimées avec de l’ultraviolet extrême (EUV) à 13,5 nm, produit par des gouttelettes d’étain frappées par un laser et focalisé avec des miroirs, parce qu’à cette longueur d’onde aucun matériau n’est transparent. Les machines EUV sont parmi les instruments les plus complexes jamais construits.
Les noms des procédés (« 3 nm », « 2 nm ») ne correspondent plus à une dimension physique : ce sont des étiquettes commerciales pour une génération. La distance minimale entre les grilles de transistors est de quelques dizaines de nanomètres.
Les transistors modernes
Le MOSFET planaire ne parvient plus à contrôler le canal quand il est trop court (leçon sur le MOSFET nanométrique). Depuis 2011, on utilise le FinFET : le canal est une mince « ailette » (fin) verticale de silicium, enveloppée par la grille sur trois côtés, qui la contrôle bien mieux. Les générations les plus récentes passent aux transistors à grille enrobante (gate-all-around, nanofeuillets), avec le canal fait de minces couches horizontales empilées entièrement entourées par la grille. L’isolant de grille n’est plus du dioxyde de silicium mais un matériau à constante diélectrique élevée, avec une grille métallique, pour obtenir un couplage fort sans courants de fuite par effet tunnel.
Le rendement
Toutes les puces d’une plaquette ne fonctionnent pas : particules de poussière, défauts cristallins, erreurs de lithographie ruinent certains circuits. La fraction de bonnes puces est le rendement, et il est décisif pour le coût.
Théorème. Si les défauts fatals sont répartis au hasard et indépendamment sur la plaquette, avec une densité moyenne  par unité de surface, le rendement d’une puce de surface
 est

Démonstration. Avec des défauts indépendants et uniformes, le nombre de défauts qui tombent dans une surface suit une loi de Poisson de moyenne  : la probabilité d’en trouver exactement
 est
 . La puce fonctionne si elle n’en contient aucun :
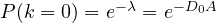 . ∎
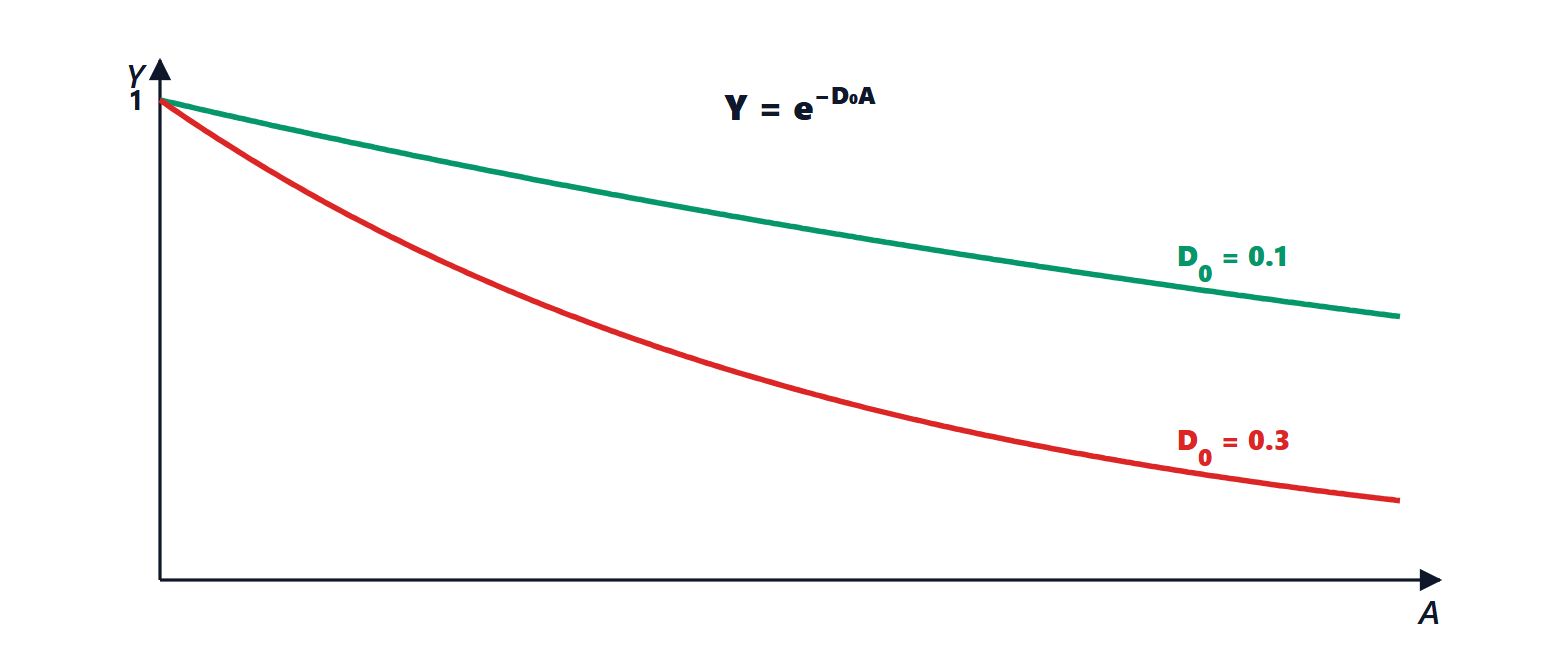
En réalité les défauts tendent à s’agglomérer et le modèle de Poisson est un peu pessimiste pour les grandes puces ; on utilise des variantes (Murphy, binomiale négative), mais la tendance exponentielle demeure.
Exemple. Une plaquette de 300 mm contient environ 640 puces de 1 cm² et environ 143 puces de 4 cm² (les bords gaspillent plus de place avec de grandes puces). Avec  par cm², les rendements sont de 90,5 % et de 67 % : les bonnes puces sont environ 580 et environ 96. La puce de 4 cm² a quatre fois la surface mais coûte environ six fois plus. C’est pourquoi les plus grands processeurs sont aujourd’hui construits à partir de plusieurs chiplets : de petites puces à haut rendement, testées séparément et assemblées sur un substrat ou un interposeur de silicium avec des connexions très denses. On peut aussi mélanger des procédés différents, le plus avancé pour la logique et un moins cher pour les interfaces.


Benvenuti nella pagina su «Fabbricazione dei circuiti integrati: litografia, FinFET e resa». L'ho scritta pensando a chi studia ingegneria elettronica: se un passaggio non vi torna, un esercizio vi dà un risultato diverso o volete altro materiale sull'argomento, chiedete pure nei commenti e vi risponderò. Un voto con le stelle qui sopra mi aiuta a capire quali pagine migliorare.Welcome to the page on “Integrated circuit fabrication: lithography, FinFETs and yield”. I wrote it for engineering students: if a step does not add up, an exercise gives you a different result or you would like more material on the topic, just ask in the comments and I will reply. A star rating above helps me understand which pages to improve.