De l'imitation à l'apprentissage par renforcement : comment sont entraînés les systèmes de conduite chinois
Pourquoi l'apprentissage par imitation ne suffit pas, ce qu'apportent l'apprentissage par renforcement et les modèles du monde, et comment XPeng, Li Auto, Momenta, BYD et Huawei disent les utiliser.
https://www.electronics-engineering.com/fr/de-l-imitation-a-l-apprentissage-par-renforcement-systemes-de-conduite-chinois/
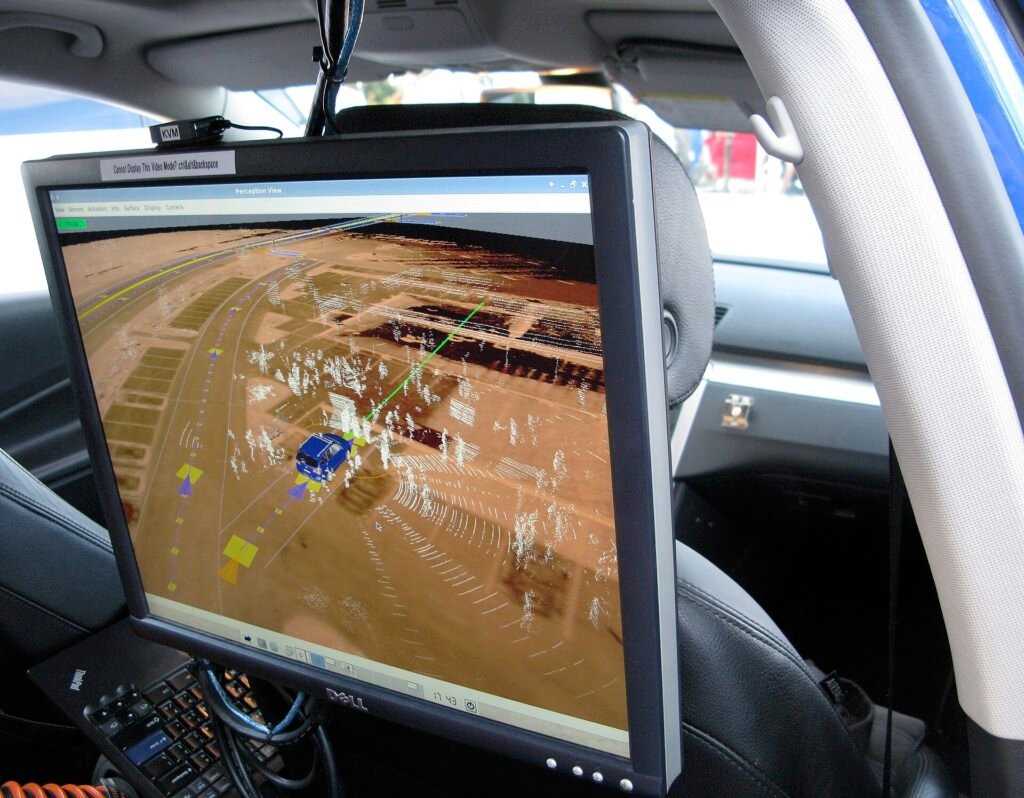
Ces dernières années, les grands systèmes d’aide à la conduite en Chine ont surtout été entraînés par imitation : on montre à un réseau de neurones des millions de séquences de personnes conduisant bien et on lui apprend à faire de même. Cela fonctionne étonnamment bien, jusqu’à un certain point. En 2025 et 2026, presque tous les grands acteurs se sont mis à parler d’apprentissage par renforcement (RL) et de modèles du monde. Cet article explique, sans mathématiques lourdes, pourquoi l’imitation ne suffit pas, ce qu’apporte le RL, et comment des entreprises comme Li Auto, XPeng, Momenta et BYD disent l’utiliser.
La limite de l’apprentissage par imitation
L’apprentissage par imitation (aussi appelé clonage comportemental) traite la conduite comme un problème supervisé : en entrée, les données des capteurs ; comme cible, ce que l’humain a fait ensuite. Le réseau apprend le comportement moyen des bons conducteurs. Deux problèmes apparaissent vite.
- Les petites erreurs s’accumulent. Le réseau n’a vu que ce que font les bons conducteurs ; il a donc rarement vu une voiture dériver vers le bord de la voie, car les bons conducteurs ne s’y retrouvent pas. Quand ses propres petites erreurs l’amènent dans un tel état, il n’a aucun exemple de la manière de se rétablir. Les chercheurs appellent cela le décalage de covariables (covariate shift).
- La moyenne n’est pas toujours la bonne réponse. À un tourne-à-gauche non protégé, certains conducteurs passent et d’autres attendent. Faire la moyenne des deux peut produire un demi-mouvement hésitant qu’aucun humain ne ferait. Apprendre « ce que les gens ont fait » n’est pas la même chose qu’apprendre « ce qui est sûr et efficace ».
Davantage de données aide, mais les situations rares, celles qui causent des accidents, sont par définition rares dans les données.
Ce que change l’apprentissage par renforcement
En RL, on ne dit pas au réseau (la politique) ce qu’il doit faire. Il agit, observe les conséquences et reçoit une récompense : positive s’il atteint l’objectif en douceur, négative pour une collision, une sortie de voie, un freinage brutal, un feu rouge grillé. Au fil de nombreux essais, il apprend un comportement qui maximise la récompense totale. Deux conséquences comptent ici :
- la politique vit les résultats de ses propres erreurs, et apprend donc à s’en rétablir ;
- elle peut, en principe, devenir meilleure que les conducteurs présents dans les données, car elle optimise un objectif au lieu de copier une moyenne.
L’inconvénient évident : on ne peut pas laisser une voiture apprendre en s’écrasant sur des routes réelles. Le RL a besoin d’un environnement où des millions d’essais sont peu coûteux et sans danger. Cet environnement est un simulateur, et c’est là qu’interviennent les modèles du monde.
Les modèles du monde : un simulateur appris à partir de vidéos
Les simulateurs traditionnels sont construits comme des jeux vidéo : routes, voitures et piétons modélisés à la main. Ils sont utiles, mais l’écart avec les vraies images des caméras est grand. Un modèle du monde prend une autre voie : un réseau génératif, entraîné sur d’énormes quantités de vidéos de conduite réelles, qui prédit ce que les caméras verront ensuite, compte tenu de ce qu’elles ont vu jusque-là et de ce que la voiture décide de faire. On braque à gauche dans la simulation et les images générées montrent la voiture se déplacer vers la gauche, tandis que les autres usagers réagissent.
XPeng a publié en avril 2026 un rapport technique sur son modèle du monde, X-World (XPeng). C’est un modèle de diffusion vidéo qui génère simultanément la vue de sept caméras, conditionnée par les actions planifiées de la voiture, par les autres usagers et par la configuration de la route. XPeng dit l’utiliser de trois façons : pour évaluer son modèle de conduite VLA 2.0 en boucle fermée (taux de collision, progression, confort), comme environnement pour l’apprentissage par renforcement en ligne sur des cas difficiles tels que des piétons surgissant aux intersections ou l’hésitation lors des changements de voie dans les embouteillages, et pour générer des scénarios rares absents des données réelles. L’entreprise indique être passée d’environ 30 000 scénarios simulés à plus de 500 000, avec une simulation quotidienne équivalant à 30 millions de km de conduite.
Li Auto décrit une chaîne similaire pour son modèle MindVLA : un modèle du monde dans le cloud qui combine la reconstruction 3D de scènes réelles avec la complétion générative des vues, utilisé pour du RL en boucle fermée à grande échelle, après un pré-entraînement et un affinage sur de la conduite réelle (Gasgoo). La partie reconstruction s’appuie souvent sur le 3D Gaussian splatting, une technique qui transforme des trajets enregistrés en scènes pouvant être rendues à nouveau depuis de nouveaux points de vue. Un article de Horizon Robotics et de chercheurs universitaires, RAD, a montré en 2025 qu’une politique de conduite entraînée par RL dans ce type d’environnement reconstruit avait un taux de collision bien plus faible que la même politique entraînée par la seule imitation.
Ce que disent les autres acteurs
- Momenta appelle son modèle actuel R6 « flywheel » et le présente comme fondé sur l’apprentissage par renforcement ; il est en production sur des modèles de GAC Toyota, Chery et Buick, entre autres (Wikipedia).
- BYD a lancé God’s Eye 5.0 en janvier 2026 en mettant l’accent sur l’apprentissage par renforcement et le contrôle de bout en bout en boucle fermée, et affirme que sa flotte collecte plus de 160 millions de km de données de conduite assistée par jour (CarNewsChina).
- Huawei utilise un modèle du monde comme terrain d’entraînement de son ADS 4, mais a ouvertement critiqué l’approche VLA de XPeng et de Li Auto, préférant un modèle « world action » sans l’étape de langage (ChinaEVHome).
VLA signifie vision, langage, action : un modèle construit sur un grand modèle de langage, capable de raisonner sur la scène avec des mots (« le bus s’arrête, des passagers peuvent traverser ») avant de produire la trajectoire. Ses partisans disent que cela aide dans les situations inhabituelles et rend le système plus facile à inspecter. Ses détracteurs, Huawei en tête, disent que l’étape de langage ajoute de la latence et du coût de calcul sans que la voiture conduise mieux. Les deux camps s’accordent sur un point : l’amélioration finale vient de l’entraînement en boucle fermée, pas de davantage d’imitation.
Le plus difficile, c’est la récompense
Quiconque a essayé le RL sur un problème jouet connaît le point faible. La politique optimise exactement ce que l’on récompense, pas ce que l’on voulait dire. Si l’on ne récompense que la progression, elle apprend à se faufiler agressivement ; si l’on pénalise chaque freinage, elle devient imprudente ; si l’on pénalise trop les collisions, elle peut décider que le plus sûr est de ne jamais quitter sa place de parking. Les systèmes réels combinent de nombreux termes (sécurité, respect des règles, confort, progression) et conservent souvent la perte d’imitation comme point d’ancrage, de sorte que la politique reste proche du style humain tout en s’améliorant sur les cas rares.
L’autre risque, c’est le simulateur lui-même. Si le modèle du monde a un angle mort, par exemple s’il ne génère jamais un cycliste brûlant un feu rouge, la politique peut apprendre à exploiter cette lacune. C’est pourquoi les entreprises insistent sur la validation sur routes réelles, et pourquoi les nouvelles normes chinoises exigent des constructeurs qu’ils documentent ensemble la simulation, les essais sur piste et les essais sur route.
Pourquoi cela compte au-delà de la Chine
La combinaison est nouvelle : des millions de voitures de série collectent des données, des modèles du monde génératifs transforment ces données en simulateur interactif, et l’entraînement par RL se fait à l’intérieur. Les entreprises chinoises avancent plus vite que la plupart parce qu’elles ont la flotte, la pression du marché et une autorité qui, tout en étant stricte sur la communication commerciale, autorise un large déploiement des systèmes de niveau 2. Volkswagen a déjà choisi le VLA 2.0 de XPeng pour ses propres modèles, avec des livraisons prévues à partir de 2027 (XPeng). Les méthodes d’entraînement décrites ici arriveront probablement sur les routes européennes plus tôt que beaucoup ne l’imaginaient.







Hi, I am the author of “From imitation to reinforcement learning: how Chinese driving systems are trained”. Questions, doubts, error reports and requests for more detail are all welcome: write them below and I will answer. You can also rate the page with the stars at the top of the article.