Dall'imitazione all'apprendimento per rinforzo: come si addestrano i sistemi di guida cinesi
Perché l'apprendimento per imitazione non basta, cosa aggiungono l'apprendimento per rinforzo e i modelli del mondo, e come dicono di usarli XPeng, Li Auto, Momenta, BYD e Huawei.
https://www.electronics-engineering.com/it/dall-imitazione-all-apprendimento-per-rinforzo-sistemi-di-guida-cinesi/
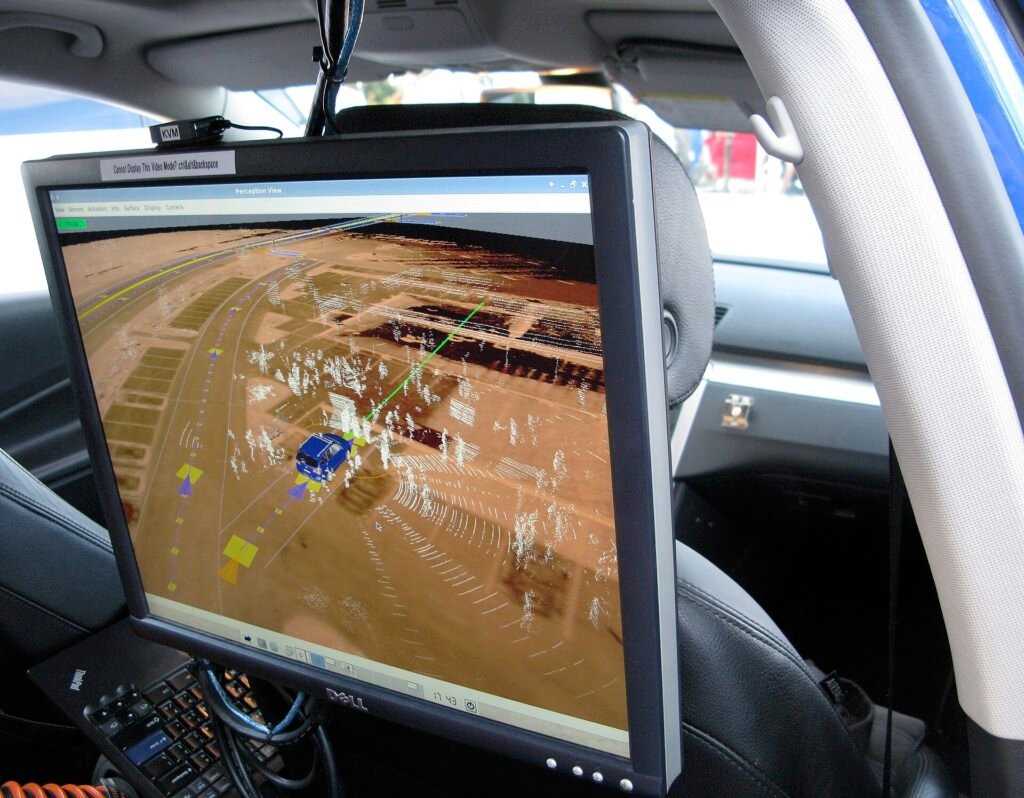
Negli ultimi anni i grandi sistemi di assistenza alla guida in Cina sono stati addestrati soprattutto per imitazione: si mostrano a una rete neurale milioni di clip di persone che guidano bene e le si insegna a fare lo stesso. Funziona sorprendentemente bene, fino a un certo punto. Nel 2025 e nel 2026 quasi tutti i principali attori hanno cominciato a parlare di apprendimento per rinforzo (RL) e di modelli del mondo. Questo articolo spiega, senza matematica pesante, perché l’imitazione non basta, cosa aggiunge l’RL e come aziende come Li Auto, XPeng, Momenta e BYD dicono di usarlo.
Il limite dell’apprendimento per imitazione
L’apprendimento per imitazione (detto anche clonazione del comportamento) tratta la guida come un problema supervisionato: ingresso, i dati dei sensori; obiettivo, ciò che l’uomo ha fatto subito dopo. La rete impara il comportamento medio dei buoni conducenti. Due problemi emergono presto.
- I piccoli errori si accumulano. La rete ha visto solo ciò che fanno i buoni conducenti, il che significa che ha visto raramente un’auto che deriva verso il bordo della corsia, perché i buoni conducenti non ci finiscono. Quando i suoi stessi piccoli errori la portano in uno stato simile, non ha esempi di come rimediare. I ricercatori lo chiamano covariate shift.
- La media non è sempre giusta. A una svolta a sinistra senza precedenza, alcuni conducenti passano e altri aspettano. Fare la media dei due può produrre una mezza mossa esitante che nessun essere umano farebbe. Imparare «cosa hanno fatto le persone» non è lo stesso che imparare «cosa è sicuro ed efficiente».
Più dati aiutano, ma le situazioni rare, quelle che causano incidenti, sono per definizione rare nei dati.
Cosa cambia l’apprendimento per rinforzo
Nell’RL alla rete (la politica) non si dice cosa fare. Agisce, vede le conseguenze e riceve una ricompensa: positiva per aver raggiunto l’obiettivo con scorrevolezza, negativa per una collisione, per essere uscita dalla corsia, per una frenata brusca, per aver passato un semaforo rosso. Con molti tentativi impara un comportamento che massimizza la ricompensa totale. Due conseguenze contano qui:
- la politica sperimenta i risultati dei propri errori, quindi impara a rimediare;
- può, in linea di principio, diventare migliore dei conducenti dei dati, perché ottimizza un obiettivo invece di copiare una media.
Il problema ovvio: non si può lasciare che un’auto impari andando a sbattere su strade vere. L’RL ha bisogno di un ambiente in cui milioni di tentativi siano economici e innocui. Quell’ambiente è un simulatore, ed è qui che entrano i modelli del mondo.
Modelli del mondo: un simulatore appreso dai video
I simulatori tradizionali sono costruiti come videogiochi: strade, auto e pedoni modellati a mano. Sono utili, ma lo scarto con le vere immagini delle telecamere è grande. Un modello del mondo prende un’altra strada: una rete generativa, addestrata su enormi quantità di video reali di guida, che prevede cosa vedranno le telecamere subito dopo, dato ciò che hanno visto finora e ciò che l’auto decide di fare. Se nella simulazione si sterza a sinistra, le immagini generate mostrano l’auto che si sposta a sinistra, con gli altri utenti della strada che reagiscono.
XPeng ha pubblicato nell’aprile 2026 un rapporto tecnico sul suo modello del mondo, X-World (XPeng). È un modello di diffusione video che genera la vista di sette telecamere insieme, condizionato dalle azioni pianificate dell’auto, dagli altri partecipanti al traffico e dalla disposizione della strada. XPeng dice di usarlo in tre modi: per valutare in anello chiuso il suo modello di guida VLA 2.0 (tasso di collisioni, avanzamento, comfort), come ambiente per l’apprendimento per rinforzo online su casi difficili come pedoni che escono agli incroci o esitazioni nei cambi di corsia in coda, e per generare scenari rari che mancano nei dati reali. L’azienda riferisce di essere passata da circa 30.000 scenari simulati a più di 500.000, con una simulazione giornaliera equivalente a 30 milioni di km di guida.
Li Auto descrive una pipeline simile per il suo modello MindVLA: un modello del mondo nel cloud che combina la ricostruzione 3D di scene reali con il completamento generativo delle viste, usato per l’RL in anello chiuso su larga scala dopo che il modello è stato preaddestrato e rifinito su guida reale (Gasgoo). La parte di ricostruzione si affida spesso al 3D Gaussian splatting, una tecnica che trasforma i percorsi registrati in scene che si possono ridisegnare da nuovi punti di vista. Un articolo di Horizon Robotics e di ricercatori universitari, RAD, ha mostrato nel 2025 che una politica di guida addestrata con l’RL in questo tipo di ambiente ricostruito aveva un tasso di collisioni molto più basso della stessa politica addestrata solo per imitazione.
Cosa dicono gli altri attori
- Momenta chiama «flywheel» il suo modello attuale R6 e lo presenta come basato sull’apprendimento per rinforzo; è in produzione su modelli di GAC Toyota, Chery e Buick, tra gli altri (Wikipedia).
- BYD ha lanciato God’s Eye 5.0 nel gennaio 2026 puntando sull’apprendimento per rinforzo e sul controllo end to end in anello chiuso, e dice che la sua flotta raccoglie più di 160 milioni di km di dati di guida assistita al giorno (CarNewsChina).
- Huawei usa un modello del mondo come terreno di addestramento per il suo ADS 4, ma ha criticato apertamente l’approccio VLA di XPeng e Li Auto, preferendo un modello di «azione del mondo» senza il passaggio linguistico (ChinaEVHome).
VLA sta per visione, linguaggio, azione: un modello costruito su un grande modello linguistico, che può ragionare sulla scena a parole («l’autobus si sta fermando, i passeggeri potrebbero attraversare») prima di produrre la traiettoria. I sostenitori dicono che questo aiuta con le situazioni insolite e rende il sistema più facile da ispezionare. I critici, Huawei per prima, dicono che il passaggio linguistico aggiunge latenza e costo di calcolo senza far guidare meglio l’auto. Entrambi i campi concordano su una cosa: il miglioramento finale viene dall’addestramento in anello chiuso, non da altra imitazione.
La parte difficile è la ricompensa
Chiunque abbia provato l’RL su un problema giocattolo conosce il punto debole. La politica ottimizza esattamente ciò che si ricompensa, non ciò che si intendeva. Se si ricompensa solo l’avanzamento, impara a tagliare la strada in modo aggressivo; se si punisce ogni frenata, diventa spericolata; se si puniscono troppo le collisioni, può decidere che la mossa più sicura è non lasciare mai il posteggio. I sistemi reali combinano molti termini (sicurezza, rispetto delle regole, comfort, avanzamento) e spesso mantengono la perdita di imitazione come àncora, così che la politica resti vicina allo stile umano mentre migliora sui casi rari.
L’altro rischio è il simulatore stesso. Se il modello del mondo ha un punto cieco, per esempio non genera mai un ciclista che passa col rosso, la politica può imparare a sfruttare quella lacuna. Per questo le aziende insistono sulla convalida su strade vere e per questo le nuove norme cinesi chiedono ai produttori di documentare insieme simulazione, prove in pista e prove su strada.
Perché conta anche fuori dalla Cina
La combinazione è nuova: milioni di auto di serie che raccolgono dati, modelli generativi del mondo che trasformano quei dati in un simulatore interattivo, e l’addestramento RL al suo interno. Le aziende cinesi si muovono più in fretta della maggior parte perché hanno la flotta, la pressione del mercato e un’autorità di regolazione che, pur severa sul marketing, permette un’ampia diffusione dei sistemi di Livello 2. Volkswagen ha già scelto il VLA 2.0 di XPeng per i propri modelli, con consegne previste dal 2027 (XPeng). È probabile che i metodi di addestramento qui descritti arrivino sulle strade europee prima di quanto molti si aspettassero.




Hi, I am the author of “From imitation to reinforcement learning: how Chinese driving systems are trained”. Questions, doubts, error reports and requests for more detail are all welcome: write them below and I will answer. You can also rate the page with the stars at the top of the article.