Apprendimento per imitazione: behaviour cloning, accumulo degli errori, DAgger e inverse RL
Imparare dalle dimostrazioni: behaviour cloning, il teorema dell'accumulo degli errori, DAgger, esperimenti su CartPole con 10 semi, inverse RL, GAIL, imitazione e rinforzo in AlphaGo, nei modelli linguistici e nella robotica.
Definire una ricompensa che descriva bene un compito è spesso più difficile del compito stesso: come si scrive in un numero “guida come una persona esperta”, o “piega la maglietta per bene”? Molto più facile è mostrare come si fa. L’apprendimento per imitazione (imitation learning) impara una policy da dimostrazioni di un esperto: un pilota, un operatore che guida il robot a distanza, un programma già bravo. È la base dei primi sistemi di guida autonoma, di molti robot manipolatori e anche della prima fase di addestramento dei modelli linguistici. Questa lezione presenta il behaviour cloning, dimostra perché i suoi errori si accumulano, presenta DAgger che risolve il problema, e accenna all’apprendimento inverso della ricompensa. Gli esperimenti su CartPole mostrano tutto con i numeri.
Behaviour cloning
L’idea più semplice: si raccolgono coppie (stato, azione dell’esperto) e si addestra una rete a prevedere l’azione dallo stato, come in un problema di classificazione (azioni discrete) o di regressione (azioni continue). Nessuna ricompensa, nessuna esplorazione: è apprendimento supervisionato. Nel 1989 ALVINN guidava un furgone imparando l’angolo di sterzo dalle immagini di una telecamera e dalle manovre di un guidatore; nel 2016 NVIDIA fece lo stesso con una rete convoluzionale (PilotNet).
Perché gli errori si accumulano
Il behaviour cloning ha un difetto profondo: la rete è addestrata sugli stati visitati dall’esperto, ma viene usata sugli stati visitati da se stessa. Basta un piccolo errore per portare l’agente in uno stato un po’ diverso da quelli visti; lì la rete sbaglia di più, e lo stato si allontana ancora. Gli errori si compongono.
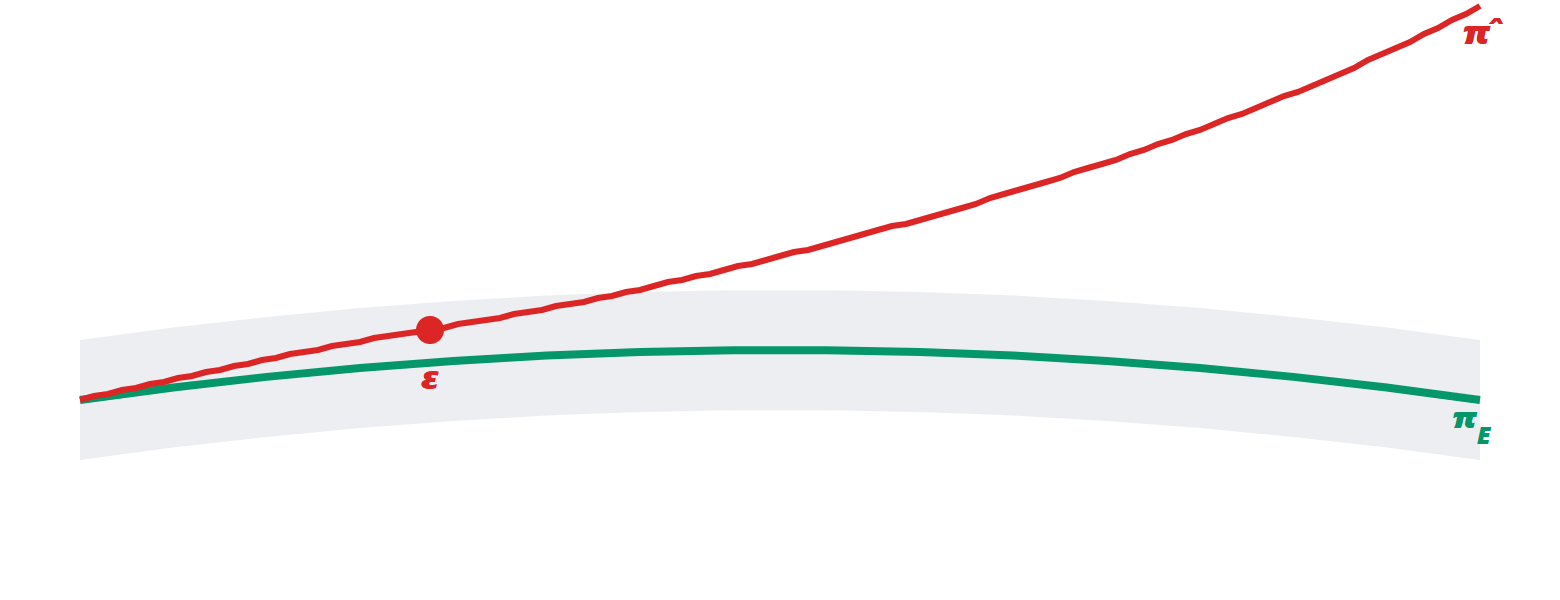
Teorema (Ross e Bagnell, 2010). Se la policy clonata sbaglia azione con probabilità al più  sugli stati dell’esperto, e un errore può portare fuori dalla distribuzione dell’esperto per il resto dell’episodio, il costo atteso su un orizzonte di
 passi può crescere come
 , invece che come
 .
Idea della dimostrazione. Finché l’agente non ha ancora sbagliato, si trova negli stati dell’esperto e sbaglia con probabilità per passo. La probabilità di aver già sbagliato entro il passo  è circa
 (per piccolo), e dopo il primo errore, nel caso peggiore, si paga un costo a ogni passo successivo. Il costo atteso è quindi
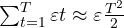 . Se invece la policy fosse addestrata sugli stati che lei stessa visita, l’errore per passo resterebbe e il costo . ∎
DAgger: chiedere all’esperto dove si è sbagliato
DAgger (Dataset Aggregation, Ross, Gordon e Bagnell, 2011) cura il problema alla radice: si fa guidare la policy appresa, si registrano gli stati che visita, si chiede all’esperto quale azione avrebbe scelto in quegli stati, si aggiungono le nuove coppie ai dati e si riaddestra. Ripetendo, i dati coprono proprio gli stati in cui l’agente finisce, compresi quelli in cui ha bisogno di “recuperare”. Il teorema di DAgger garantisce un costo che cresce come . Il prezzo: l’esperto deve essere disponibile durante l’addestramento (un programma, un simulatore con un controllore ottimo, o una persona che corregge a posteriori).
Gli esperimenti su CartPole
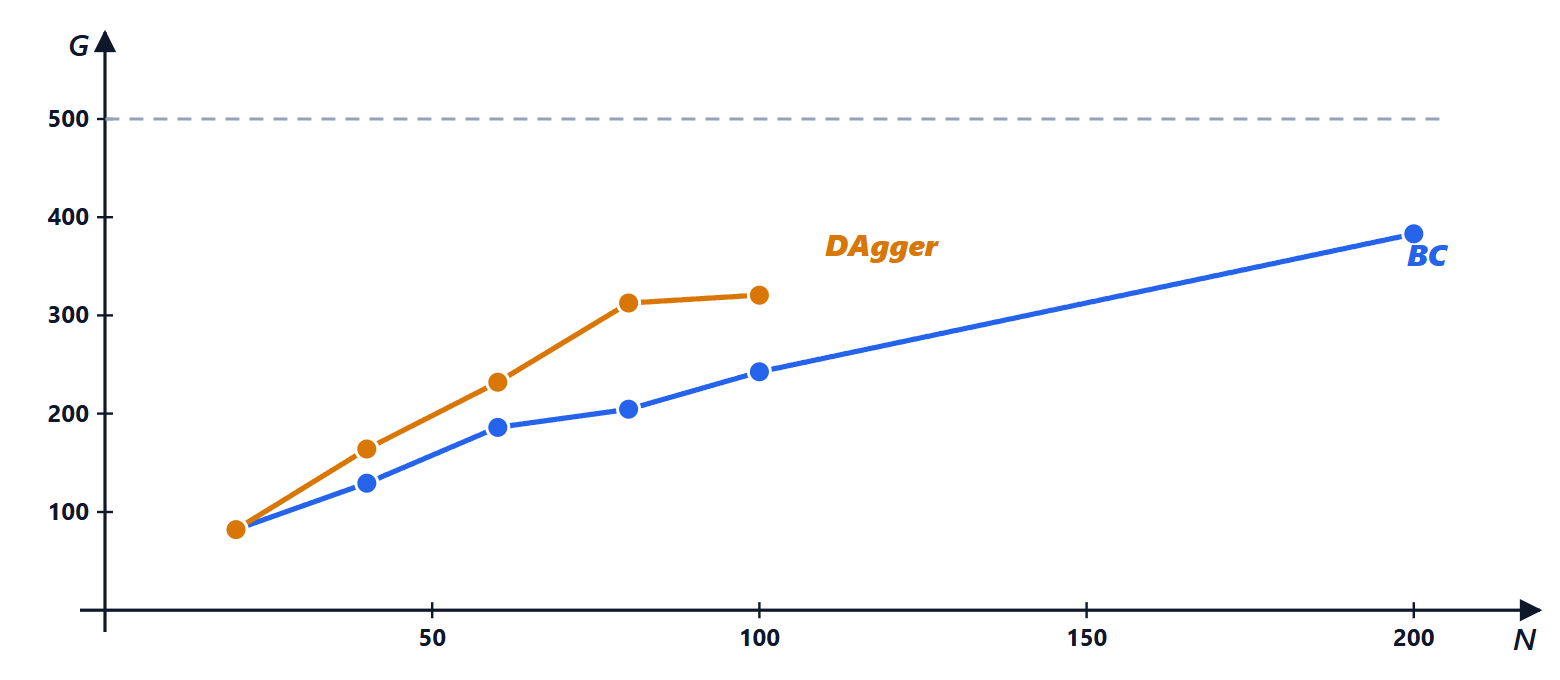
L’esperto è il PPO della lezione precedente, che tiene il palo in piedi per tutti i 500 passi. La policy imitata è una rete piccola (uno strato nascosto di 32 neuroni), addestrata a classificare l’azione e valutata su 20 episodi. Con così pochi dati il risultato dipende molto dal caso (quali stati capitano nelle dimostrazioni, come parte la rete), quindi ogni configurazione è ripetuta con 10 semi casuali e si riportano media e deviazione standard.
| passi di dati | behaviour cloning | DAgger |
|---|---|---|
| 20 | 82 ± 23 | 82 ± 23 (punto di partenza) |
| 40 | 129 ± 103 | 164 ± 127 |
| 60 | 186 ± 140 | 232 ± 103 |
| 80 | 205 ± 121 | 313 ± 105 |
| 100 | 243 ± 146 | 321 ± 110 |
| 200 | 383 ± 130 |
A parità di dati DAgger è sempre migliore, e con 80-100 passi ottiene quello che al behaviour cloning ne richiede circa il doppio. Il motivo è quello del teorema: le dimostrazioni dell’esperto mostrano quasi solo il palo vicino alla verticale, mentre DAgger aggiunge proprio gli stati “sbagliati” in cui finisce l’agente, con l’azione giusta per recuperare. Le deviazioni standard sono grandi: con un seme fortunato anche il behaviour cloning può arrivare a 500, con uno sfortunato restare sotto 100. È un avvertimento generale: in RL e in imitazione un solo esperimento non dimostra niente.
import numpy as np
import torch, torch.nn as nn
import gymnasium

esperto = nn.Sequential(nn.Linear(4, 64), nn.Tanh(), nn.Linear(64, 64), nn.Tanh(), nn.Linear(64, 2))
esperto.load_state_dict(torch.load("esperto.pt"))             # salvato dal codice della lezione sul PPO
azione_esperto = lambda s: int(esperto(torch.tensor(s, dtype=torch.float32)).argmax())

def valuta(policy, episodi=20):
    env, punti = gymnasium.make("CartPole-v1"), []
    for e in range(episodi):
        o, _ = env.reset(seed=1000 + e)
        tot, fine = 0.0, False
        while not fine:
            o, r, te, tr, _ = env.step(policy(o))
            tot += r; fine = te or tr
        punti.append(tot)
    return float(np.mean(punti))

def raccogli(policy, passi, seme):
    """Stati visitati seguendo policy, etichettati con l'azione dell'esperto."""
    env, S, Y = gymnasium.make("CartPole-v1"), [], []
    o, _ = env.reset(seed=seme)
    for _ in range(passi):
        S.append(o); Y.append(azione_esperto(o))
        o, _, te, tr, _ = env.step(policy(o))
        if te or tr:
            o, _ = env.reset()
    return S, Y

def addestra(S, Y, seme):
    torch.manual_seed(seme)
    rete = nn.Sequential(nn.Linear(4, 32), nn.Tanh(), nn.Linear(32, 2))
    opt = torch.optim.Adam(rete.parameters(), lr=1e-2)
    X, T = torch.tensor(np.array(S), dtype=torch.float32), torch.tensor(Y)
    for _ in range(300):                                       # classificazione dell'azione
        perdita = nn.functional.cross_entropy(rete(X), T)
        opt.zero_grad(); perdita.backward(); opt.step()
    return lambda s: int(rete(torch.tensor(s, dtype=torch.float32)).argmax())

print("esperto:", valuta(azione_esperto))
bc = {n: [] for n in (20, 40, 60, 80, 100, 200)}
dag = {n: [] for n in (20, 40, 60, 80, 100)}
for seme in range(10):
    for n in bc:                                               # behaviour cloning con n passi
        bc[n].append(valuta(addestra(*raccogli(azione_esperto, n, 100 * seme), seme)))
    S, Y = raccogli(azione_esperto, 20, 100 * seme)            # DAgger: si parte da 20 passi
    policy = addestra(S, Y, seme)
    dag[20].append(valuta(policy))
    for it in range(1, 5):
        S2, Y2 = raccogli(policy, 20, 100 * seme + it)         # stati visitati dalla policy appresa
        S += S2; Y += Y2
        policy = addestra(S, Y, seme)
        dag[20 * (it + 1)].append(valuta(policy))
for n in bc:
    riga = f"{n:4d} passi: behaviour cloning {np.mean(bc[n]):6.1f} ± {np.std(bc[n]):5.1f}"
    if n in dag:
        riga += f", DAgger {np.mean(dag[n]):6.1f} ± {np.std(dag[n]):5.1f}"
    print(riga)
Oltre l’imitazione diretta
- Apprendimento inverso della ricompensa (inverse RL): invece di copiare le azioni, si cerca la ricompensa che l’esperto sembra massimizzare, poi la si ottimizza con l’RL. È più robusto fuori dalle dimostrazioni, perché la ricompensa vale anche negli stati mai visti.
- GAIL (generative adversarial imitation learning, 2016): un discriminatore impara a distinguere le traiettorie dell’esperto da quelle dell’agente, e l’agente viene addestrato con l’RL a “ingannarlo”, come nelle reti generative avversarie.
- Imitazione e poi rinforzo: nella pratica si parte spesso dal behaviour cloning (rapido, stabile) e si migliora con l’RL. È lo schema di AlphaGo (prima le partite dei maestri, poi il gioco contro se stesso) e dei modelli linguistici (prima l’addestramento supervisionato su risposte scritte da persone, poi l’RL con il feedback umano).
- Robotica moderna: le policy a diffusione e i modelli visione-linguaggio-azione imparano da migliaia di dimostrazioni teleoperate; il problema dell’accumulo degli errori si mitiga prevedendo blocchi di azioni future invece di una sola.