Le equazioni di Bellman dimostrate: contrazione, iterazione dei valori e della policy
Equazione di Bellman per una policy e di ottimalità, l'operatore di Bellman è una contrazione (con dimostrazione), esistenza e unicità del valore ottimo, teorema di miglioramento della policy, codice Python sul gridworld.
Le equazioni di Bellman sono il cuore matematico dell’apprendimento per rinforzo: trasformano la definizione del valore, una media su infiniti futuri possibili, in un’equazione che lega il valore di uno stato a quello degli stati successivi. Da esse nascono tutti gli algoritmi, da quelli esatti (iterazione dei valori e della policy) a quelli che imparano dall’esperienza (Q-learning, DQN, actor-critic). Questa lezione le ricava, dimostra che hanno una e una sola soluzione e che gli algoritmi convergono, e le applica al gridworld della lezione precedente con il codice Python.
L’equazione di Bellman per una policy
Teorema. Per ogni policy  e ogni stato
 :
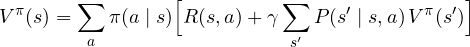
Dimostrazione. Si parte dalla relazione ricorsiva del ritorno, 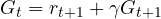 , e si prende la media condizionata a
 :
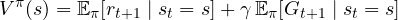
Il primo termine è la ricompensa media: si sceglie  con probabilità
 e si riceve in media
 . Nel secondo si condiziona anche sullo stato successivo: per la proprietà di Markov, una volta noto
 , il futuro non dipende da come ci si è arrivati, quindi
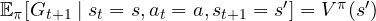 . Pesando con le probabilità
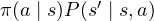 si ottiene l’equazione. ∎
È un sistema lineare di  equazioni in incognite: in forma vettoriale
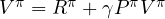 , con soluzione
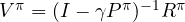 (la matrice è invertibile per
 , perché
 ha norma minore di 1). Per il gridworld con la policy casuale si ottengono i valori −14, −20, −22 della lezione precedente.
L’equazione di ottimalità
Per la policy ottima la media sulle azioni diventa un massimo:
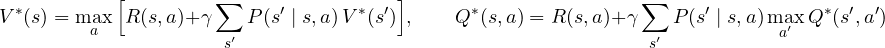
Non è più lineare (per il massimo), quindi non si risolve invertendo una matrice: si risolve per iterazione. Il risultato che lo rende possibile è il seguente.
La contrazione di Bellman
Si definisce l’operatore di Bellman ottimo  , che trasforma una funzione
 in un’altra:
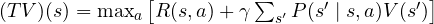 . L’equazione di ottimalità dice che
 è un punto fisso:
 .
Teorema. è una contrazione di fattore  nella norma del massimo: per ogni
 ,
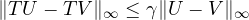 .
Dimostrazione. Si usa una disuguaglianza elementare: per due funzioni  di ,
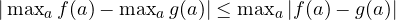 (se il massimo di
 è in
 ,
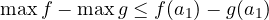 , e simmetricamente). Allora, per ogni :
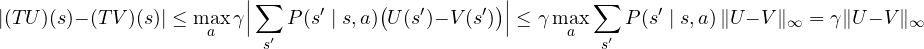
perché le probabilità  sommano a 1. ∎
Conseguenze (teorema del punto fisso di Banach):
- il punto fisso esiste ed è unico: è ben definito;
- partendo da qualunque
 , la successione
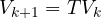 converge a , e l’errore si riduce almeno del fattore a ogni passo:
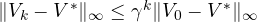 .
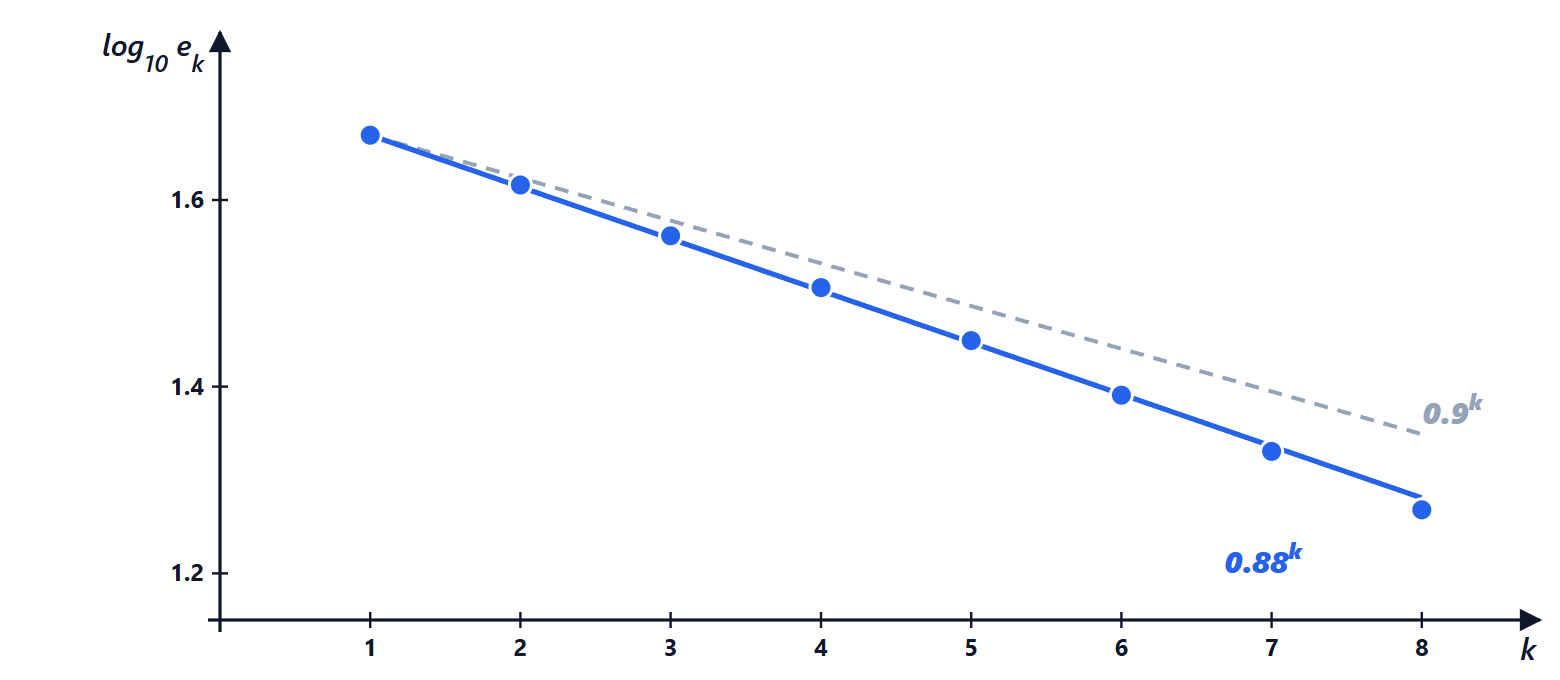
È l’iterazione dei valori. Sul gridworld con  e una stima iniziale volutamente sbagliata (50 in ogni casella) l’errore massimo scende da 46,7 a 41,3, 36,5, 32,1, …: rapporti tra 0,87 e 0,88, sempre sotto 0,9 come garantito dal teorema.
Il miglioramento della policy
Teorema (miglioramento della policy). Data una policy , sia  la policy greedy rispetto a
 :
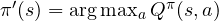 . Allora
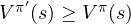 per ogni .
Dimostrazione. Per costruzione 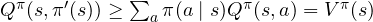 . Si espande
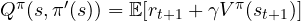 facendo al primo passo, e si applica la stessa disuguaglianza a
 :
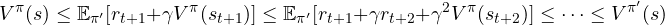
ripetendo all’infinito (i termini residui  tendono a zero). ∎
Alternando valutazione (calcolare  con l’equazione lineare) e miglioramento (rendere la policy greedy) si ottiene l’iterazione della policy: ogni passo migliora o lascia uguale la policy, le policy deterministiche sono in numero finito, quindi in un numero finito di passi si arriva a una policy che non migliora più, cioè che soddisfa l’equazione di ottimalità. Questo dimostra anche che una policy ottima deterministica esiste sempre. Lo schema “valuta, poi migliora” ritorna in tutti gli algoritmi moderni: in actor-critic il critico valuta e l’attore migliora.
Il codice
import numpy as np

N = 4                                         # gridworld 4x4, uscite in 0 e 15, -1 a ogni passo
MOSSE = [(-1, 0), (1, 0), (0, -1), (0, 1)]    # su, giù, sinistra, destra
USCITE = {0, 15}

def passo(s, a):
    if s in USCITE:
        return s, 0.0
    r, c = divmod(s, N)
    r = min(max(r + MOSSE[a][0], 0), N - 1)
    c = min(max(c + MOSSE[a][1], 0), N - 1)
    return r * N + c, -1.0

def bellman_ottimo(V, gamma):
    """Operatore di Bellman ottimo T: (TV)(s) = max_a [ r + gamma V(s') ]."""
    return np.array([0.0 if s in USCITE else
                     max(r + gamma * V[s2] for s2, r in (passo(s, a) for a in range(4)))
                     for s in range(N * N)])

# iterazione dei valori con gamma = 1
V = np.zeros(N * N)
for k in range(100):
    V_nuovo = bellman_ottimo(V, 1.0)
    if np.max(abs(V_nuovo - V)) < 1e-10:
        break
    V = V_nuovo
print("V* dopo", k, "passate:\n", V.reshape(N, N))

# valutazione della policy casuale: media sulle quattro azioni invece del massimo
Vc = np.zeros(N * N)
for _ in range(5000):
    Vc = np.array([0.0 if s in USCITE else
                   np.mean([r + Vc[s2] for s2, r in (passo(s, a) for a in range(4))])
                   for s in range(N * N)])
print("policy casuale:\n", np.round(Vc.reshape(N, N), 1))

# policy greedy rispetto a V*: la freccia migliore in ogni casella
FRECCE = "↑↓←→"
pol = [" " if s in USCITE else FRECCE[int(np.argmax([r + V[s2] for s2, r in (passo(s, a) for a in range(4))]))]
       for s in range(N * N)]
print("\n".join(" ".join(pol[i * N:(i + 1) * N]) for i in range(N)))

# contrazione: con gamma = 0,9 l'errore si riduce almeno di 0,9 a ogni passata
Vs = np.zeros(N * N)
for _ in range(200):
    Vs = bellman_ottimo(Vs, 0.9)
U = np.where(np.isin(np.arange(N * N), list(USCITE)), 0.0, 50.0)
errori = []
for _ in range(6):
    U = bellman_ottimo(U, 0.9)
    errori.append(np.max(abs(U - Vs)))
print("errori:", np.round(errori, 2), "rapporti:", np.round(np.array(errori[1:]) / np.array(errori[:-1]), 3))
L’esecuzione stampa dopo 3 passate più quella di verifica (i valori 0, −1, −2, −3), i valori della policy casuale (−14, −18, −20, −22), la griglia delle frecce verso l’uscita più vicina e gli errori 46,71, 41,31, 36,45, … con rapporti 0,884, 0,882, 0,880, … Su problemi grandi la tabella  non entra in memoria e
 non è noto: le lezioni successive sostituiscono la somma su
 con l’esperienza (Q-learning) e la tabella con una rete neurale (DQN).