Gradiente della policy e PPO: REINFORCE, baseline, actor-critic, GAE e obiettivo ritagliato
Il teorema del gradiente della policy dimostrato, REINFORCE, la baseline che non introduce distorsione, actor-critic, il vantaggio generalizzato GAE, l'obiettivo ritagliato del PPO, codice su CartPole con ambienti vettorizzati.
Il DQN impara i valori e ne ricava la policy. Si può anche fare il contrario: parametrizzare direttamente la policy  con una rete neurale e spostarne i pesi nella direzione che aumenta il ritorno medio. Sono i metodi a gradiente della policy. Funzionano con azioni continue (coppie, sterzo, accelerazione), imparano policy stocastiche e sono la base del PPO (Proximal Policy Optimization, Schulman e altri, 2017), l’algoritmo più usato oggi: dai robot che camminano ai modelli linguistici addestrati con il feedback umano. Questa lezione dimostra il teorema del gradiente della policy, ricava REINFORCE, la baseline e l’actor-critic, spiega il vantaggio generalizzato (GAE) e l’obiettivo “ritagliato” del PPO, e lo applica a CartPole.
Il teorema del gradiente della policy
L’obiettivo è il ritorno medio 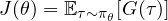 , dove
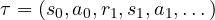 è una traiettoria e
 il suo ritorno.
Teorema. 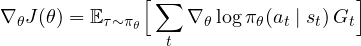 , con
 il ritorno da
 in poi.
Dimostrazione. La probabilità di una traiettoria è 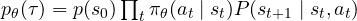 . Si usa il trucco della derivata logaritmica,
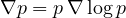 :
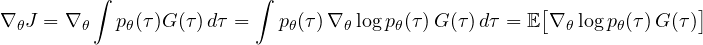
Nel logaritmo il prodotto diventa una somma, e i termini  e
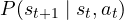 non dipendono da
 : spariscono derivando. Resta
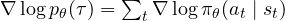 . Infine le ricompense ricevute prima di non dipendono da
 , e il loro contributo ha media nulla (per lo stesso argomento della baseline qui sotto): si può sostituire con . ∎
Il risultato è notevole: per migliorare la policy non serve il modello dell’ambiente, basta poter derivare la propria policy. L’interpretazione è intuitiva: aumenta la probabilità delle azioni seguite da un ritorno alto, diminuisci quella delle azioni seguite da un ritorno basso. Stimando la media con le traiettorie giocate si ottiene l’algoritmo REINFORCE (Williams, 1992).
La baseline e l’actor-critic
REINFORCE è corretto ma lentissimo: ha una varianza enorme. Si può sottrarre una baseline  senza cambiare la media.
Lemma.  .
Dimostrazione. 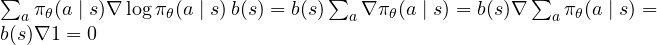 . ∎
La scelta naturale è  : al posto di si usa il vantaggio
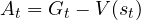 , che dice di quanto l’azione è andata meglio del previsto.
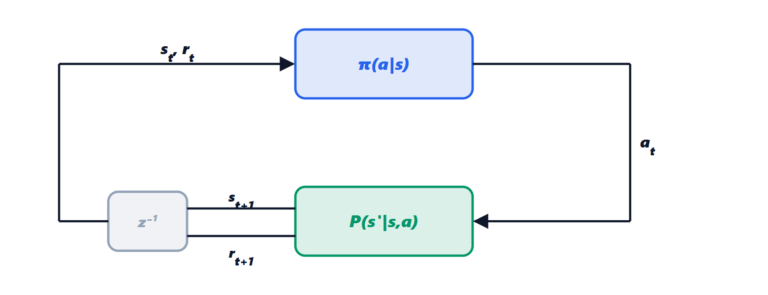
 si impara con una seconda rete, il critico, mentre la policy è l’attore: è lo schema actor-critic, la versione “valuta e migliora” dell’iterazione della policy.
Il vantaggio generalizzato (GAE). Come tra Monte Carlo e TD, si può stimare il vantaggio con l’errore TD 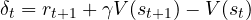 (poca varianza, distorto) o con il ritorno intero (non distorto, molta varianza). Il GAE (Schulman, 2016) ne fa una media esponenziale:
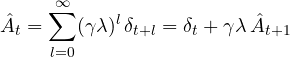
con  si ha l’errore TD, con
 il ritorno Monte Carlo meno ; di solito
 . La forma ricorsiva si calcola all’indietro in una riga di codice.
Il PPO: passi grandi ma non troppo
Un passo di gradiente troppo lungo può cambiare la policy così tanto da rovinarla, e i dati raccolti con la vecchia policy non valgono più. Il PPO usa il rapporto delle probabilità 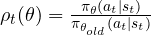 tra la policy nuova e quella che ha raccolto i dati, e massimizza l’obiettivo ritagliato:
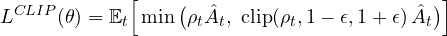
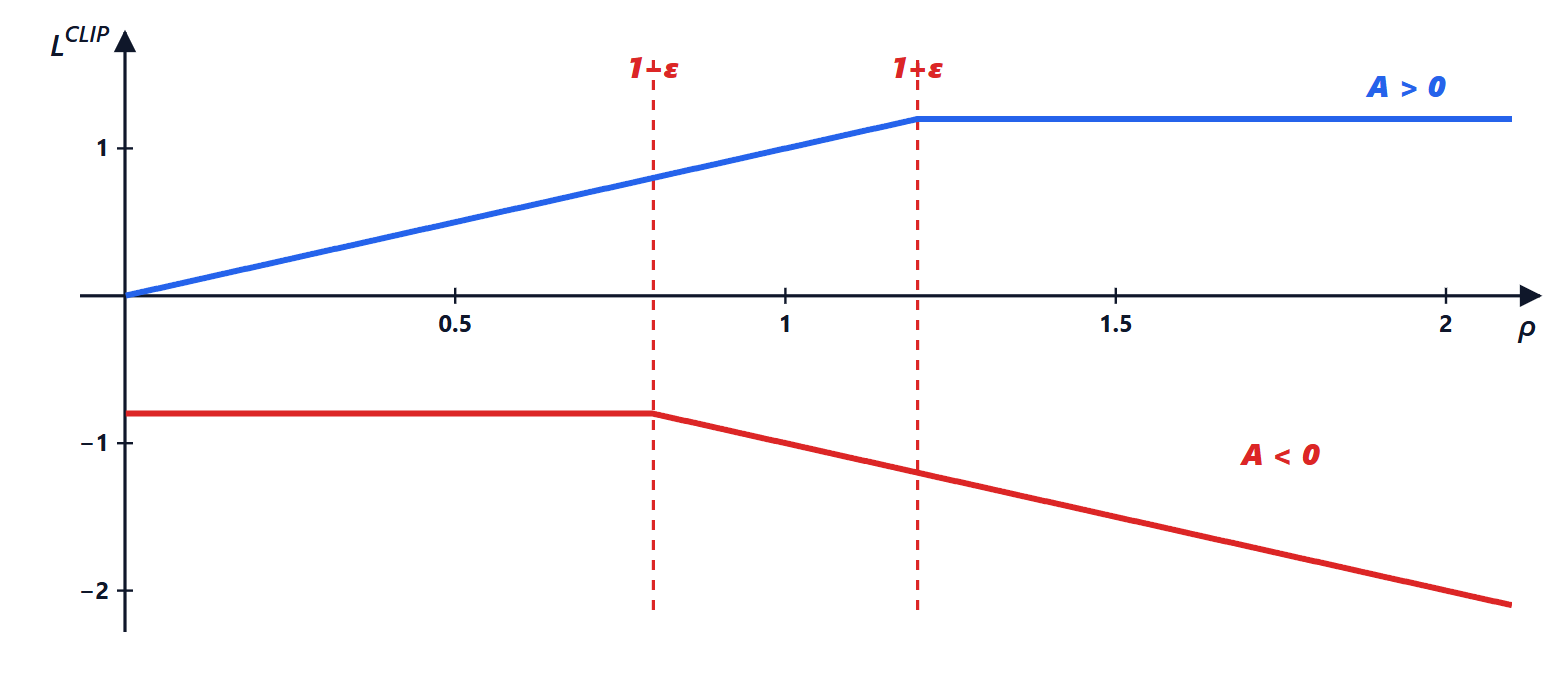
con  . Se un’azione era buona (
 ) se ne aumenta la probabilità, ma oltre il 20 % in più l’obiettivo diventa piatto e il gradiente si annulla; se era cattiva (
 ) se ne riduce la probabilità, ma non sotto il 20 % in meno. Il minimo garantisce che il ritaglio agisca solo quando migliorerebbe l’obiettivo, mai quando lo peggiora: è un limite pessimistico al guadagno. Così si possono fare più passi (epoche) sugli stessi dati in sicurezza. All’obiettivo si aggiungono l’errore del critico e un piccolo premio all’entropia, che mantiene l’esplorazione.
Il PPO su CartPole
Il codice raccoglie 128 passi da 8 ambienti in parallelo (1024 transizioni), calcola il GAE, fa 4 epoche di aggiornamento con l’obiettivo ritagliato e ripete 100 volte. Gli ambienti sono vettorizzati con PufferLib, presentato nella lezione sulle librerie; con Gymnasium (gymnasium.vector.SyncVectorEnv) il codice sarebbe quasi identico.
import numpy as np
import torch, torch.nn as nn
import gymnasium
import pufferlib.emulation, pufferlib.vector

N_ENV, T, AGGIORNAMENTI = 8, 128, 100            # 8 ambienti, 128 passi ciascuno per aggiornamento
GAMMA, LAM, CLIP, LR, EPOCHE = 0.99, 0.95, 0.2, 1e-3, 4
torch.manual_seed(0)

def crea(buf=None, seed=0):
    return pufferlib.emulation.GymnasiumPufferEnv(env=gymnasium.make("CartPole-v1"), buf=buf, seed=seed)
envs = pufferlib.vector.make(crea, num_envs=N_ENV, backend=pufferlib.vector.Serial)
obs, _ = envs.reset(seed=0)

attore = nn.Sequential(nn.Linear(4, 64), nn.Tanh(), nn.Linear(64, 64), nn.Tanh(), nn.Linear(64, 2))
critico = nn.Sequential(nn.Linear(4, 64), nn.Tanh(), nn.Linear(64, 1))
parametri = list(attore.parameters()) + list(critico.parameters())
opt = torch.optim.Adam(parametri, lr=LR)

for k in range(AGGIORNAMENTI):
    for g in opt.param_groups:
        g["lr"] = LR * (1 - k / AGGIORNAMENTI)          # passo che scende linearmente a zero
    O, A, LP, R, D, V = [], [], [], [], [], []
    for t in range(T):                                  # raccolta dei dati con la policy attuale
        o = torch.tensor(obs, dtype=torch.float32)      # copia: PufferLib riusa lo stesso buffer
        with torch.no_grad():
            dist = torch.distributions.Categorical(logits=attore(o))
            a = dist.sample()
            O.append(o); A.append(a); LP.append(dist.log_prob(a)); V.append(critico(o).squeeze(-1))
        obs, r, term, trunc, _ = envs.step(a.numpy())
        R.append(torch.tensor(r, dtype=torch.float32))
        D.append(torch.tensor(np.logical_or(term, trunc), dtype=torch.float32))
    with torch.no_grad():
        v_fine = critico(torch.tensor(obs, dtype=torch.float32)).squeeze(-1)
    vant, ultimo = torch.zeros(T, N_ENV), torch.zeros(N_ENV)
    for t in reversed(range(T)):                        # GAE, calcolato all'indietro
        v_dopo = v_fine if t == T - 1 else V[t + 1]
        delta = R[t] + GAMMA * v_dopo * (1 - D[t]) - V[t]
        ultimo = delta + GAMMA * LAM * (1 - D[t]) * ultimo
        vant[t] = ultimo
    ritorni = (vant + torch.stack(V)).reshape(-1)
    O, A, LP = torch.stack(O).reshape(-1, 4), torch.stack(A).reshape(-1), torch.stack(LP).reshape(-1)
    vant = vant.reshape(-1)
    vant = (vant - vant.mean()) / (vant.std() + 1e-8)
    for _ in range(EPOCHE):                             # obiettivo ritagliato del PPO
        dist = torch.distributions.Categorical(logits=attore(O))
        rapporto = torch.exp(dist.log_prob(A) - LP)
        perdita_pi = -torch.min(rapporto * vant, torch.clamp(rapporto, 1 - CLIP, 1 + CLIP) * vant).mean()
        perdita_v = ((critico(O).squeeze(-1) - ritorni) ** 2).mean()
        perdita = perdita_pi + 0.5 * perdita_v - 0.01 * dist.entropy().mean()
        opt.zero_grad(); perdita.backward()
        nn.utils.clip_grad_norm_(parametri, 0.5)
        opt.step()
envs.close()

env, punti = gymnasium.make("CartPole-v1"), []
for e in range(10):                                     # valutazione con l'azione più probabile
    o, _ = env.reset(seed=100 + e)
    tot, fine = 0.0, False
    while not fine:
        with torch.no_grad():
            o, r, te, tr, _ = env.step(int(attore(torch.tensor(o, dtype=torch.float32)).argmax()))
        tot += r; fine = te or tr
    punti.append(tot)
print("valutazione su 10 episodi:", np.mean(punti))
torch.save(attore.state_dict(), "esperto.pt")           # servirà come esperto da imitare
In meno di 10 secondi su un processore (circa 100 000 passi) il ritorno medio degli ultimi 20 episodi durante l’addestramento passa da 162 dopo 20 aggiornamenti a 245, 201, 401 e 407 (durante l’addestramento le azioni sono ancora casuali), e la valutazione con l’azione più probabile dà 500 su tutti e 10 gli episodi. Due accorgimenti sono stati decisivi nelle prove: il passo di apprendimento che scende a zero e il limite alla norma del gradiente (0,5); senza, la policy raggiungeva 400 e poi peggiorava. È un comportamento tipico dell’RL: i risultati cambiano molto con gli iperparametri e con il seme casuale, e per confrontare due metodi si usano sempre più semi. Una semplificazione: il codice tratta come finale anche il tempo scaduto (500 passi), che a rigore richiederebbe di continuare il bootstrap; per CartPole l’effetto è piccolo.
Perché il PPO è ovunque
È semplice (poche righe oltre l’actor-critic), robusto agli iperparametri più di molti concorrenti, funziona con azioni discrete e continue e si parallelizza bene su migliaia di ambienti simulati. È l’algoritmo con cui OpenAI addestrò la mano robotica a risolvere il cubo di Rubik e i bot di Dota 2, e quello usato nel 2022 per InstructGPT, il modello linguistico che rese famoso l’addestramento con il feedback umano (RLHF), come si vede nella lezione sulle applicazioni.