Processi decisionali di Markov: agente, ambiente, ritorno, policy e funzioni valore
Il linguaggio dell'apprendimento per rinforzo: il ciclo agente-ambiente, la proprietà di Markov, ritorno e sconto, policy, valore dello stato e dell'azione, vantaggio, il gridworld con policy casuale e ottima.
https://www.electronics-engineering.com/processi-decisionali-di-markov-ritorno-policy-funzioni-valore
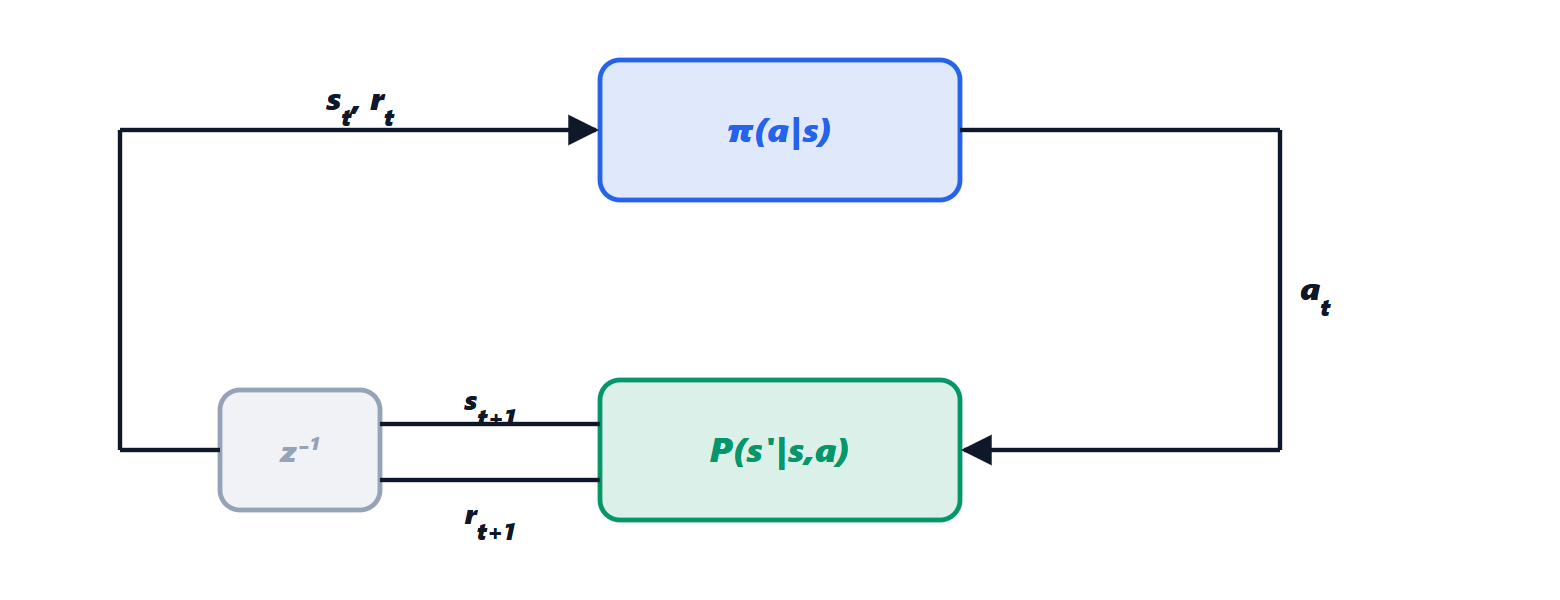
Nell’apprendimento supervisionato qualcuno fornisce la risposta giusta per ogni esempio. Nell’apprendimento per rinforzo (reinforcement learning, RL) nessuno la conosce: un agente prova delle azioni in un ambiente, riceve una ricompensa numerica e deve imparare da solo quale comportamento la rende massima nel lungo periodo. È il modo in cui si addestrano programmi che giocano meglio dei campioni (AlphaGo), robot che camminano, controllori di traffico, e la fase finale dei grandi modelli linguistici (RLHF). Questa prima lezione definisce il linguaggio matematico di tutto il corso: il processo decisionale di Markov, il ritorno, la policy e le funzioni valore.
L’agente e l’ambiente
A ogni istante 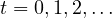 l’agente osserva lo stato
 , sceglie un’azione
 , e l’ambiente risponde con una ricompensa
 e un nuovo stato
 . Il ciclo si ripete. Per un robot lo stato sono le posizioni e velocità dei giunti, l’azione le coppie dei motori, la ricompensa un numero che premia l’avanzare senza cadere. Per CartPole, l’esempio che useremo spesso, lo stato sono posizione e velocità del carrello, angolo e velocità angolare del palo, l’azione è spingere a sinistra o a destra, la ricompensa è +1 per ogni passo in cui il palo resta in piedi.
Il processo decisionale di Markov
Un MDP (Markov decision process) è la quintupla 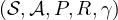 :
 l’insieme degli stati,
 quello delle azioni;
 la probabilità di passare in
 facendo
 in
 ;
 la ricompensa media ottenuta facendo in ;
 il fattore di sconto.
La parola Markov indica l’ipotesi fondamentale: il futuro dipende dal passato solo attraverso lo stato presente,  . Se l’osservazione non contiene tutto ciò che serve (per esempio una sola immagine di una palla, che non dice la velocità), lo si recupera mettendo nello stato anche le osservazioni precedenti o usando reti con memoria.
Il ritorno e lo sconto
L’obiettivo non è la ricompensa immediata ma il ritorno, la somma delle ricompense future scontate:
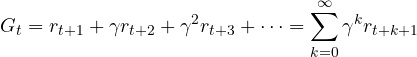
Lo sconto ha tre ragioni. Matematica: se le ricompense sono limitate da  e
 , la serie geometrica converge,
 . Pratica: una ricompensa lontana è più incerta. Interpretativa:
 è l’orizzonte su cui l’agente “guarda”: con
 circa 100 passi. Vale la relazione ricorsiva, che è alla base di tutto il corso:
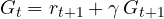
Policy e funzioni valore
Una policy  è la regola con cui l’agente sceglie: la probabilità di fare nello stato (deterministica se dà sempre la stessa azione). Per valutarla si definiscono:
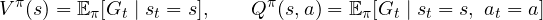
 , il valore dello stato, è il ritorno medio partendo da e seguendo
 ;
 , il valore dell’azione, è il ritorno medio facendo prima e poi seguendo . Sono legate da
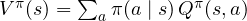 . La differenza
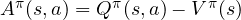 si chiama vantaggio: quanto l’azione è migliore della media. Tutti gli algoritmi moderni la usano.
Una policy  è ottima se
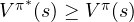 in ogni stato, per ogni altra . In un MDP finito una policy ottima deterministica esiste sempre (lo si dimostra nella lezione sulle equazioni di Bellman), e conoscendo
 è immediata:
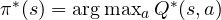 .
Un esempio completo: il gridworld
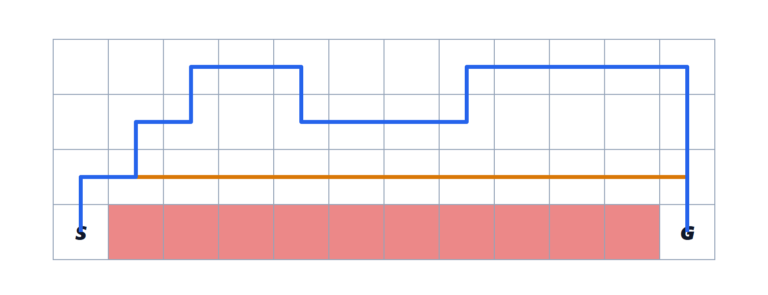
Una griglia 4×4; le caselle in alto a sinistra e in basso a destra sono le uscite. L’agente si muove di una casella in su, giù, sinistra o destra (se urta il bordo resta fermo), e ogni passo costa  : massimizzare il ritorno significa uscire il prima possibile. Con
 :
- per la policy ottima il valore di ogni casella è meno il numero di passi verso l’uscita più vicina: 0, −1, −2, −3;
- per la policy casuale (ogni direzione con probabilità 1/4) i valori sono molto più negativi: −14 vicino alle uscite, −22 negli angoli lontani, perché il cammino casuale vaga a lungo prima di uscire.
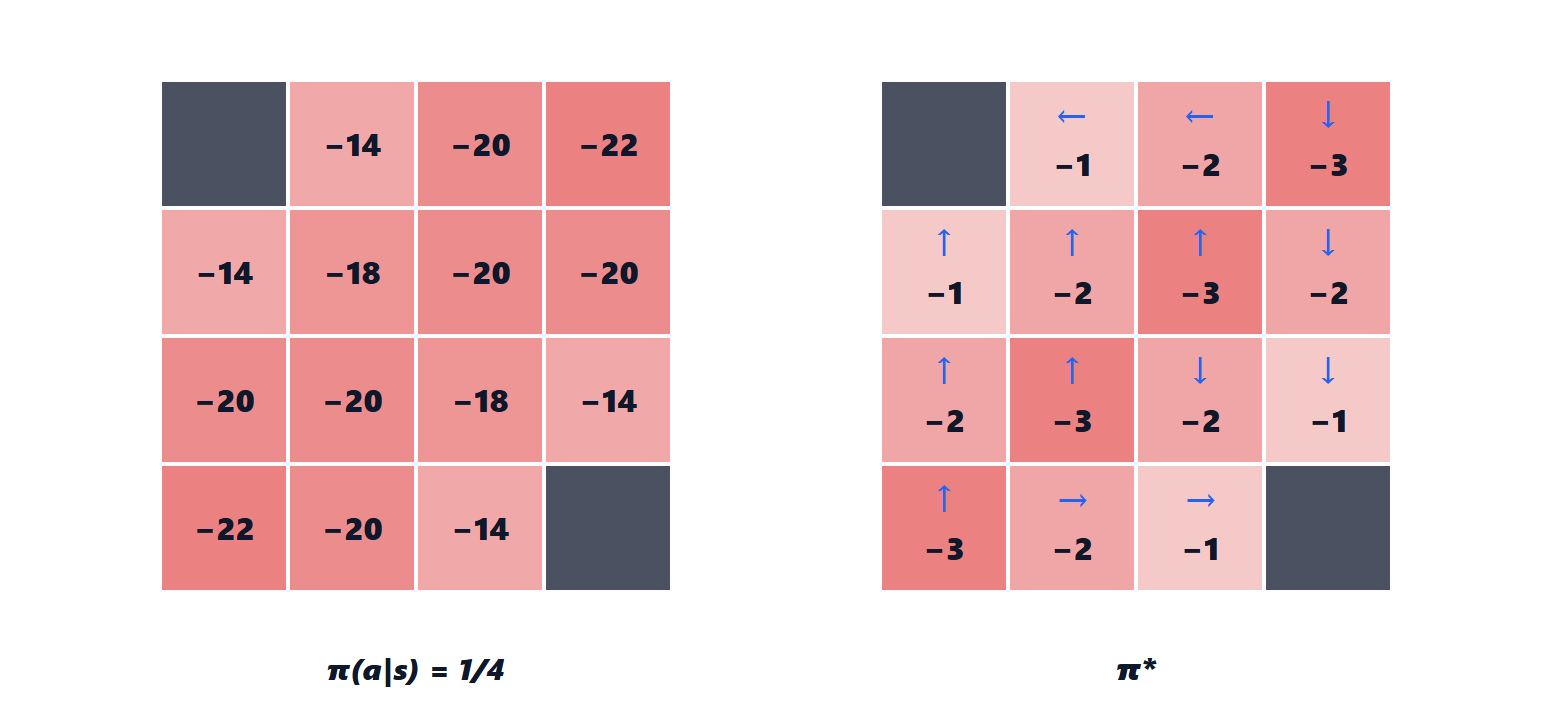
Il fatto che la policy casuale valga −22 in un angolo, e quella ottima −3, mostra il punto centrale dell’RL: dagli stessi stati e dalle stesse azioni, il comportamento scelto cambia radicalmente il risultato. La lezione successiva mostra come calcolare questi valori, e da essi la policy ottima, con le equazioni di Bellman; le lezioni seguenti come impararli quando  e
 non sono noti e lo stato è troppo grande per una tabella.
Dove sta l’RL tra le tecniche di controllo
Chi ha studiato Controlli automatici riconoscerà la struttura: lo stato, l’ingresso (azione), la dinamica (), un indice di costo da ottimizzare ( ). Il controllo ottimo (LQR, MPC) risolve lo stesso problema conoscendo il modello; l’RL lo risolve imparando dall’esperienza, anche quando il modello non c’è o è troppo complicato. Il prezzo è il numero di prove: per questo quasi sempre l’RL si fa in simulazione, e la velocità dei simulatori (lezione sulle librerie) è decisiva.

Benvenuti nella pagina su «Processi decisionali di Markov: agente, ambiente, ritorno, policy e funzioni valore». L'ho scritta pensando a chi studia ingegneria elettronica: se un passaggio non vi torna, un esercizio vi dà un risultato diverso o volete altro materiale sull'argomento, chiedete pure nei commenti e vi risponderò. Un voto con le stelle qui sopra mi aiuta a capire quali pagine migliorare.Welcome to the page on “Markov decision processes: agent, environment, return, policy and value functions”. I wrote it for engineering students: if a step does not add up, an exercise gives you a different result or you would like more material on the topic, just ask in the comments and I will reply. A star rating above helps me understand which pages to improve.