Monte Carlo e differenze temporali: SARSA e Q-learning sull’esempio della scogliera
Imparare i valori dall'esperienza: Monte Carlo, TD(0), condizioni di convergenza, SARSA on-policy e Q-learning off-policy, l'esempio della scogliera con percorso sicuro e percorso ottimo, codice verificato.
Le equazioni di Bellman richiedono di conoscere le probabilità di transizione  e le ricompense
 . Quasi mai le si conosce: un robot non ha la formula di come scivolerà sul pavimento, un gioco non dice in anticipo le mosse dell’avversario. Si può però provare e osservare cosa succede. Questa lezione presenta i metodi che imparano i valori dall’esperienza: Monte Carlo, che aspetta la fine dell’episodio, e le differenze temporali (TD), che aggiornano a ogni passo. Da queste nascono SARSA e Q-learning, che confrontiamo sull’esempio classico della scogliera, con il codice e i risultati.
Monte Carlo: la media dei ritorni
Il valore è una media: 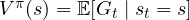 . Il modo più diretto di stimarlo è giocare molti episodi seguendo
 , calcolare il ritorno
 ogni volta che si passa da
 e farne la media. In forma incrementale, dopo ogni ritorno osservato:
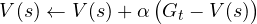
con  il passo di apprendimento. Con
 (n numero di visite) è esattamente la media aritmetica. Monte Carlo non fa ipotesi sull’ambiente, ma deve aspettare la fine dell’episodio e le sue stime hanno varianza alta: somma molte ricompense casuali.
Le differenze temporali
L’idea di Sutton (1988) è sostituire il ritorno vero, che si conosce solo alla fine, con una stima costruita dall’equazione di Bellman: 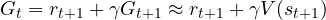 . L’aggiornamento TD(0) è
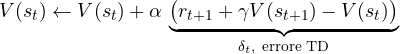
Si impara a ogni passo, anche in compiti senza fine. La stima usa un’altra stima (si dice che fa bootstrap): ha meno varianza di Monte Carlo, perché dipende da una sola ricompensa casuale, ma è distorta finché  è sbagliato. Lo scambio tra distorsione e varianza tra Monte Carlo e TD si regola con i ritorni a
 passi e con il parametro
 (TD(), e nella versione moderna il GAE usato dal PPO).
Convergenza. Con una tabella, se ogni stato è visitato infinite volte e i passi soddisfano le condizioni di Robbins e Monro,  e
 (per esempio
 ), TD(0) converge a
 con probabilità 1. L’idea della dimostrazione: in media l’aggiornamento applica l’operatore di Bellman, che è una contrazione; la prima condizione permette di arrivare ovunque, la seconda di spegnere il rumore.
Dal valore all’azione: SARSA e Q-learning
Per scegliere le azioni senza modello serve  , non
 : con bisognerebbe sapere dove porta ogni azione. Esplorando con una policy ε-greedy (azione migliore secondo
 con probabilità
 , casuale con probabilità
 ), si aggiorna dopo ogni transizione
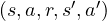 :
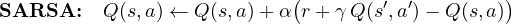
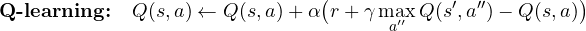
L’unica differenza è il bersaglio. SARSA usa l’azione  che l’agente farà davvero (esplorazione compresa): impara il valore della policy che sta seguendo, ed è detto on-policy. Q-learning usa il massimo, cioè l’azione che farebbe la policy ottima: impara
 qualunque sia il modo in cui esplora, ed è detto off-policy (Watkins, 1989). Proprio l’essere off-policy permette di riusare esperienza vecchia o raccolta da altri, ed è la base del DQN.
L’esempio della scogliera
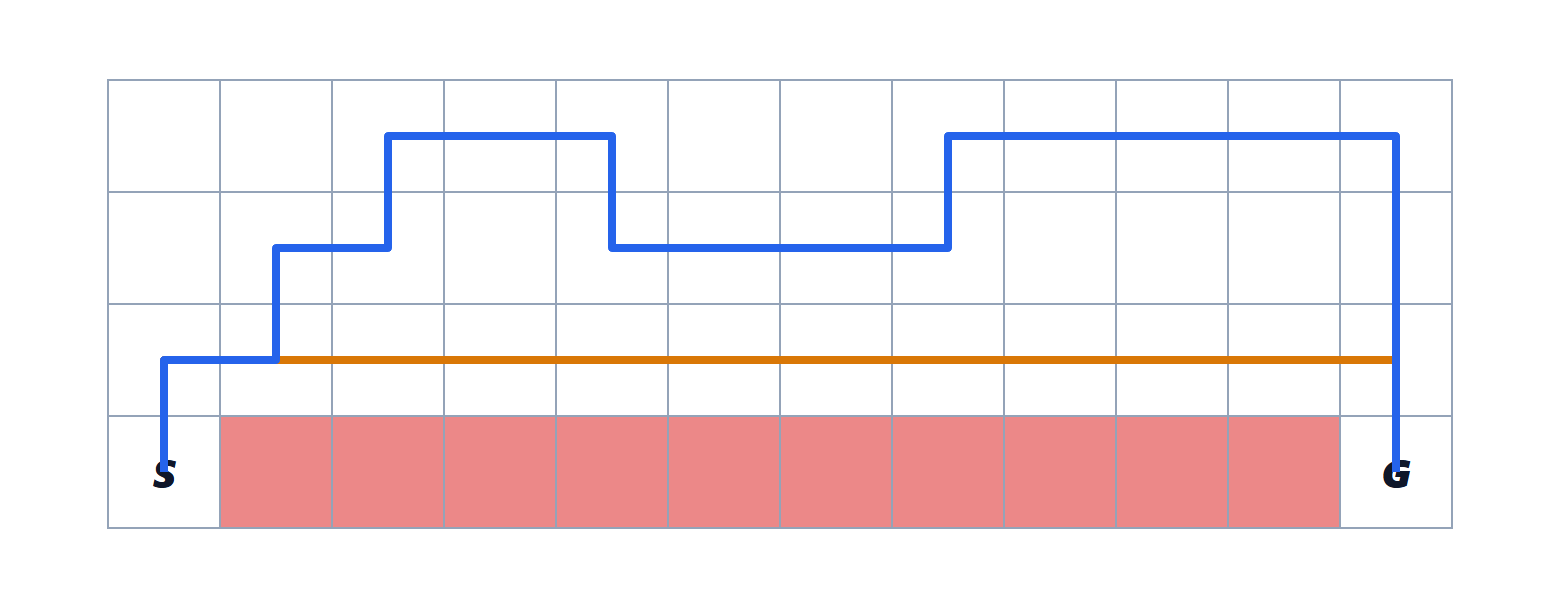
Una griglia 4×12: si parte in basso a sinistra, l’uscita è in basso a destra, e le caselle in basso tra le due sono una scogliera: chi ci cade prende  e torna alla partenza. Ogni passo costa
 . Il percorso più breve corre lungo il bordo della scogliera (13 passi); uno più sicuro passa più in alto.
Con  ,
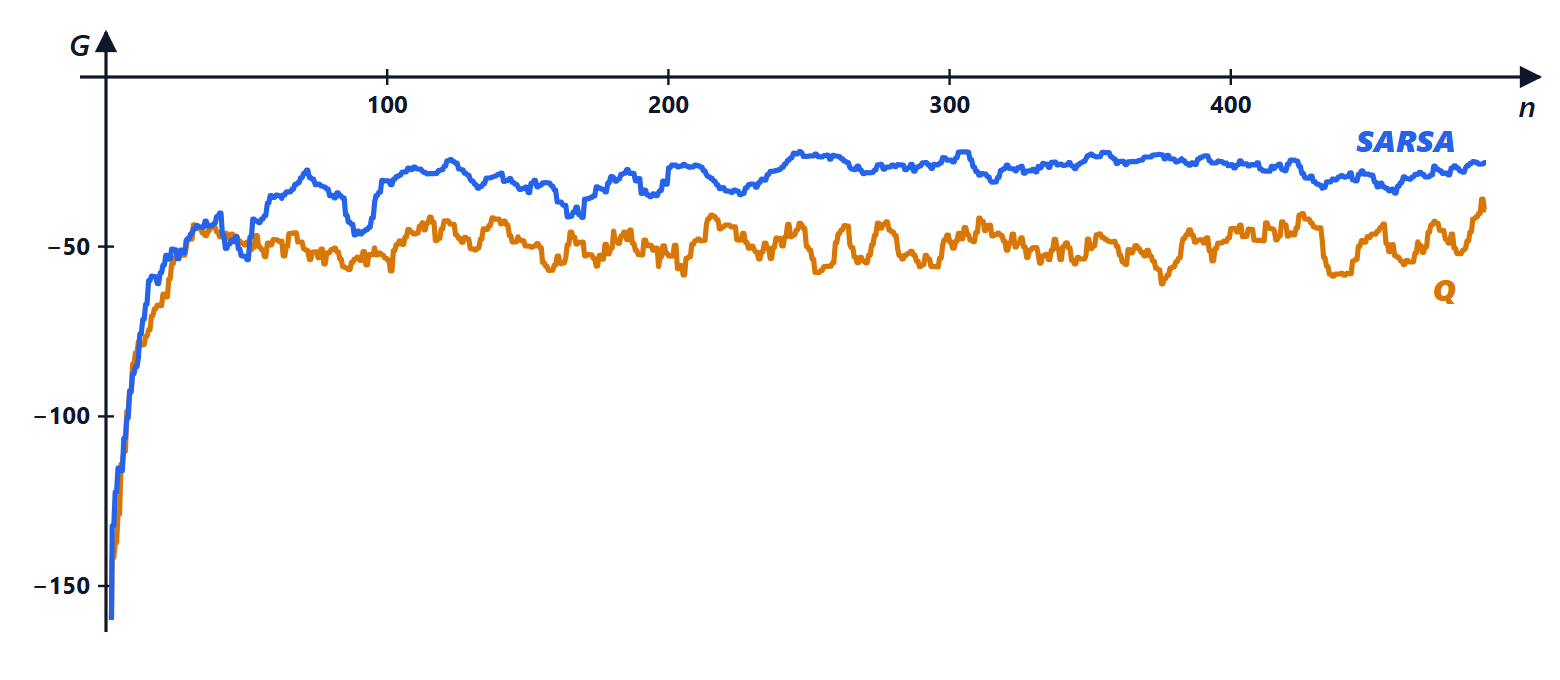
 e 500 episodi (media su 20 semi casuali):
| percorso appreso | ritorno medio negli ultimi 100 episodi | |
|---|---|---|
| SARSA | sicuro, 19 passi | −28,1 |
| Q-learning | ottimo, 13 passi | −48,0 |
Q-learning trova il percorso migliore, ma guadagna meno durante l’apprendimento: camminando sul bordo, la mossa casuale del 10 % lo fa cadere spesso. SARSA sa che esplorerà e preferisce stare lontano dal bordo. È una lezione che vale per i sistemi reali: un robot che impara su un impianto vero deve tenere conto della propria esplorazione, e algoritmi on-policy o “prudenti” sono spesso preferibili; in simulazione, dove cadere non costa nulla, si può usare Q-learning e poi spegnere l’esplorazione.
Il codice
import numpy as np

RIGHE, COLONNE = 4, 12
PARTENZA, USCITA = (3, 0), (3, 11)
MOSSE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def passo(pos, a):
    r = min(max(pos[0] + MOSSE[a][0], 0), RIGHE - 1)
    c = min(max(pos[1] + MOSSE[a][1], 0), COLONNE - 1)
    if r == 3 and 1 <= c <= 10:            # scogliera: -100 e ritorno alla partenza
        return PARTENZA, -100.0, False
    return (r, c), -1.0, (r, c) == USCITA

def impara(metodo, episodi=500, alpha=0.5, eps=0.1, seme=0):
    rng = np.random.default_rng(seme)
    Q = np.zeros((RIGHE, COLONNE, 4))
    def scegli(p):                          # epsilon-greedy (rumore minimo per rompere le parità)
        return rng.integers(4) if rng.random() < eps else int(np.argmax(Q[p] + 1e-9 * rng.random(4)))
    ritorni = []
    for _ in range(episodi):
        p, tot = PARTENZA, 0.0
        a = scegli(p)
        for _ in range(1000):
            p2, r, fine = passo(p, a)
            tot += r
            a2 = scegli(p2)
            if metodo == "sarsa":
                bersaglio = r if fine else r + Q[p2][a2]            # azione davvero scelta
            else:
                bersaglio = r if fine else r + np.max(Q[p2])        # azione migliore
            Q[p][a] += alpha * (bersaglio - Q[p][a])
            p, a = p2, a2
            if fine:
                break
        ritorni.append(tot)
    return np.array(ritorni), Q

for metodo in ("sarsa", "qlearning"):
    curve = np.array([impara(metodo, seme=s)[0] for s in range(20)])
    _, Q = impara(metodo, seme=0)
    p, lunghezza, fine = PARTENZA, 0, False
    while not fine and lunghezza < 50:      # percorso greedy finale
        p, _, fine = passo(p, int(np.argmax(Q[p])))
        lunghezza += 1
    print(f"{metodo:9s}: ultimi 100 episodi {curve[:, -100:].mean():6.1f}, percorso di {lunghezza} passi")
L’esecuzione stampa  e 19 passi per SARSA,
 e 13 passi per Q-learning. Una tabella con una casella per ogni coppia stato-azione funziona finché gli stati sono qualche migliaio; per CartPole (stati continui) o per un videogioco (stati fatti di pixel) serve un’approssimazione: la tabella diventa una rete neurale, ed è il DQN della lezione successiva.