Il Deep Q-Network (DQN): memoria di replay, rete bersaglio e double DQN su CartPole
Q-learning con una rete neurale: la triade letale, memoria di replay, rete bersaglio, la sovrastima del massimo dimostrata e il double DQN, fine vera e tempo scaduto, codice PyTorch che arriva a 500 su CartPole.
Una tabella  funziona finché gli stati sono pochi. CartPole ha quattro variabili continue, un videogioco Atari ha immagini di 210×160 pixel: gli stati sono infiniti o astronomicamente numerosi. Nel 2015 DeepMind mostrò che una rete neurale convoluzionale, addestrata con Q-learning e due accorgimenti, impara a giocare a 49 giochi Atari partendo solo dai pixel, superando in molti il livello umano. È il Deep Q-Network (DQN). Questa lezione spiega perché il Q-learning con una rete neurale è instabile, come lo stabilizzano la memoria di replay e la rete bersaglio, perché il massimo sovrastima i valori (e il rimedio, double DQN), e lo applica a CartPole con un codice che arriva al punteggio massimo.
Dal Q-learning con tabella alla rete
Si sostituisce la tabella con una funzione  dai parametri
 (i pesi di una rete): in ingresso lo stato, in uscita un valore per ogni azione. L’aggiornamento del Q-learning diventa un passo di discesa del gradiente sulla perdita
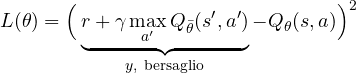
dove il bersaglio  viene trattato come una costante (non si deriva rispetto a esso). Sembra semplice, ma messo insieme in modo ingenuo diverge spesso.
Perché diverge: la triade letale
Sutton e Barto chiamano triade letale la combinazione di tre ingredienti che, insieme, possono far divergere l’apprendimento anche in problemi semplici:
- approssimazione di funzione: cambiando per correggere cambiano anche i valori di stati simili, che non si volevano toccare;
- bootstrap: il bersaglio contiene la stima stessa
 , quindi un errore si propaga e si autoalimenta;
- off-policy: si impara la policy greedy da dati raccolti con un’altra policy (quella che esplora).
Il Q-learning profondo li ha tutti e tre. A questi si aggiunge un problema statistico: i passi consecutivi di un episodio sono fortemente correlati (lo stato al passo  è quasi uguale a quello al passo
 ), mentre la discesa del gradiente presuppone esempi indipendenti.
I due accorgimenti del DQN
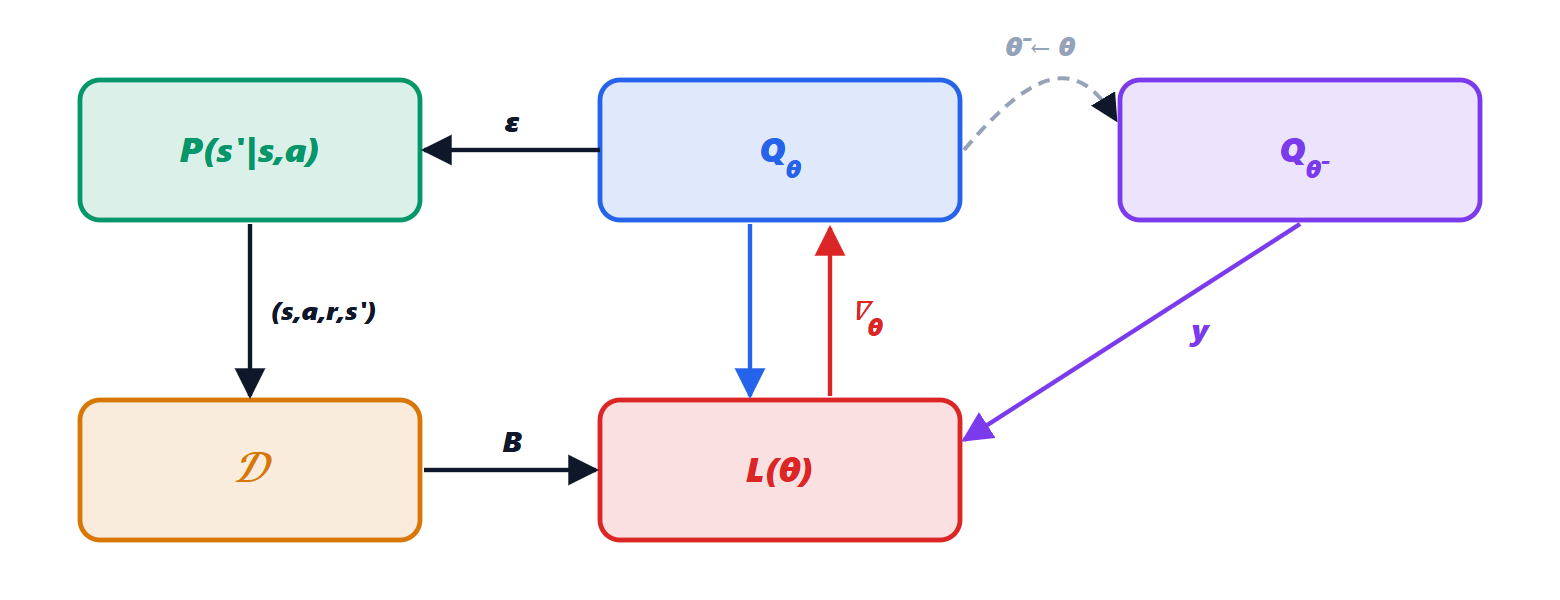
La memoria di replay. Ogni transizione 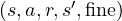 viene salvata in un buffer di qualche decina di migliaia di elementi; a ogni passo di addestramento si estrae a caso un mini-lotto. Questo rompe le correlazioni, riusa ogni esperienza molte volte (ed è lecito perché il Q-learning è off-policy) e media su molte situazioni diverse.
La rete bersaglio. Il bersaglio si calcola con una copia dei pesi,  , aggiornata solo ogni qualche centinaio o migliaio di passi (
 ). Tra due copie il problema diventa una regressione supervisionata con bersagli fissi, e la rete non “insegue la propria coda”.
La sovrastima del massimo e il double DQN
Teorema. Se le stime  sono non distorte ma rumorose,
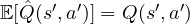 , allora il massimo è sovrastimato:
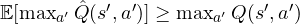 .
Dimostrazione. Per ogni  ,
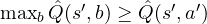 ; prendendo la media,
 , e vale per ogni , quindi anche per quello che rende massimo
 . ∎
Il rumore viene “selezionato”: l’azione che sembra migliore è spesso quella stimata per eccesso. La sovrastima si accumula con il bootstrap. Il double DQN (van Hasselt, 2016) separa la scelta dalla valutazione: la rete online sceglie l’azione, la rete bersaglio la valuta,
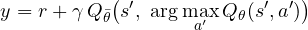
Gli errori delle due reti sono in buona parte indipendenti, e la sovrastima si riduce molto.
Fine vera e tempo scaduto. Se l’episodio finisce perché il palo è caduto, dopo non c’è più ricompensa e il bersaglio è solo  . Se invece finisce perché è scaduto il tempo (500 passi in CartPole), lo stato non è terminale: il bersaglio deve comprendere ancora
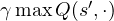 . Confondere i due casi è uno degli errori più comuni; Gymnasium li distingue con i due valori
terminated e truncated.
Il codice su CartPole
import random, collections
import numpy as np
import torch, torch.nn as nn
import gymnasium

torch.manual_seed(0); random.seed(0); np.random.seed(0)
env = gymnasium.make("CartPole-v1")

def rete():
    return nn.Sequential(nn.Linear(4, 128), nn.ReLU(), nn.Linear(128, 128), nn.ReLU(), nn.Linear(128, 2))
q, q_bersaglio = rete(), rete()
q_bersaglio.load_state_dict(q.state_dict())
opt = torch.optim.Adam(q.parameters(), lr=2.5e-4)
memoria = collections.deque(maxlen=10000)                     # memoria di replay
PASSI, LOTTO, GAMMA, COPIA, OGNI, INIZIO = 200000, 128, 0.99, 500, 10, 10000

o, _ = env.reset(seed=0)
env.action_space.seed(0)
for t in range(PASSI):
    eps = max(0.05, 1 - 0.95 * t / 100000)                   # esplorazione che decresce
    if random.random() < eps:
        a = env.action_space.sample()
    else:
        with torch.no_grad():
            a = int(q(torch.tensor(o, dtype=torch.float32)).argmax())
    o2, r, terminato, troncato, _ = env.step(a)
    memoria.append((o, a, r, o2, float(terminato)))           # solo la fine vera azzera il futuro
    o = o2
    if terminato or troncato:
        o, _ = env.reset()
    if t >= INIZIO and t % OGNI == 0:
        b = random.sample(memoria, LOTTO)
        O, A, R, O2, D = (torch.tensor(np.array(x), dtype=torch.float32) for x in zip(*b))
        with torch.no_grad():                                 # double DQN
            a2 = q(O2).argmax(1, keepdim=True)
            y = R + GAMMA * (1 - D) * q_bersaglio(O2).gather(1, a2).squeeze(1)
        stima = q(O).gather(1, A.long().unsqueeze(1)).squeeze(1)
        perdita = nn.functional.mse_loss(stima, y)
        opt.zero_grad(); perdita.backward(); opt.step()
    if t % COPIA == 0:
        q_bersaglio.load_state_dict(q.state_dict())          # aggiornamento della rete bersaglio

# valutazione greedy su 20 episodi
punti = []
for e in range(20):
    o, _ = env.reset(seed=1000 + e)
    tot, fine = 0.0, False
    while not fine:
        with torch.no_grad():
            o, r, te, tr, _ = env.step(int(q(torch.tensor(o, dtype=torch.float32)).argmax()))
        tot += r; fine = te or tr
    punti.append(tot)
print("valutazione:", np.mean(punti))
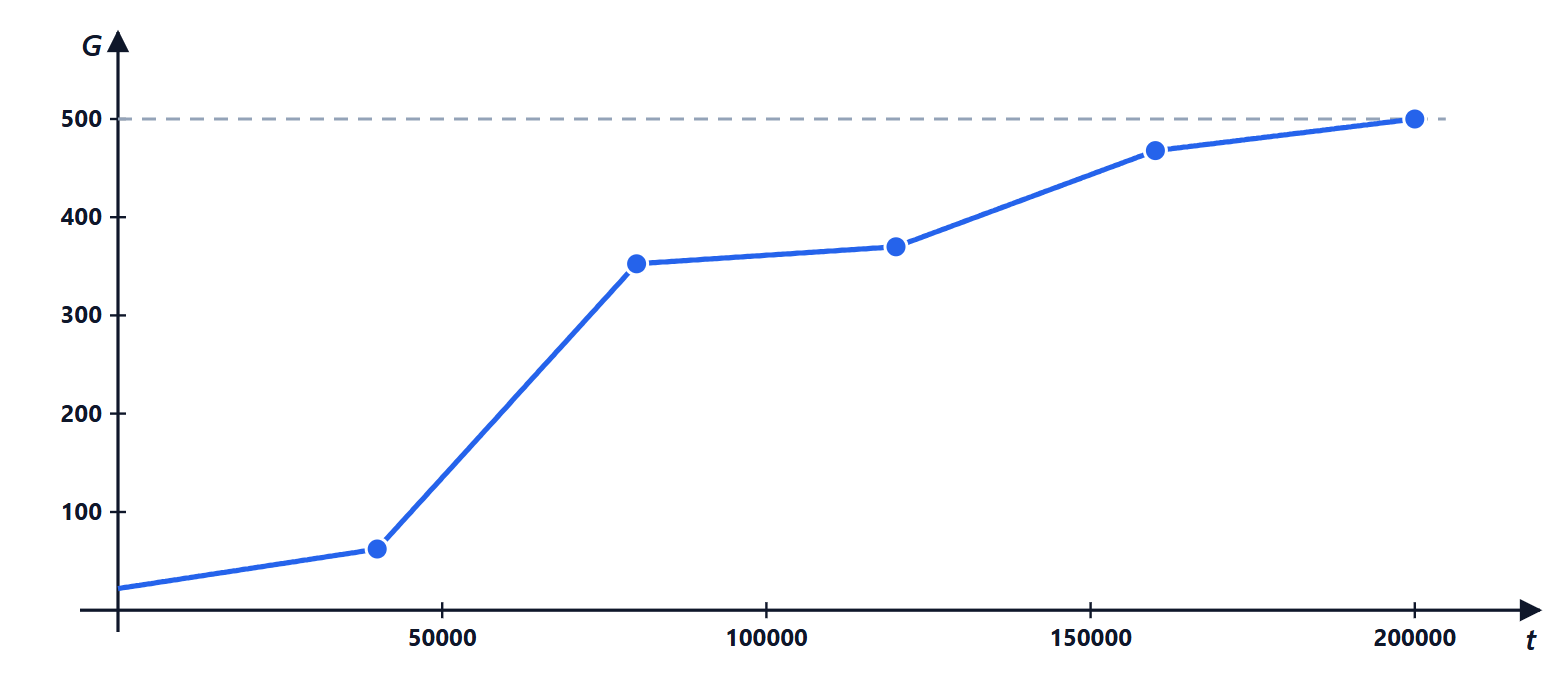
Gli iperparametri sono quelli della libreria didattica CleanRL. Durante l’addestramento il ritorno medio passa da 62 (dopo 40 000 passi) a 353, 370, 468 e 500; la valutazione greedy finale è 500 su 20 episodi, il massimo possibile. Su un processore normale serve meno di un minuto.
Oltre il DQN
Il DQN funziona con poche azioni discrete (deve calcolare il massimo su tutte). Per azioni continue, come le coppie di un robot o lo sterzo di un’auto, si usano i metodi actor-critic (DDPG, TD3, SAC), che imparano anche una policy, e i metodi a gradiente della policy della lezione successiva. Le varianti del DQN per i giochi (Rainbow) aggiungono il replay con priorità, le reti “dueling”, i ritorni a più passi e le distribuzioni dei ritorni; il principio resta quello descritto qui.