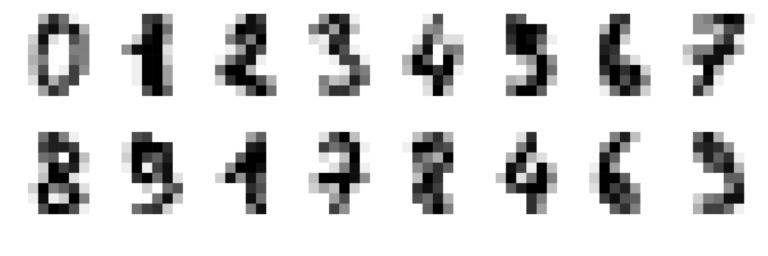Le reti convoluzionali: convoluzione, equivarianza alle traslazioni, pooling e dimensioni
La convoluzione in due dimensioni, l'equivarianza alle traslazioni dimostrata, pooling, formule delle dimensioni e del numero di parametri, LeNet, AlexNet e ResNet, rete densa contro CNN sulle cifre scritte a mano.
Un’immagine da un megapixel a colori ha tre milioni di valori: una rete densa con mille neuroni nel primo strato avrebbe tre miliardi di pesi solo lì, e dovrebbe imparare separatamente che un gatto in alto a sinistra e un gatto in basso a destra sono la stessa cosa. Le reti convoluzionali (CNN) risolvono entrambi i problemi con due idee prese dall’elaborazione dei segnali: i pesi sono locali (ogni neurone guarda solo una piccola zona) e condivisi (lo stesso filtro scorre su tutta l’immagine). Questa lezione definisce la convoluzione, dimostra la proprietà che rende le CNN adatte alle immagini (l’equivarianza alle traslazioni), ricava le formule delle dimensioni, e confronta una CNN con una rete densa sulle cifre scritte a mano.
La convoluzione
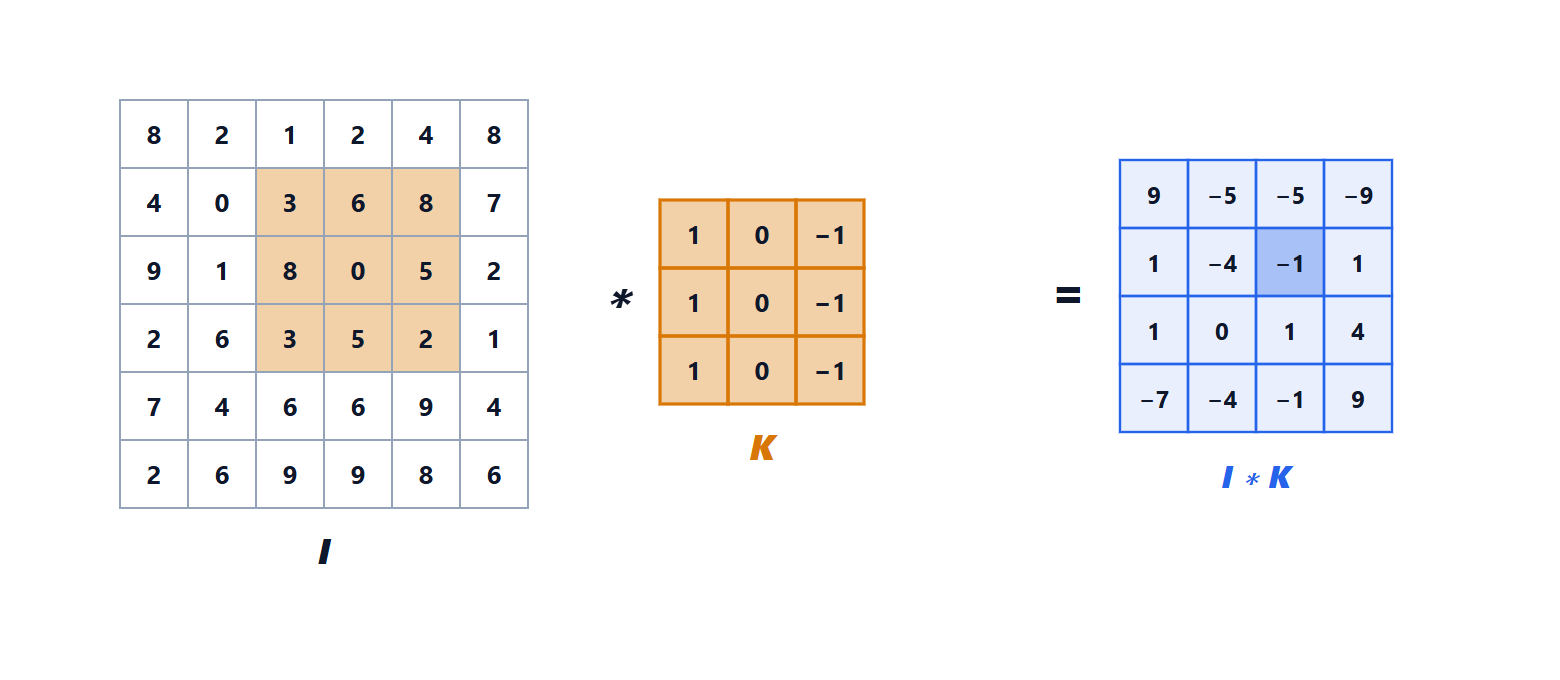
Uno strato convoluzionale applica un filtro (kernel)  di piccole dimensioni, per esempio 3×3, a ogni posizione dell’immagine
 :
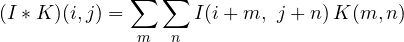
(nelle reti neurali si usa questa forma, che a rigore è una correlazione; la convoluzione vera ha il filtro capovolto, ma dato che il filtro si impara la differenza non conta). È lo stesso filtro FIR dell’elaborazione numerica dei segnali, in due dimensioni. Con più canali d’ingresso (i tre colori, o le uscite dello strato precedente) il filtro ha un canale per ognuno e i contributi si sommano; con più filtri si ottengono più mappe di caratteristiche in uscita.
Un filtro 3×3 con valori  su ogni riga, per esempio, risponde ai bordi verticali. La rete non riceve filtri scritti a mano: li impara con la retropropagazione, e nei primi strati di una CNN addestrata compaiono proprio rivelatori di bordi e di macchie di colore; negli strati successivi, combinazioni sempre più complesse (angoli, texture, parti di oggetti).
Perché funziona: l’equivarianza alle traslazioni
Teorema. La convoluzione commuta con le traslazioni: se si sposta l’immagine, la mappa di uscita si sposta della stessa quantità. Con  la traslazione
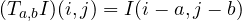 :
 .
Dimostrazione. 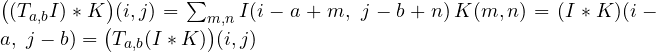 . ∎
Un rivelatore di occhi imparato in un angolo dell’immagine funziona automaticamente ovunque: non bisogna impararlo di nuovo per ogni posizione. Questo pregiudizio induttivo (una conoscenza a priori sul problema, inserita nella struttura della rete) riduce enormemente i parametri e i dati necessari. Per ottenere anche una parziale invarianza (stessa risposta anche se l’oggetto si sposta) si aggiunge il pooling: il max-pooling 2×2 sostituisce ogni blocco di 2×2 valori con il massimo, dimezzando le dimensioni e rendendo la rete poco sensibile a spostamenti piccoli.
Le dimensioni
Per un ingresso di lato  , filtro di lato
 , padding
 (bordo di zeri aggiunto) e passo (stride)
 , il lato dell’uscita è

(il filtro parte dalla posizione 0 e può fare  spostamenti). Con
 ,
 ,
 l’uscita ha le stesse dimensioni dell’ingresso. Uno strato con
 canali d’ingresso e
 filtri ha
 parametri, indipendentemente dalla dimensione dell’immagine. Il campo recettivo (la zona d’ingresso che influenza un neurone) cresce di
 pixel per ogni strato 3×3 e raddoppia con ogni pooling: impilando strati, i neuroni profondi “vedono” tutta l’immagine.
Le architetture storiche mostrano l’evoluzione: LeNet (1998) leggeva i codici postali; AlexNet (2012) vinse la gara ImageNet con un margine enorme usando le GPU e la ReLU, dando inizio all’era del deep learning; ResNet (2015) aggiunse le connessioni residue 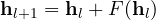 , che permettono al gradiente di attraversare centinaia di strati senza svanire.
L’esperimento: rete densa contro rete convoluzionale
Sulle 1797 cifre scritte a mano 8×8 di scikit-learn (1347 per l’addestramento, 450 per la prova), due reti addestrate con Adam per 60 epoche:
- rete densa: 64 ingressi → 64 neuroni ReLU → 10 uscite;
- CNN: due strati convoluzionali 3×3 (8 e 16 filtri) con ReLU, un max-pooling 2×2, uno strato denso finale.
| rete | parametri | accuratezza di prova | con l’immagine spostata di 1 pixel |
|---|---|---|---|
| densa | 4 810 | 96,9 % | 42,9 % |
| convoluzionale | 3 818 | 98,2 % | 65,1 % |
La CNN è più precisa con meno parametri, perché la struttura convoluzionale le dice già che pixel vicini vanno guardati insieme. Spostando tutte le immagini di prova di un pixel a destra (un cambiamento minimo per un occhio umano), la rete densa crolla al 43 %: ha imparato “questo pixel acceso significa 7”, non la forma. La CNN regge meglio ma perde comunque molto, perché su immagini 8×8 un pixel è più del 10 % della larghezza e il pooling dà solo una piccola invarianza. In pratica si aggiunge l’aumento dei dati (data augmentation): si addestra anche su copie spostate, ruotate, ingrandite delle immagini.
import numpy as np, torch, torch.nn as nn
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split

d = load_digits()
Xa, Xp, ya, yp = train_test_split(d.data / 16.0, d.target, test_size=0.25, random_state=0, stratify=d.target)
Xa, Xp = torch.tensor(Xa, dtype=torch.float32), torch.tensor(Xp, dtype=torch.float32)
ya, yp = torch.tensor(ya), torch.tensor(yp)

def addestra(modello, epoche=60):
    torch.manual_seed(0)
    opt = torch.optim.Adam(modello.parameters(), lr=1e-3)
    for _ in range(epoche):
        perm = torch.randperm(len(Xa))
        for i in range(0, len(Xa), 64):
            idx = perm[i:i + 64]
            perdita = nn.functional.cross_entropy(modello(Xa[idx]), ya[idx])
            opt.zero_grad(); perdita.backward(); opt.step()
    return modello

def accuratezza(modello, X):
    with torch.no_grad():
        return float((modello(X).argmax(1) == yp).float().mean())

torch.manual_seed(0)
densa = nn.Sequential(nn.Linear(64, 64), nn.ReLU(), nn.Linear(64, 10))
torch.manual_seed(0)
cnn = nn.Sequential(nn.Unflatten(1, (1, 8, 8)),                    # da 64 valori a immagine 1x8x8
                    nn.Conv2d(1, 8, 3, padding=1), nn.ReLU(),       # 8 filtri 3x3
                    nn.Conv2d(8, 16, 3, padding=1), nn.ReLU(),      # 16 filtri 3x3x8
                    nn.MaxPool2d(2),                                # 8x8 -> 4x4
                    nn.Flatten(), nn.Linear(16 * 4 * 4, 10))
addestra(densa); addestra(cnn)

spostate = torch.roll(Xp.view(-1, 8, 8), 1, dims=2)                 # tutte le cifre un pixel a destra
spostate[:, :, 0] = 0
spostate = spostate.view(-1, 64)
for nome, m in (("densa", densa), ("convoluzionale", cnn)):
    n = sum(p.numel() for p in m.parameters())
    print(f"{nome:15s}: {n} parametri, prova {accuratezza(m, Xp):.4f}, spostate {accuratezza(m, spostate):.4f}")