Gli ottimizzatori: SGD, momentum, RMSProp e Adam con la correzione della distorsione
Discesa del gradiente stocastica a mini-lotti, momentum, RMSProp, Adam e la correzione della distorsione dimostrata, AdamW, riscaldamento e decrescita del passo, confronto dei metodi sulla funzione di Rosenbrock.
La discesa del gradiente della lezione 1 funziona, ma sulle reti neurali è lenta: la superficie dell’errore ha valli strette e lunghe, zone piatte e milioni di dimensioni con curvature molto diverse. Gli ottimizzatori moderni modificano la regola di aggiornamento per andare più veloci e in modo più stabile. Questa lezione presenta la discesa del gradiente stocastica a mini-lotti, il momentum, RMSProp e Adam (l’ottimizzatore più usato), dimostra perché Adam ha bisogno della “correzione della distorsione”, parla della scelta del passo nel tempo, e confronta i metodi sulla funzione di Rosenbrock, una valle curva che è il banco di prova classico.
La discesa del gradiente stocastica
Il gradiente della perdita è una media su tutti gli  esempi. Con milioni di esempi, calcolarlo per intero a ogni passo è uno spreco. La discesa del gradiente stocastica (SGD) usa a ogni passo un mini-lotto
 di qualche decina o centinaio di esempi estratti a caso:
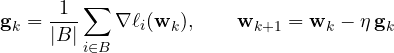
 è una stima non distorta del gradiente vero (la media di un campione casuale ha per media la media della popolazione), con una varianza che cala come
 . Il rumore non è solo un difetto: aiuta a uscire dalle zone piatte e, secondo molti studi, porta a minimi più “larghi” che generalizzano meglio. Un passaggio completo sui dati si chiama epoca.
Il momentum
In una valle stretta il gradiente punta soprattutto verso le pareti: la discesa rimbalza da una parte all’altra e avanza piano lungo il fondo. Il momentum (Polyak, 1964: il “metodo della palla pesante”) accumula una velocità:

con  . Le componenti del gradiente che cambiano segno a ogni passo (attraverso la valle) si cancellano nella media; quelle che hanno sempre lo stesso segno (lungo la valle) si sommano. Se il gradiente fosse costante, la velocità tenderebbe a
 : con
 un passo dieci volte più lungo nella direzione buona.
RMSProp e Adam: un passo per ogni parametro
Parametri diversi possono avere gradienti di scala molto diversa (per esempio i pesi dei primi strati e quelli dell’ultimo). RMSProp (Hinton, 2012) divide il passo di ogni parametro per una media mobile della radice del suo gradiente al quadrato: chi ha gradienti grandi fa passi più corti, chi li ha piccoli più lunghi. Adam (Kingma e Ba, 2014) unisce questa idea con il momentum:
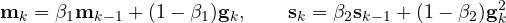

con i valori predefiniti  ,
 ,
 . Il passo effettivo è quasi indipendente dalla scala del gradiente: è circa
 nella direzione del segno del gradiente medio.
Teorema (correzione della distorsione). Se i gradienti hanno media costante  e si parte da
 , allora
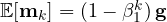 ; quindi
 ha media esattamente
 .
Dimostrazione. Srotolando la ricorrenza, 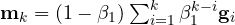 . Prendendo la media,
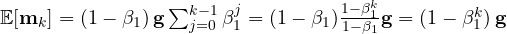 . Lo stesso vale per
 con
 . ∎
Senza correzione, nei primi passi  e
 sarebbero molto vicini a zero (partono da zero) e, soprattutto con , il denominatore sarebbe sottostimato: i primi passi sarebbero enormi. Dopo qualche migliaio di passi
 e la correzione non conta più. AdamW (2017) separa la penalità sui pesi (weight decay) dal passo adattivo, ed è oggi la scelta predefinita per i transformer.
Il passo nel tempo
Un passo costante grande avanza in fretta ma alla fine “balla” intorno al minimo; uno piccolo è preciso ma lento. Per questo si fa variare il passo durante l’addestramento:
- riscaldamento (warm-up): per qualche centinaio o migliaio di passi il passo cresce da zero al valore pieno, mentre le stime di Adam si assestano e la rete esce dalla fase iniziale caotica;
- decrescita: lineare, a gradini, o a coseno (il passo segue mezzo periodo di coseno fino a quasi zero). Si è visto anche nel PPO del corso di apprendimento per rinforzo: il passo che scende a zero ha stabilizzato la policy finale.
Il confronto sulla funzione di Rosenbrock
La funzione 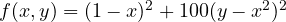 ha il minimo in (1, 1) in fondo a una valle stretta e curva a forma di banana: in fondo alla valle il gradiente è quasi nullo, sulle pareti enorme. Partendo da (−1,5; 2), si conta quanti passi servono per arrivare a
 :
| metodo | passo | passi per |
|---|---|---|
| discesa del gradiente | 0,001 | 15 681 |
| momentum () | 0,001 | 1 484 |
| Adam | 0,02 | 2 286 |
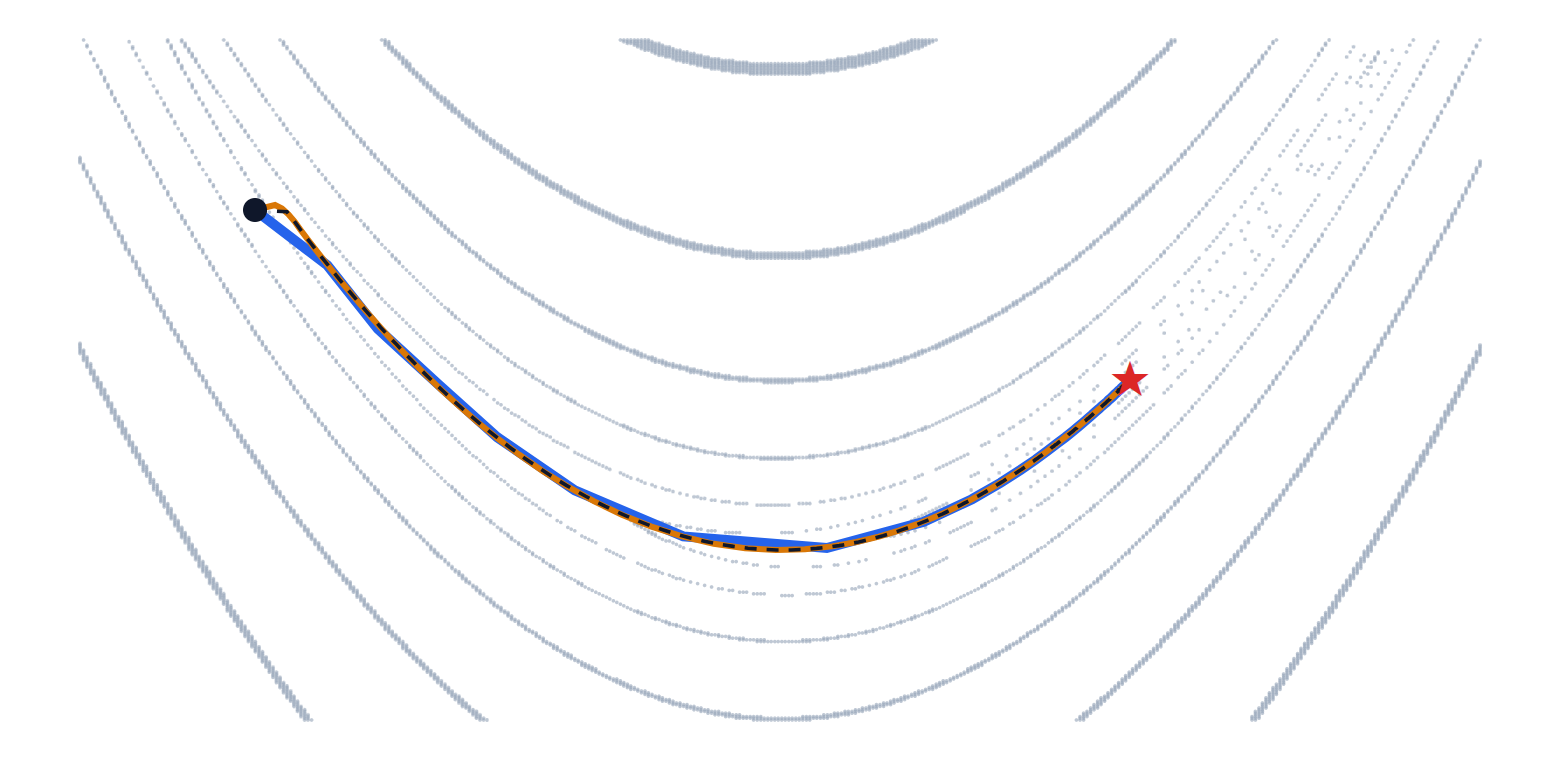
Il momentum è circa dieci volte più veloce della discesa semplice (15 681 / 1 484 = 10,6), come previsto dal fattore  . Adam, con un passo che non dipende dalla scala del gradiente, arriva in un numero di passi simile. Sulle reti neurali vere le differenze sono spesso meno nette e dipendono dal problema: SGD con momentum resta molto usato per le reti convoluzionali, Adam e AdamW per transformer e reti ricorrenti. La scelta del passo conta quasi sempre più della scelta dell’ottimizzatore.
import numpy as np

f = lambda p: (1 - p[0]) ** 2 + 100 * (p[1] - p[0] ** 2) ** 2
grad = lambda p: np.array([-2 * (1 - p[0]) - 400 * p[0] * (p[1] - p[0] ** 2), 200 * (p[1] - p[0] ** 2)])

def ottimizza(metodo, eta, passi=20000):
    p, v, m, s = np.array([-1.5, 2.0]), np.zeros(2), np.zeros(2), np.zeros(2)
    for k in range(1, passi + 1):
        g = grad(p)
        if metodo == "gradiente":
            p = p - eta * g
        elif metodo == "momentum":
            v = 0.9 * v + g
            p = p - eta * v
        else:                                              # Adam
            m = 0.9 * m + 0.1 * g
            s = 0.999 * s + 0.001 * g * g
            m_hat, s_hat = m / (1 - 0.9 ** k), s / (1 - 0.999 ** k)     # correzione della distorsione
            p = p - eta * m_hat / (np.sqrt(s_hat) + 1e-8)
        if f(p) < 1e-6:
            return k
    return None

for metodo, eta in (("gradiente", 1e-3), ("momentum", 1e-3), ("adam", 2e-2)):
    print(f"{metodo:9s}: f < 1e-6 dopo {ottimizza(metodo, eta)} passi")