Regressione e discesa del gradiente: equazioni normali, convergenza, regressione logistica e sovradattamento
Il problema dell'apprendimento supervisionato, le equazioni normali dimostrate, la convergenza della discesa del gradiente con il limite 2/L, la regressione logistica e l'entropia incrociata, sovradattamento e regolarizzazione ridge con esperimenti.
Il machine learning (apprendimento automatico) costruisce modelli che imparano dai dati invece di essere programmati regola per regola: si sceglie una famiglia di funzioni con dei parametri, si definisce un errore che misura quanto le previsioni si allontanano dai dati, e si cercano i parametri che lo rendono minimo. Tutte le reti neurali, anche le più grandi, funzionano così. Questa prima lezione presenta gli ingredienti con i modelli più semplici: la regressione lineare (con la soluzione esatta e quella iterativa della discesa del gradiente, di cui si dimostra la convergenza), la regressione logistica per la classificazione, e il problema centrale di tutto il corso, il sovradattamento.
Il problema dell’apprendimento supervisionato
Si hanno  esempi
 : un ingresso (le misure di un sensore, i pixel di un’immagine) e la risposta giusta (una temperatura, una cifra). Si vuole una funzione
 che preveda
 anche per ingressi nuovi. Si sceglie una perdita
 e si minimizza la sua media sui dati:

Il vero obiettivo però non è far bene sui dati che si hanno, ma su quelli che arriveranno: per questo si tengono da parte alcuni esempi (insieme di validazione e insieme di prova) che non si usano per l’addestramento e servono solo a misurare.
La regressione lineare e le equazioni normali
Con 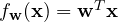 (aggiungendo a
 una componente costante 1, il primo peso fa da termine noto) e l’errore quadratico, mettendo gli esempi nelle righe di una matrice
 :
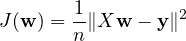
Teorema. Se  è invertibile, il minimo è
 (equazioni normali).
Dimostrazione.  è una funzione quadratica convessa; il gradiente è
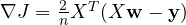 e si annulla per
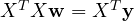 . La matrice hessiana
 è definita positiva (se le colonne di sono indipendenti), quindi il punto stazionario è l’unico minimo. Geometricamente,
 è la proiezione ortogonale di
 sullo spazio generato dalle colonne di : il residuo
 è perpendicolare a tutte le colonne. ∎
La discesa del gradiente
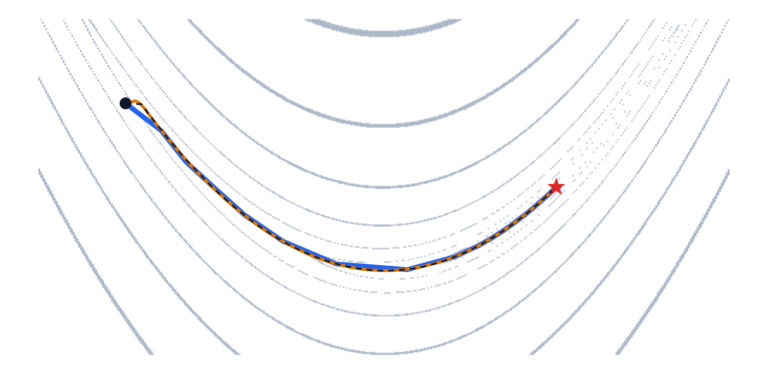
Per modelli più complicati non esiste una formula chiusa. Si parte da un  qualunque e si fanno piccoli passi nella direzione in cui l’errore diminuisce più in fretta, l’opposto del gradiente:
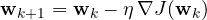
con  il passo di apprendimento (learning rate). È l’algoritmo che addestra tutte le reti neurali.
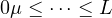
Teorema (convergenza sul quadratico). Per quadratico con hessiana  definita positiva, di autovalori
 , la discesa del gradiente converge a
 da qualunque punto di partenza se e solo se
 .
Dimostrazione. Per un quadratico 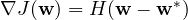 , quindi l’errore
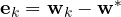 evolve come
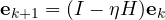 . Negli autovettori di ogni componente si moltiplica a ogni passo per
 , e tende a zero se e solo se
 , cioè
 . La condizione più stringente è quella dell’autovalore più grande,
 . ∎
La velocità dipende dal numero di condizionamento  : con il passo migliore il fattore di riduzione per passo è
 , vicino a 1 quando gli autovalori sono molto diversi. È il motivo per cui si normalizzano gli ingressi (stessa scala per tutte le variabili) e per cui esistono gli ottimizzatori della lezione 4.
Esempio numerico. Con 50 punti 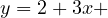 rumore, le equazioni normali danno
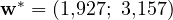 . Per questi dati
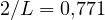 : la discesa del gradiente con
 ,
 e
 converge allo stesso risultato (con
 servono 213 passi per un errore di
 ), mentre con
 , appena oltre il limite, diverge fino a valori di
 .
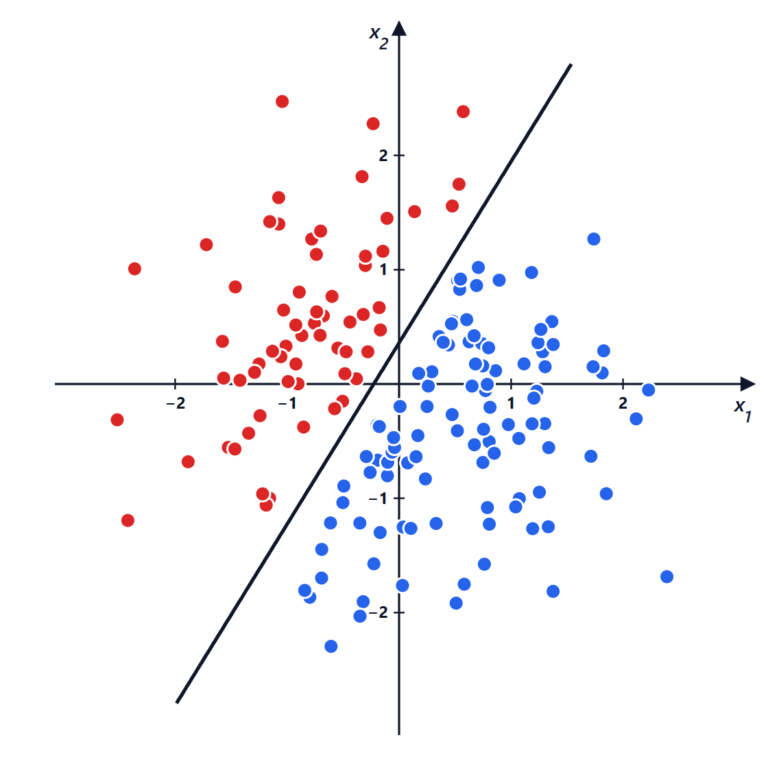
La classificazione: regressione logistica
Per prevedere una classe (sì o no, guasto o non guasto) si usa la sigmoide  , che trasforma un numero qualunque in una probabilità:
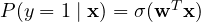 .
Teorema. Massimizzare la verosimiglianza dei dati equivale a minimizzare l’entropia incrociata 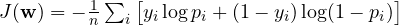 , con
 , e il gradiente è
 .
Dimostrazione. La probabilità di osservare  è
 ; per esempi indipendenti la verosimiglianza è il prodotto, e il suo logaritmo cambiato di segno e diviso per è . Per il gradiente si usa
 :
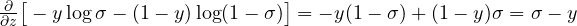 . ∎
Il gradiente ha la stessa forma della regressione lineare: (previsione − verità) × ingresso. Con più classi la sigmoide diventa la softmax  e il gradiente rispetto a
 è ancora
 : è l’ultimo strato di quasi tutte le reti di classificazione.
Il sovradattamento
Un modello troppo flessibile impara anche il rumore dei dati. Con 15 punti di  più rumore, si adattano polinomi di grado crescente e si misura l’errore quadratico medio sui dati di addestramento e su 200 punti nuovi:
| grado | errore di addestramento | errore su dati nuovi |
|---|---|---|
| 1 | 0,252 | 0,259 |
| 3 | 0,013 | 0,095 |
| 9 | 0,007 | 0,808 |
| 14 | 0,002 | 50,2 |
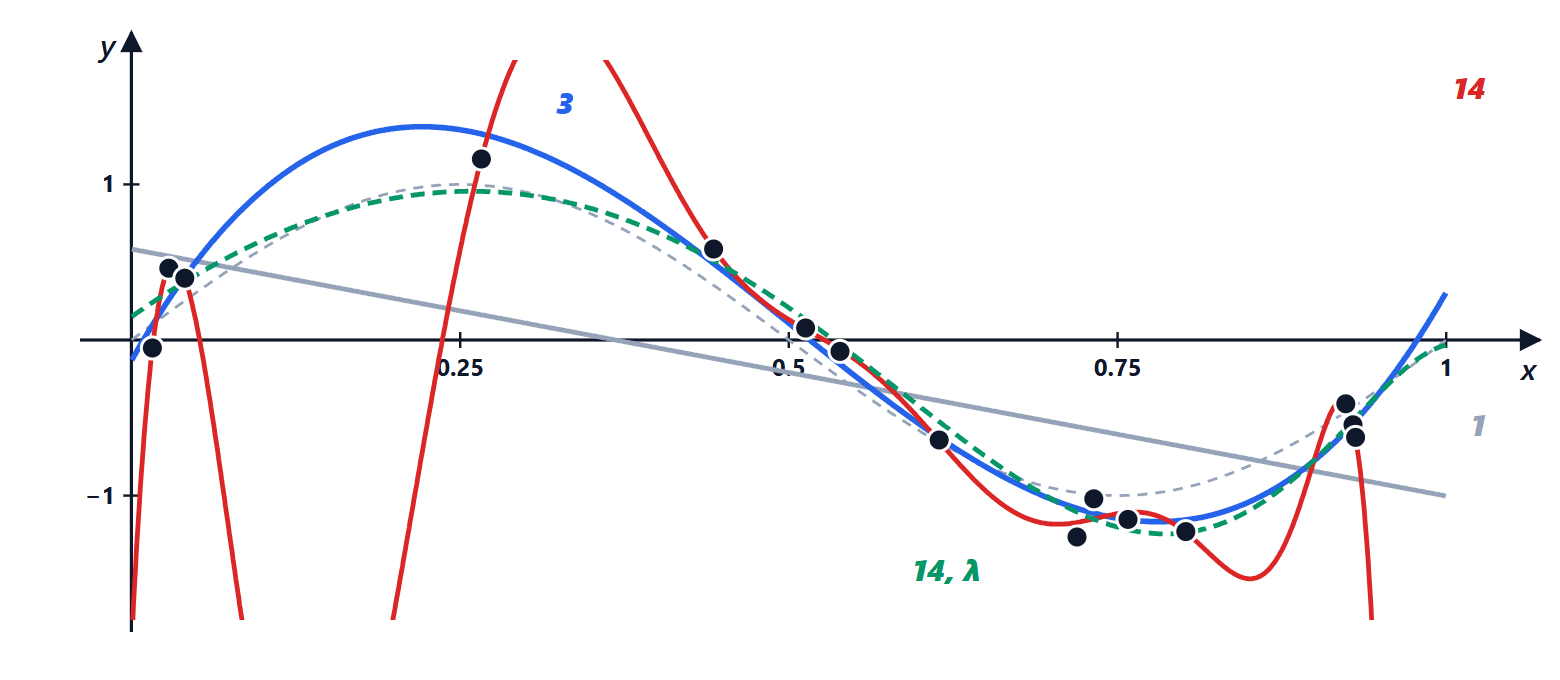
L’errore di addestramento scende sempre, quello sui dati nuovi prima scende poi esplode. Il grado 1 sottoadatta (troppo semplice: distorsione alta), il grado 14 sovradatta (troppo flessibile: varianza alta). È lo scambio tra distorsione e varianza: l’errore atteso su un punto nuovo si scompone in distorsione al quadrato, più varianza del modello al variare dei dati, più rumore irriducibile.
La regolarizzazione penalizza i pesi grandi: 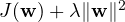 (ridge, o weight decay nelle reti), con soluzione
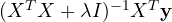 (stessa dimostrazione delle equazioni normali). Sul polinomio di grado 14 con
 l’errore sui dati nuovi scende da 50,2 a 0,069, meglio anche del grado 3. Il valore di
 si sceglie guardando l’insieme di validazione, mai quello di prova.
Il codice
import numpy as np

rng = np.random.default_rng(0)
x = rng.uniform(0, 1, 50)
y = 2 + 3 * x + rng.normal(0, 0.3, 50)
X = np.c_[np.ones(50), x]                                   # colonna di 1 per il termine noto

w_esatto = np.linalg.solve(X.T @ X, X.T @ y)                # equazioni normali
L = 2 * np.linalg.eigvalsh(X.T @ X / 50).max()              # autovalore massimo dell'hessiana
print("equazioni normali:", np.round(w_esatto, 4), " limite del passo 2/L =", round(2 / L, 3))
for eta in (0.5, 0.9 * 2 / L, 1.1 * 2 / L):
    w = np.zeros(2)
    for k in range(2000):
        w -= eta * 2 / 50 * X.T @ (X @ w - y)              # discesa del gradiente
    print(f"eta = {eta:.3f}:", np.round(w, 4) if np.all(np.isfinite(w)) else "diverge")

# sovradattamento: polinomi su 15 punti, errore su 200 punti nuovi
f = lambda t: np.sin(2 * np.pi * t)
xa = np.sort(rng.uniform(0, 1, 15)); ya = f(xa) + rng.normal(0, 0.2, 15)
xn = rng.uniform(0, 1, 200); yn = f(xn) + rng.normal(0, 0.2, 200)
def adatta(grado, lam=0.0):
    A = np.vander(xa, grado + 1, increasing=True)
    return np.linalg.solve(A.T @ A + lam * np.eye(grado + 1), A.T @ ya)     # ridge se lam > 0
def errore(c, xs, ys):
    return np.mean((np.vander(xs, len(c), increasing=True) @ c - ys) ** 2)
for grado, lam in ((1, 0), (3, 0), (9, 0), (14, 0), (14, 1e-3)):
    c = adatta(grado, lam)
    print(f"grado {grado:2d}, lambda {lam:g}: addestramento {errore(c, xa, ya):.4f}, dati nuovi {errore(c, xn, yn):.4f}")
L’esecuzione riproduce i numeri del testo. Le lezioni successive sostituiscono il modello lineare con le reti neurali, che restano addestrate con la discesa del gradiente e soffrono degli stessi problemi di sovradattamento.