Il percettrone e le reti a più strati: teorema di Novikoff, XOR e approssimazione universale
Il percettrone e il teorema di convergenza di Novikoff dimostrato, il problema dello XOR, le reti a più strati e le funzioni di attivazione, il teorema di approssimazione universale, un esperimento su 100 semi sulla dimensione della rete.
Una rete neurale è una funzione costruita componendo molte funzioni semplici, i neuroni: ognuno fa una somma pesata dei suoi ingressi e la fa passare per una funzione non lineare. Questa lezione parte dal neurone più semplice, il percettrone di Rosenblatt (1958), dimostra che impara in un numero finito di passi quando le classi sono separabili da una retta, mostra perché un solo strato non basta (il problema dello XOR) e introduce le reti a più strati, con il teorema di approssimazione universale e un esperimento che mostra quanto conta la dimensione della rete.
Il percettrone
Il percettrone classifica un ingresso  in due classi,
 e
 , con il segno di una somma pesata:
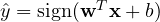 . Geometricamente, il confine tra le classi è l’iperpiano
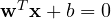 (una retta in due dimensioni). L’algoritmo di apprendimento è semplicissimo: si scorrono gli esempi e, quando uno è classificato male, si sposta il vettore dei pesi verso di esso,
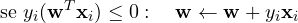
(il termine noto  si include in
 aggiungendo a una componente costante 1).
Teorema (Novikoff, 1962). Se esiste un vettore unitario  che separa i dati con margine
 , cioè
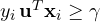 per ogni
 , e
 , il percettrone fa al più
 correzioni.
Dimostrazione. Si seguono due quantità dopo  correzioni, partendo da
 . La proiezione su cresce di almeno
 a ogni correzione:
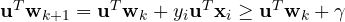 , quindi
 . La norma invece cresce poco:
 , perché la correzione avviene solo se
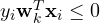 ; quindi
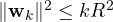 . Per la disuguaglianza di Cauchy-Schwarz
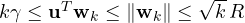 , cioè
 . ∎
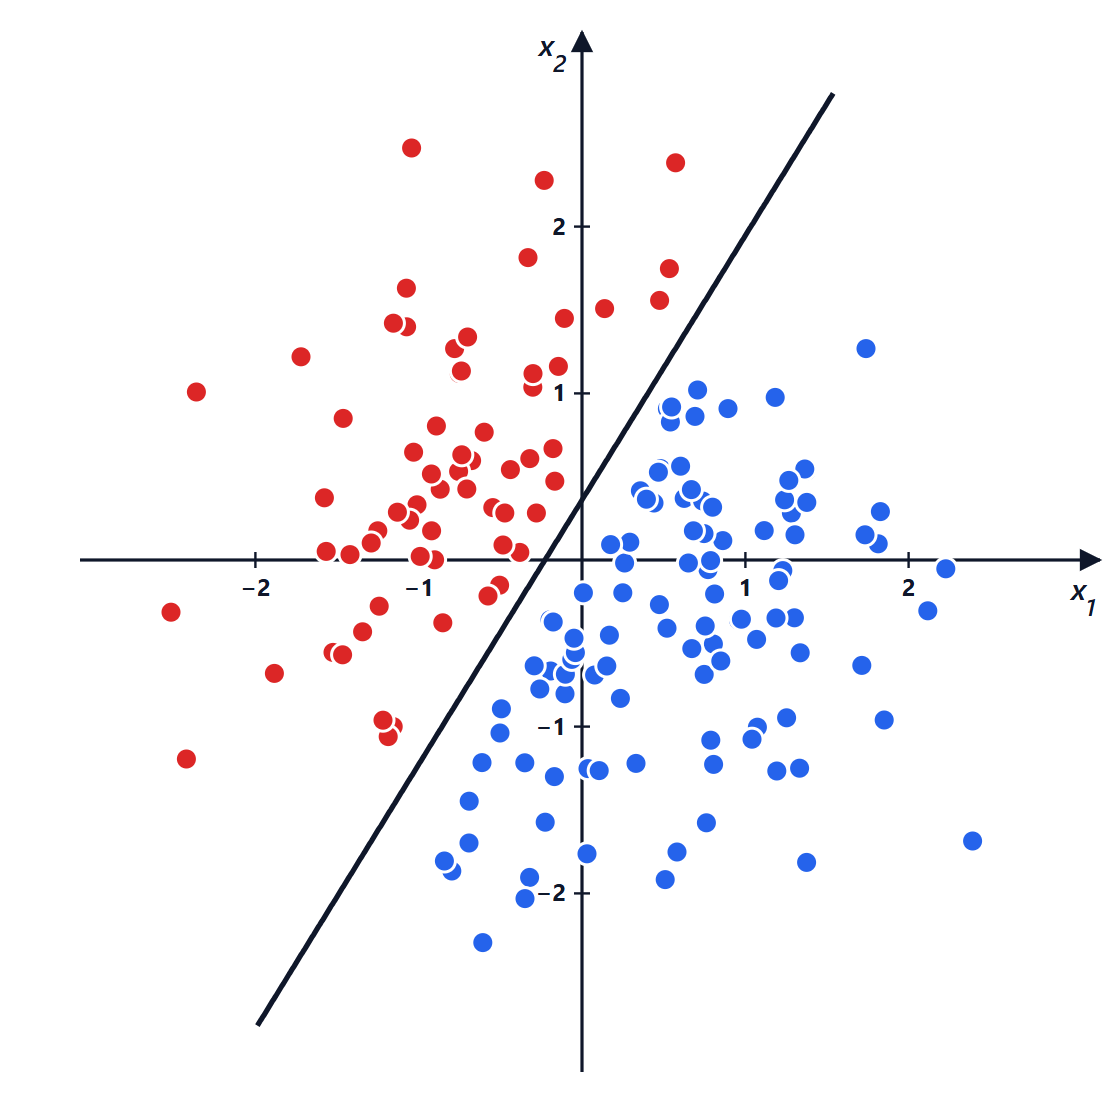
Il limite non dipende né dal numero di esempi né dalla dimensione dello spazio, solo da quanto le classi sono “lontane” rispetto alla loro estensione. In un esperimento con 167 punti separabili con margine 0,15, il percettrone ha fatto 11 correzioni in 3 passate sui dati; il limite di Novikoff era 421: il teorema è un caso peggiore, la pratica va di solito molto meglio.
Il limite di uno strato: lo XOR
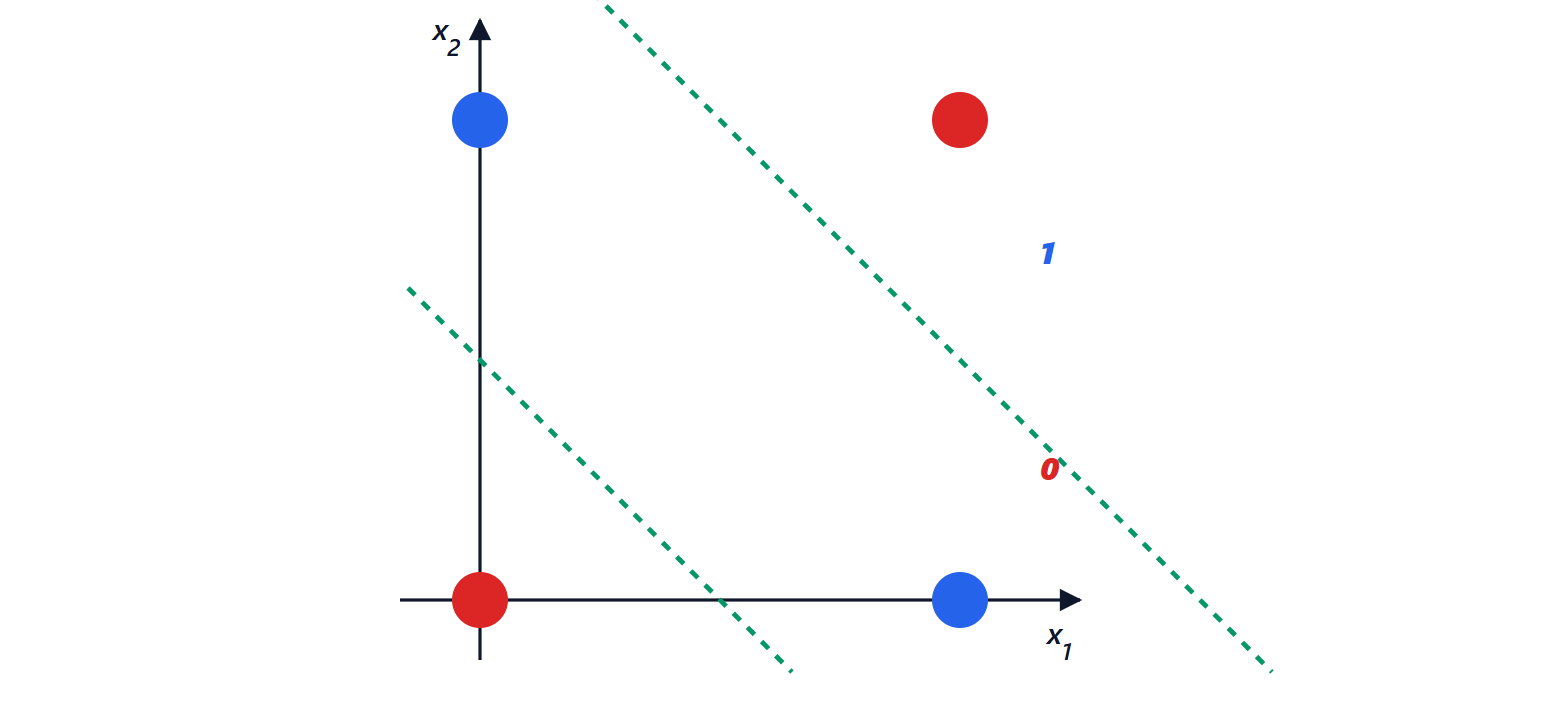
Il percettrone trova una retta, ma molti problemi non si separano con una retta. Il più semplice è lo XOR (o esclusivo): l’uscita è 1 se esattamente uno dei due ingressi è 1. I punti (0, 1) e (1, 0) devono stare da una parte, (0, 0) e (1, 1) dall’altra: nessuna retta ci riesce. Minsky e Papert lo fecero notare nel 1969, e la ricerca sulle reti neurali rallentò per anni.
La soluzione è aggiungere uno strato nascosto: i neuroni nascosti trasformano gli ingressi in nuove variabili in cui il problema diventa separabile. Con due neuroni nascosti basta: uno può calcolare “almeno uno è 1” (OR), l’altro “entrambi sono 1” (AND), e l’uscita “OR ma non AND”.
Le reti a più strati
Una rete a più strati (multilayer perceptron, MLP) applica in sequenza trasformazioni lineari e non linearità:
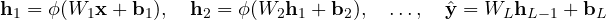
La funzione di attivazione  è essenziale: senza, la composizione di trasformazioni lineari è ancora lineare e la rete non sarebbe più potente di un solo strato. Le più usate:
- sigmoide
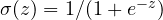 e tangente iperbolica
 : lisce, ma “saturano” per
 grande, dove la derivata è quasi nulla;
- ReLU
 : semplicissima, derivata 1 per
 , non satura in una direzione. È la scelta predefinita dal 2012;
- varianti lisce come GELU e SiLU, usate nei transformer.
Teorema di approssimazione universale (Cybenko 1989, Hornik 1991). Una rete con un solo strato nascosto e attivazione non polinomiale può approssimare con errore arbitrariamente piccolo qualunque funzione continua su un insieme chiuso e limitato, purché abbia abbastanza neuroni.
Idea della dimostrazione (per una variabile, con la sigmoide). Una sigmoide molto ripida 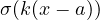 è quasi un gradino in
 ; la differenza di due gradini è un “rettangolo” tra e
 . Una funzione continua si approssima con una funzione a scalini (somme di rettangoli) con errore piccolo quanto si vuole, restringendo gli scalini; ogni rettangolo costa due neuroni. ∎
Il teorema dice che la rete può rappresentare la funzione, non che la discesa del gradiente la troverà, né quanti neuroni servono (possono essere moltissimi). In pratica le reti profonde, con molti strati di larghezza moderata, rappresentano le funzioni utili con molti meno parametri di una rete larga e poco profonda: ogni strato costruisce caratteristiche più astratte a partire da quelle dello strato precedente.
Un esperimento: quanto deve essere grande la rete
Si addestra lo XOR con la discesa del gradiente partendo da pesi casuali, ripetendo con 100 semi diversi, e si conta quante volte la rete impara davvero la funzione:
| neuroni nascosti | XOR risolto |
|---|---|
| 2 | 49 volte su 100 |
| 3 | 92 volte su 100 |
| 4 | 98 volte su 100 |
Con due neuroni nascosti la soluzione esiste, ma metà delle volte la discesa del gradiente si ferma in un minimo locale (per esempio con uscita 0,5 su due dei quattro casi). Aggiungendo neuroni, il paesaggio dell’errore diventa più facile da percorrere e quasi tutti i punti di partenza portano a una soluzione. È uno dei motivi per cui le reti moderne hanno molti più parametri di quanti ne servirebbero in teoria.
import numpy as np

X = np.array([[0, 0], [0, 1], [1, 0], [1, 1]], float)
y = np.array([0, 1, 1, 0], float)                          # XOR
sig = lambda z: 1 / (1 + np.exp(-z))

def addestra(nascosti, seme, passi=10000, eta=0.5):
    g = np.random.default_rng(seme)
    W1, b1 = g.normal(0, 1, (2, nascosti)), np.zeros(nascosti)
    W2, b2 = g.normal(0, 1, nascosti), 0.0
    for _ in range(passi):
        h = np.tanh(X @ W1 + b1)                           # strato nascosto
        uscita = sig(h @ W2 + b2)
        d2 = uscita - y                                    # gradiente di entropia incrociata + sigmoide
        dh = np.outer(d2, W2) * (1 - h ** 2)               # derivata della tanh
        W2 -= eta * h.T @ d2; b2 -= eta * d2.sum()
        W1 -= eta * X.T @ dh; b1 -= eta * dh.sum(0)
    return sig(np.tanh(X @ W1 + b1) @ W2 + b2)

for nascosti in (2, 3, 4):
    riusciti = sum(np.all(np.abs(addestra(nascosti, s) - y) < 0.1) for s in range(100))
    print(f"{nascosti} neuroni nascosti: XOR risolto {riusciti} volte su 100")
print("esempio con 3 neuroni:", np.round(addestra(3, 0), 3))
Il calcolo dei gradienti scritto a mano qui, per uno strato nascosto, si generalizza a qualunque numero di strati con la retropropagazione, oggetto della lezione successiva.