Sequenze: reti ricorrenti, gradiente che svanisce, LSTM, attenzione e transformer
Le reti ricorrenti e la retropropagazione nel tempo, il gradiente che svanisce dimostrato e misurato, la LSTM, l'attenzione con la dimostrazione della divisione per la radice di d_k, il transformer e la codifica della posizione.
Testi, segnali audio, serie temporali di sensori, traiettorie: molti dati sono sequenze, in cui conta l’ordine e la lunghezza varia. Questa lezione presenta le due famiglie di reti per le sequenze. Le reti ricorrenti (RNN) leggono un elemento alla volta e portano con sé uno stato; si dimostra perché il loro gradiente svanisce sulle sequenze lunghe e come le LSTM lo evitano. I transformer (2017) guardano tutta la sequenza insieme con il meccanismo dell’attenzione; si dimostra perché il prodotto scalare va diviso per  . I transformer sono oggi la base dei modelli linguistici e si usano sempre più anche per immagini e segnali.
Le reti ricorrenti
Una RNN aggiorna uno stato nascosto  a ogni elemento
 della sequenza, con gli stessi pesi a ogni passo:
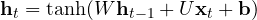
È un sistema dinamico non lineare a tempo discreto, come quelli di Teoria dei sistemi, con i parametri imparati. Per addestrarla si “srotola” la rete nel tempo (una copia per passo) e si applica la retropropagazione: è la retropropagazione nel tempo (BPTT).
Teorema (il gradiente che svanisce o esplode). 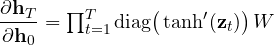 , quindi
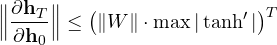 .
Dimostrazione. Per la regola della catena 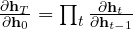 , e derivando
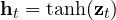 con
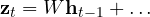 si ottiene
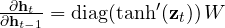 . La norma di un prodotto è al più il prodotto delle norme, e
 . ∎
Se 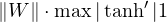 il gradiente cala esponenzialmente con la distanza: la rete non riesce a imparare che un ingresso lontano nel passato determina l’uscita di oggi. Se è maggiore di 1 può esplodere (lo si limita tagliando la norma del gradiente, come nel PPO).
La LSTM
La LSTM (long short-term memory, Hochreiter e Schmidhuber, 1997) aggiunge una cella di memoria  controllata da tre porte (valori tra 0 e 1 dati da sigmoidi):
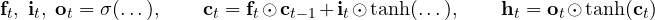
La porta di oblio  decide quanto della memoria tenere, quella d’ingresso
 quanto scriverci, quella d’uscita
 quanto mostrarne. Il punto chiave è che la cella si aggiorna per somma:
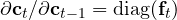 , senza moltiplicazioni per
 né derivate di funzioni che saturano. Se la rete impara
 , il gradiente attraversa molti passi quasi intatto. La GRU (2014) è una variante più semplice con due porte.
La misura. Per reti appena inizializzate (stato di 32 neuroni, media su 10 inizializzazioni) si calcola con la differenziazione automatica quanto l’uscita all’ultimo passo dipende dal primo ingresso:
lunghezza  | RNN | LSTM |
|---|---|---|
| 1 |  |  |
| 10 |  |  |
| 20 |  |  |
| 50 |  |  |
| 100 |  |  |
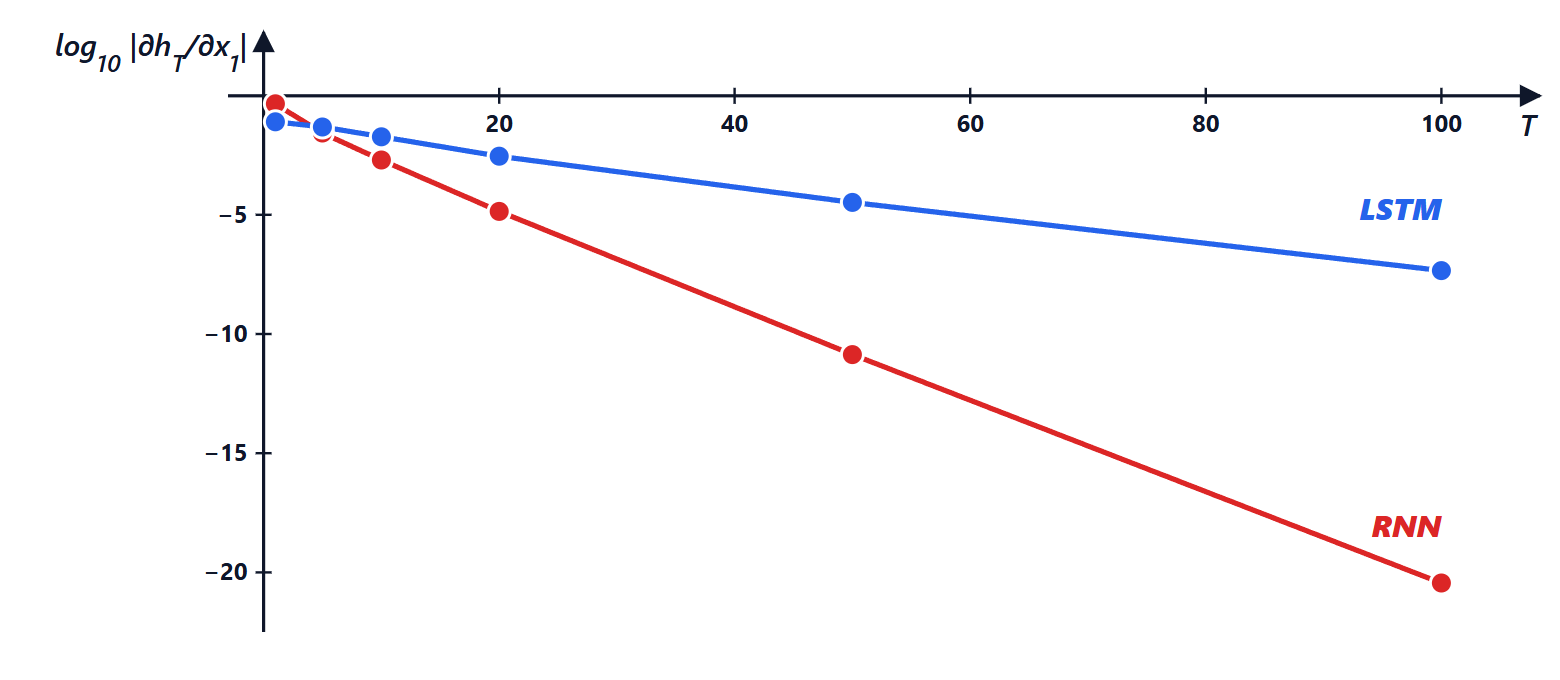
Nella RNN il segnale si riduce di circa un fattore 0,6 a ogni passo (la retta in scala logaritmica); dopo 100 passi è  volte più debole che nella LSTM.
L’attenzione
Anche la LSTM fatica oltre qualche centinaio di passi, e soprattutto lavora in sequenza: il passo  aspetta il passo
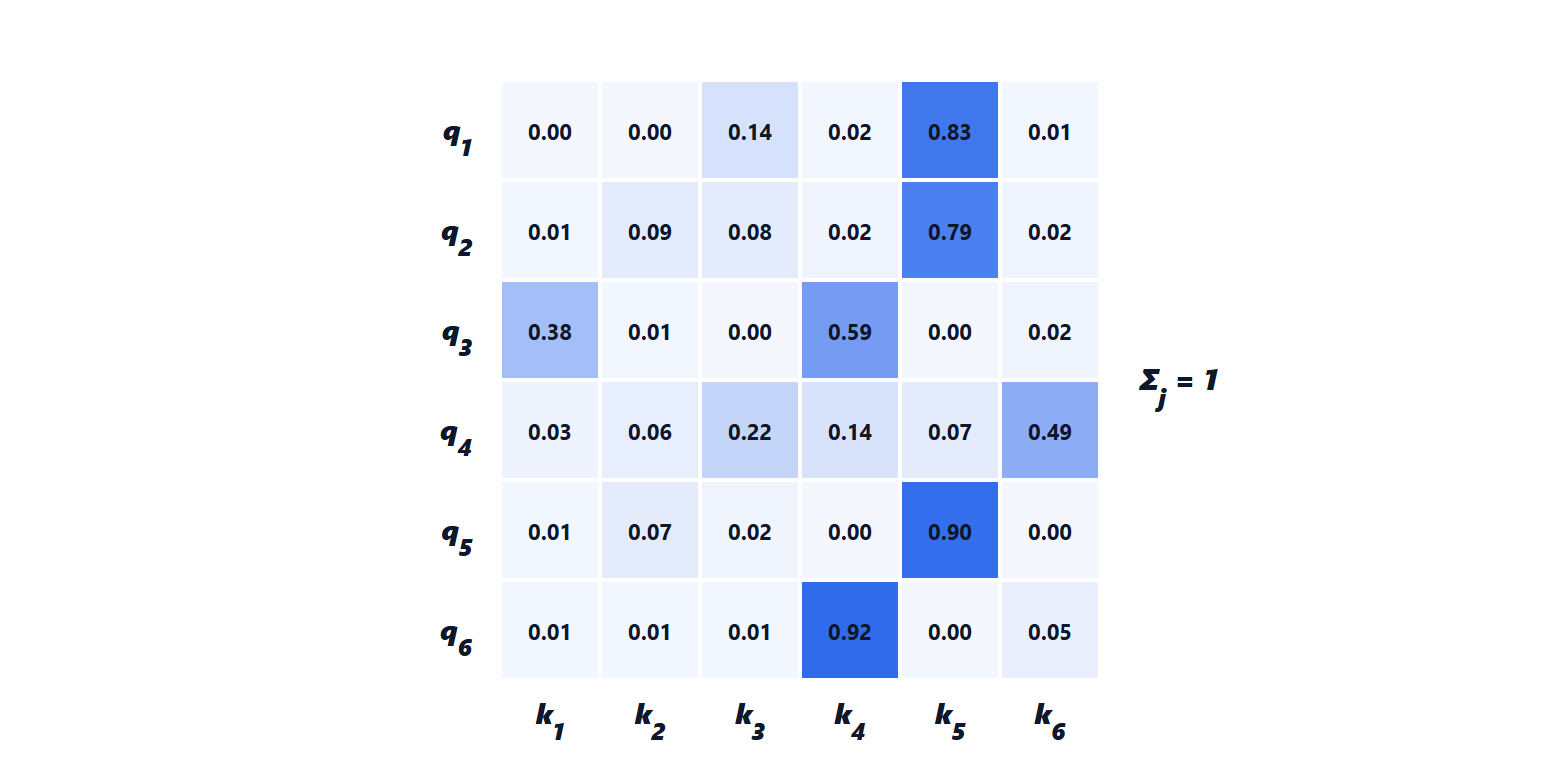
 , e non si può parallelizzare sulla GPU. L’attenzione collega direttamente ogni posizione con tutte le altre. Ogni elemento produce tre vettori: una domanda (query)
 , una chiave (key)
 e un valore (value)
 , con matrici di pesi imparate. L’uscita per una posizione è una media dei valori di tutte le posizioni, pesata da quanto la sua domanda “somiglia” a ciascuna chiave:
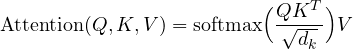
dove le righe di  sono le domande, le chiavi e i valori delle
 posizioni, e
 è la dimensione delle chiavi.
Teorema (perché si divide per ). Se le componenti di e sono indipendenti con media 0 e varianza 1, il prodotto scalare  ha media 0 e varianza .
Dimostrazione. 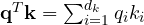 . Ogni termine ha media
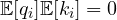 e varianza
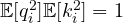 ; i termini sono indipendenti, quindi le varianze si sommano: . ∎
Con  i punteggi avrebbero deviazione standard circa 23: la softmax di numeri così grandi è quasi un “uno solo, tutti gli altri zero”, e il suo gradiente è quasi nullo. Dividendo per la varianza torna 1. In simulazione (codice in fondo): varianza 4,0, 64,0 e 509 per
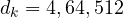 , e 1,00, 1,00, 0,99 dopo la divisione.
Il transformer
Il transformer (Vaswani e altri, 2017, “Attention is all you need”) impila blocchi uguali, ognuno con:
- attenzione a più teste: diverse attenzioni in parallelo, con matrici diverse, che possono specializzarsi (una segue la sintassi, un’altra i riferimenti);
- una piccola rete densa applicata a ogni posizione separatamente;
- connessioni residue e normalizzazione (layer norm) intorno a entrambi, come nelle ResNet.
L’attenzione non sa niente dell’ordine (permutando le posizioni le uscite si permutano allo stesso modo), quindi si aggiunge agli ingressi una codifica della posizione: nel lavoro originale sinusoidi di frequenze diverse, oggi spesso rotazioni (RoPE). Il costo dell’attenzione cresce come  con la lunghezza della sequenza, ed è il limite principale dei modelli con contesti lunghi. In cambio tutte le posizioni si calcolano in parallelo, ed è questo, più di ogni altra cosa, che ha permesso di addestrare modelli con centinaia di miliardi di parametri. Per generare testo si usa una maschera causale: ogni posizione può guardare solo quelle precedenti, e il modello impara a prevedere la parola successiva.
Il codice
import numpy as np
import torch, torch.nn as nn

# 1) attenzione in NumPy
def attenzione(Q, K, V):
    punteggi = Q @ K.T / np.sqrt(K.shape[1])
    pesi = np.exp(punteggi - punteggi.max(1, keepdims=True))
    pesi /= pesi.sum(1, keepdims=True)                     # softmax per righe
    return pesi @ V, pesi

g = np.random.default_rng(0)
X = g.normal(0, 1, (6, 16))                                # 6 posizioni, 16 dimensioni
Wq, Wk, Wv = (g.normal(0, 0.25, (16, 8)) for _ in range(3))
uscita, pesi = attenzione(X @ Wq, X @ Wk, X @ Wv)
print("uscita", uscita.shape, "- le righe dei pesi sommano a", np.round(pesi.sum(1), 6))

# 2) varianza del prodotto scalare prima e dopo la divisione per sqrt(d_k)
for dk in (4, 64, 512):
    q, k = g.normal(0, 1, (20000, dk)), g.normal(0, 1, (20000, dk))
    s = (q * k).sum(1)
    print(f"d_k = {dk:3d}: varianza {s.var():6.1f}, dopo la divisione {(s / np.sqrt(dk)).var():.3f}")

# 3) sensibilità dell'ultima uscita al primo ingresso, RNN contro LSTM appena inizializzate
def sensibilita(tipo, T, H=32, inizializzazioni=10):
    valori = []
    for s in range(inizializzazioni):
        torch.manual_seed(s)
        rete = (nn.RNN if tipo == "rnn" else nn.LSTM)(1, H, batch_first=True)
        if tipo == "lstm":                                 # porta di oblio inizialmente aperta (bias 1)
            for nome, p in rete.named_parameters():
                if "bias_ih" in nome:
                    p.data[H:2 * H] = 1.0
        x = torch.randn(1, T, 1, requires_grad=True)
        uscite, _ = rete(x)
        uscite[0, -1].sum().backward()
        valori.append(x.grad[0, 0].abs().item())
    return sum(valori) / len(valori)

for T in (1, 10, 20, 50, 100):
    print(f"T = {T:3d}: RNN {sensibilita('rnn', T):.1e}, LSTM {sensibilita('lstm', T):.1e}")