Progetto: riconoscere le cifre scritte a mano in NumPy e PyTorch, fino a ONNX e alla quantizzazione a 8 bit
Una rete scritta da zero in NumPy e la stessa in PyTorch sulle cifre 8x8 (98 % di accuratezza), matrice di confusione e analisi degli errori, esportazione ONNX e quantizzazione dei pesi a 8 bit per i microcontrollori.
https://www.electronics-engineering.com/progetto-rete-neurale-cifre-numpy-pytorch-onnx-quantizzazione
Questa lezione mette insieme tutto il corso in un progetto completo e funzionante: riconoscere le cifre scritte a mano. Si scrive prima la rete da zero in NumPy, con la retropropagazione della lezione 3, poi la stessa rete in PyTorch, dove i gradienti li calcola la differenziazione automatica; si valuta il risultato con la matrice di confusione e si guardano gli errori; infine si prepara il modello per l’uso fuori da Python (formato ONNX) e per un microcontrollore, con la quantizzazione dei pesi a 8 bit. Tutti i numeri riportati vengono dall’esecuzione del codice in fondo alla pagina.
I dati
La raccolta di scikit-learn contiene 1797 cifre scritte a mano da 43 persone, ridotte a immagini di 8×8 pixel con 17 livelli di grigio (da 0 a 16): piccola abbastanza da addestrare una rete in un secondo su un portatile, ma un problema vero, con calligrafie diverse. I valori si dividono per 16 (ingressi tra 0 e 1, lezione 7) e i dati si dividono in 1347 esempi di addestramento e 450 di prova, stratificati (ogni cifra nella stessa proporzione nei due insiemi) e con un seme fisso, così che il risultato sia riproducibile.
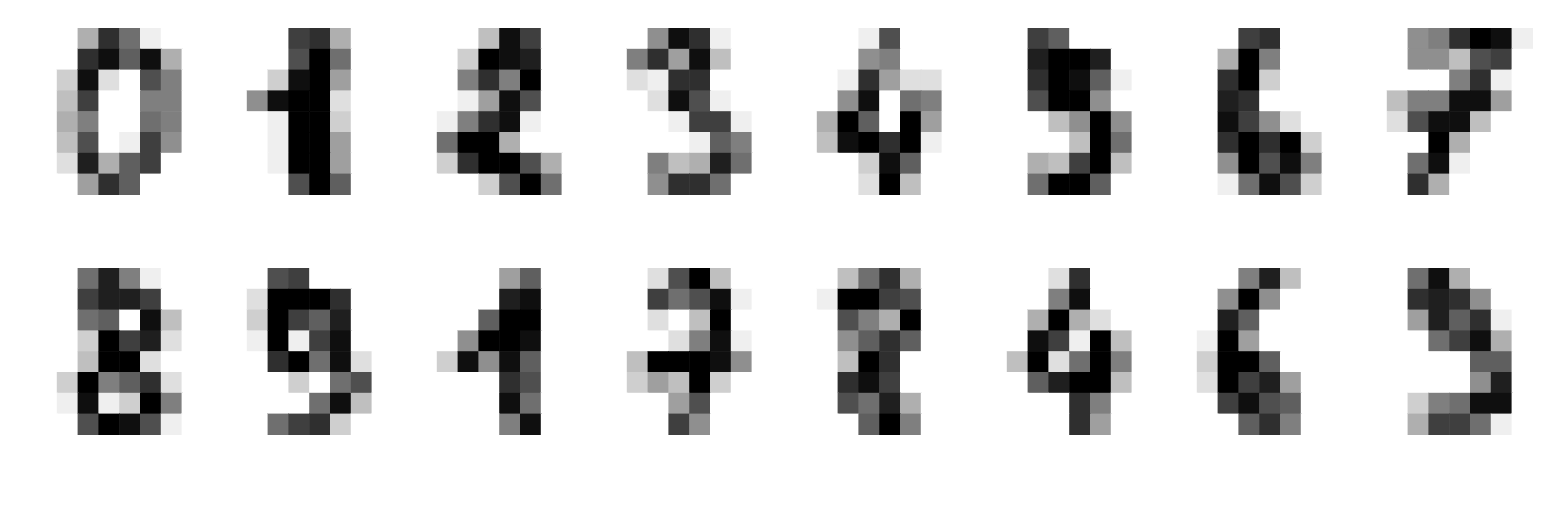
La rete in NumPy
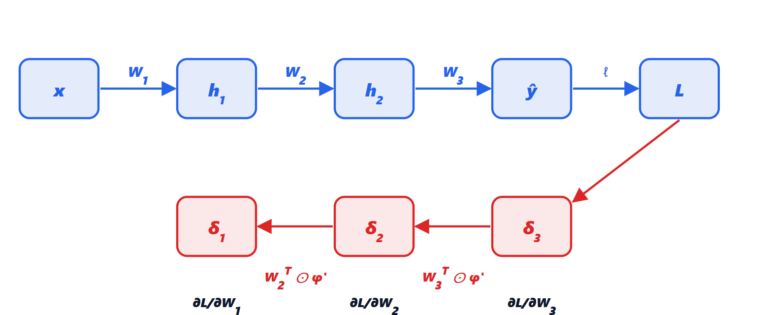
Architettura 64 → 64 → 10: 64 ingressi (i pixel), uno strato nascosto di 64 neuroni ReLU, 10 uscite con softmax. Pesi inizializzati con la regola di He (lezione 7), entropia incrociata, discesa del gradiente stocastica con lotti di 32 esempi e passo 0,1 per 100 epoche. Il ciclo di addestramento è la traduzione diretta delle equazioni della retropropagazione:  , gradienti dell’ultimo strato
 ,
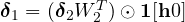 , gradienti del primo strato
 . Risultato: 98,0 % di accuratezza sulla prova, in 0,3-0,4 secondi.
La stessa rete in PyTorch
In PyTorch la rete si dichiara come sequenza di strati, e il gradiente lo calcola loss.backward(). Con la stessa architettura, lo stesso ottimizzatore e gli stessi iperparametri si ottiene 97,8 %: la piccola differenza (un esempio su 450) viene dall’inizializzazione casuale diversa (PyTorch usa per default una distribuzione uniforme scalata) e dall’ordine dei lotti. Per una rete così piccola PyTorch è anche più lento di NumPy (1,6 s): il vantaggio vero arriva con reti grandi, sulla GPU, e con architetture complicate di cui nessuno vorrebbe scrivere le derivate a mano.
La matrice di confusione
Righe: cifra vera; colonne: cifra prevista dalla rete PyTorch. Sulla diagonale le risposte giuste:
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | |
|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 45 | |||||||||
| 1 | 45 | 1 | ||||||||
| 2 | 1 | 43 | ||||||||
| 3 | 46 | |||||||||
| 4 | 1 | 43 | 1 | |||||||
| 5 | 1 | 1 | 44 | |||||||
| 6 | 1 | 44 | ||||||||
| 7 | 45 | |||||||||
| 8 | 2 | 41 | ||||||||
| 9 | 1 | 44 |
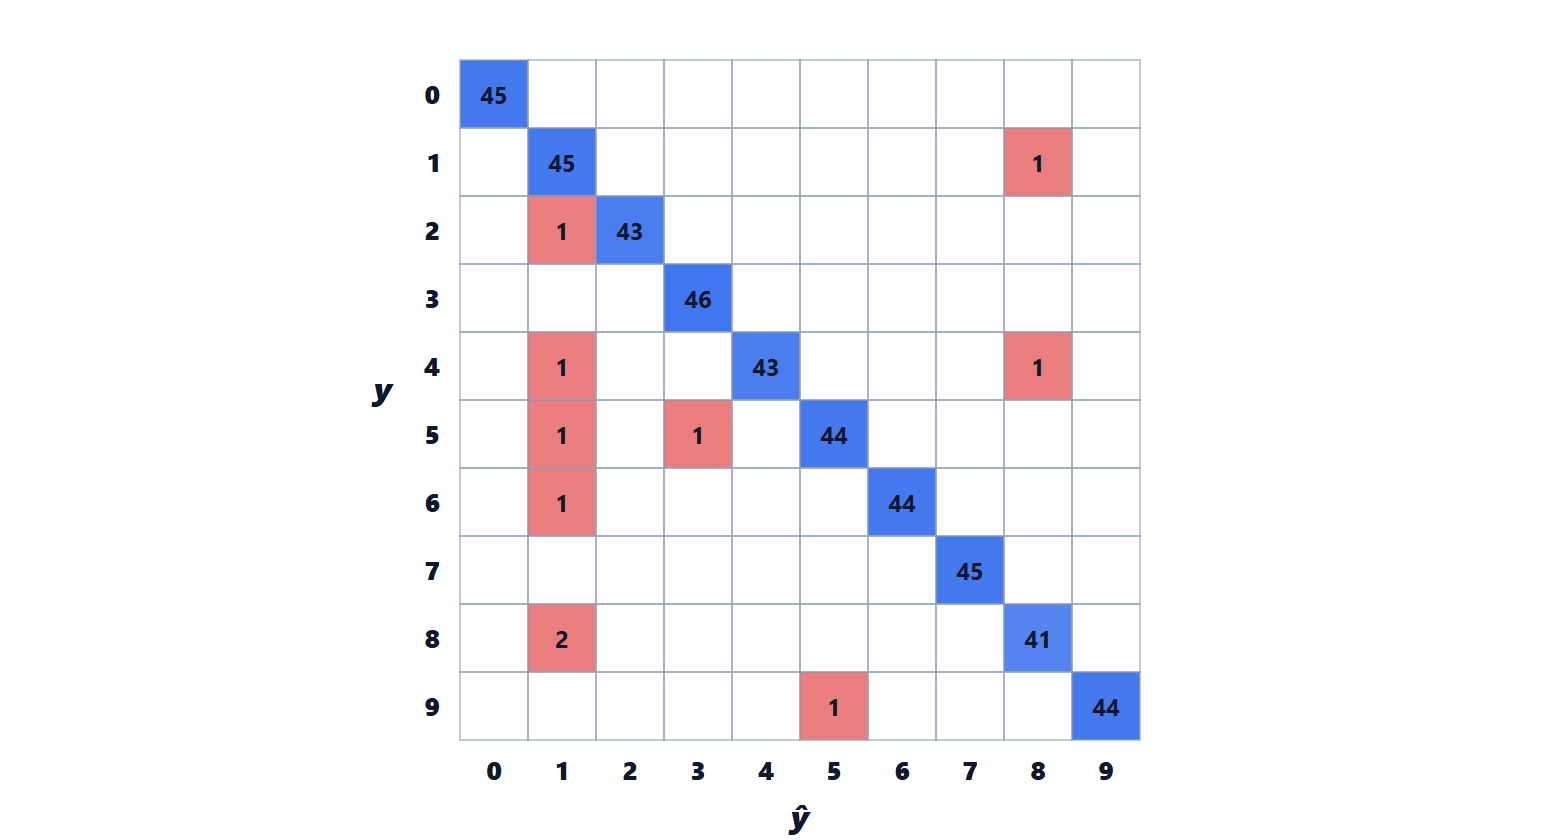
Dieci errori su 450, e la metà finisce nella colonna dell’1: a 8×8 pixel un tratto verticale un po’ spesso basta a far sembrare 1 un 8, un 4 o un 6. Guardare dove sbaglia un modello è il passo più utile per migliorarlo: qui suggerirebbe immagini a risoluzione più alta, una CNN (lezione 5), o più esempi delle coppie confuse.
Dal modello al prodotto
- Salvataggio:
torch.savesalva i pesi; per ricaricarli serve lo stesso codice della rete. - ONNX (Open Neural Network Exchange):
torch.onnx.exportsalva rete e pesi in un formato standard, che si esegue con ONNX Runtime in C++, C#, Java o JavaScript, su server, telefoni o nel browser, senza Python. - Microcontrollori: una rete si esegue anche su un microcontrollore con poche centinaia di kilobyte di memoria (TensorFlow Lite for Microcontrollers, o codice C generato da strumenti come STM32Cube.AI). Il passo decisivo è la quantizzazione: i pesi diventano interi a 8 bit,
 con
 tra −127 e 127 e una scala
 per matrice. La memoria dei pesi si riduce di quattro volte e i calcoli diventano operazioni intere, molto più veloci e meno costose in energia. Sulla rete delle cifre la memoria dei pesi scende da 18 944 a 4 736 byte e l’accuratezza non cambia (97,8 %). Su reti più grandi la perdita è di solito di qualche decimo di punto; quando è troppa, si addestra tenendo conto della quantizzazione (quantization-aware training).
Il codice completo
import time
import numpy as np
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split

# dati: 1797 cifre scritte a mano, 8x8 pixel con valori 0..16
d = load_digits()
Xtr, Xte, ytr, yte = train_test_split(d.data / 16.0, d.target, test_size=0.25, random_state=0, stratify=d.target)

# ---------------- rete da zero in NumPy: 64 -> 64 (ReLU) -> 10 (softmax) ----------------
rng = np.random.default_rng(0)
W1 = rng.normal(0, np.sqrt(2 / 64), (64, 64)); b1 = np.zeros(64)       # inizializzazione di He
W2 = rng.normal(0, np.sqrt(2 / 64), (64, 10)); b2 = np.zeros(10)

def forward(X):
    z1 = X @ W1 + b1
    h = np.maximum(z1, 0)
    z2 = h @ W2 + b2
    p = np.exp(z2 - z2.max(1, keepdims=True))
    return h, p / p.sum(1, keepdims=True)

t0 = time.time()
LR, EPOCHS, BATCH = 0.1, 100, 32
for epoch in range(EPOCHS):
    perm = rng.permutation(len(Xtr))
    for i in range(0, len(Xtr), BATCH):
        idx = perm[i:i + BATCH]
        X, y = Xtr[idx], ytr[idx]
        h, p = forward(X)
        d2 = p.copy(); d2[np.arange(len(y)), y] -= 1; d2 /= len(y)    # gradiente di softmax + entropia incrociata
        gW2, gb2 = h.T @ d2, d2.sum(0)
        d1 = (d2 @ W2.T) * (h > 0)                                    # retropropagazione attraverso la ReLU
        gW1, gb1 = X.T @ d1, d1.sum(0)
        W1 -= LR * gW1; b1 -= LR * gb1; W2 -= LR * gW2; b2 -= LR * gb2
acc_np = (forward(Xte)[1].argmax(1) == yte).mean()
print(f"NumPy: accuratezza di prova {acc_np:.4f} in {time.time() - t0:.1f} s")

# ---------------- la stessa rete in PyTorch ----------------
import torch
import torch.nn as nn

torch.manual_seed(0)
model = nn.Sequential(nn.Linear(64, 64), nn.ReLU(), nn.Linear(64, 10))
opt = torch.optim.SGD(model.parameters(), lr=LR)
Xt, yt = torch.tensor(Xtr, dtype=torch.float32), torch.tensor(ytr)
t0 = time.time()
for epoch in range(EPOCHS):
    perm = torch.randperm(len(Xt))
    for i in range(0, len(Xt), BATCH):
        idx = perm[i:i + BATCH]
        loss = nn.functional.cross_entropy(model(Xt[idx]), yt[idx])  # il gradiente lo calcola autograd
        opt.zero_grad(); loss.backward(); opt.step()
with torch.no_grad():
    pred = model(torch.tensor(Xte, dtype=torch.float32)).argmax(1).numpy()
print(f"PyTorch: accuratezza di prova {(pred == yte).mean():.4f} in {time.time() - t0:.1f} s")

# matrice di confusione: righe = cifra vera, colonne = cifra prevista
conf = np.zeros((10, 10), int)
for t, q in zip(yte, pred):
    conf[t, q] += 1
print(conf)

# quantizzazione a 8 bit dei pesi (simmetrica, una scala per matrice), come sui microcontrollori
qmodel = nn.Sequential(nn.Linear(64, 64), nn.ReLU(), nn.Linear(64, 10))
qmodel.load_state_dict(model.state_dict())
with torch.no_grad():
    for layer in (qmodel[0], qmodel[2]):
        scala = layer.weight.abs().max() / 127                         # il peso più grande diventa 127
        q = torch.round(layer.weight / scala).clamp(-127, 127)          # interi da -127 a 127
        layer.weight.copy_(q * scala)                                   # valori che la rete vede davvero
    qpred = qmodel(torch.tensor(Xte, dtype=torch.float32)).argmax(1).numpy()
print(f"pesi a 8 bit: accuratezza di prova {(qpred == yte).mean():.4f}, memoria dei pesi {sum(p.numel() for p in model.parameters() if p.dim() == 2)} byte invece di {4 * sum(p.numel() for p in model.parameters() if p.dim() == 2)}")
torch.save(model.state_dict(), "cifre.pt")
torch.onnx.export(model, torch.zeros(1, 64), "cifre.onnx")                  # per usarla fuori da Python
Che cosa viene dopo
Il corso ha costruito tutti i pezzi: discesa del gradiente, reti a più strati, retropropagazione, ottimizzatori, convoluzioni, sequenze e attenzione, pratica dell’addestramento. Le stesse idee, scalate di molti ordini di grandezza, sono quelle dei modelli di visione e dei modelli linguistici. Il corso di apprendimento per rinforzo mostra come le reti imparano a decidere invece che a riconoscere, con un ambiente al posto dei dati etichettati.


Sono l'autore di questa pagina su «Progetto: riconoscere le cifre scritte a mano in NumPy e PyTorch, fino a ONNX e alla quantizzazione a 8 bit». Se qualcosa non è chiaro, se vi serve un esempio in più o volete approfondire un punto, scrivetelo qui sotto nei commenti: rispondo personalmente. Se la pagina vi è stata utile, lasciate un voto con le stelle in cima all'articolo.I am the author of this page on “Project: recognising handwritten digits in NumPy and PyTorch, up to ONNX and 8-bit quantisation”. If something is unclear, if you need another example or want to go deeper into a point, write it in the comments below: I answer personally. If the page was useful, leave a star rating at the top of the article.