L’addestramento in pratica: dati, inizializzazione di He, normalizzazione, dropout e metriche
Addestramento, validazione e prova, l'inizializzazione di He dimostrata e misurata su 20 strati, batch e layer normalization, dropout, quantità di dati, precisione, richiamo e F1, ricerca degli iperparametri, con esperimenti onesti.
https://www.electronics-engineering.com/addestramento-in-pratica-inizializzazione-dropout-metriche
Tra la teoria delle lezioni precedenti e una rete che funziona davvero ci sono molte scelte pratiche: come dividere i dati, come inizializzare i pesi, come normalizzare, come evitare il sovradattamento, come misurare il risultato. Questa lezione le presenta con le ragioni matematiche e con esperimenti misurati, compresi quelli che non confermano le aspettative: nell’addestramento delle reti molti “trucchi” funzionano su alcuni problemi e non su altri, e l’unico modo di saperlo è misurare.
Dividere i dati
I dati si dividono in tre parti: addestramento (per i pesi), validazione (per le scelte: dimensione della rete, passo, regolarizzazione, quando fermarsi) e prova (test), usata una sola volta alla fine per stimare le prestazioni su dati nuovi. Se si fanno scelte guardando la prova, la prova diventa una seconda validazione e la stima è ottimistica. Con pochi dati si usa la validazione incrociata: si divide l’insieme in  parti, si addestra volte lasciandone fuori una diversa e si fa la media. Due avvertenze pratiche: la divisione va fatta prima di ogni normalizzazione (media e varianza si calcolano solo sull’addestramento), e per dati nel tempo (serie di sensori) la prova deve essere dopo l’addestramento, non mescolata.
L’inizializzazione dei pesi
Se i pesi iniziali sono troppo piccoli le attivazioni (e i gradienti) si spengono strato dopo strato; se sono troppo grandi esplodono. L’inizializzazione giusta mantiene costante la varianza.
Teorema (inizializzazione di He, 2015). In una rete con attivazioni ReLU, pesi indipendenti a media nulla e  ingressi per neurone, la varianza delle somme pesate resta costante da uno strato all’altro se
 .
Dimostrazione. Per un neurone  con
 indipendenti da
 e a media nulla,
 . Con
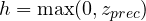 e
 simmetrico rispetto allo zero, la ReLU lascia passare metà della distribuzione:
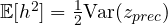 . Quindi
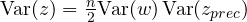 , che resta uguale se
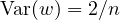 . ∎
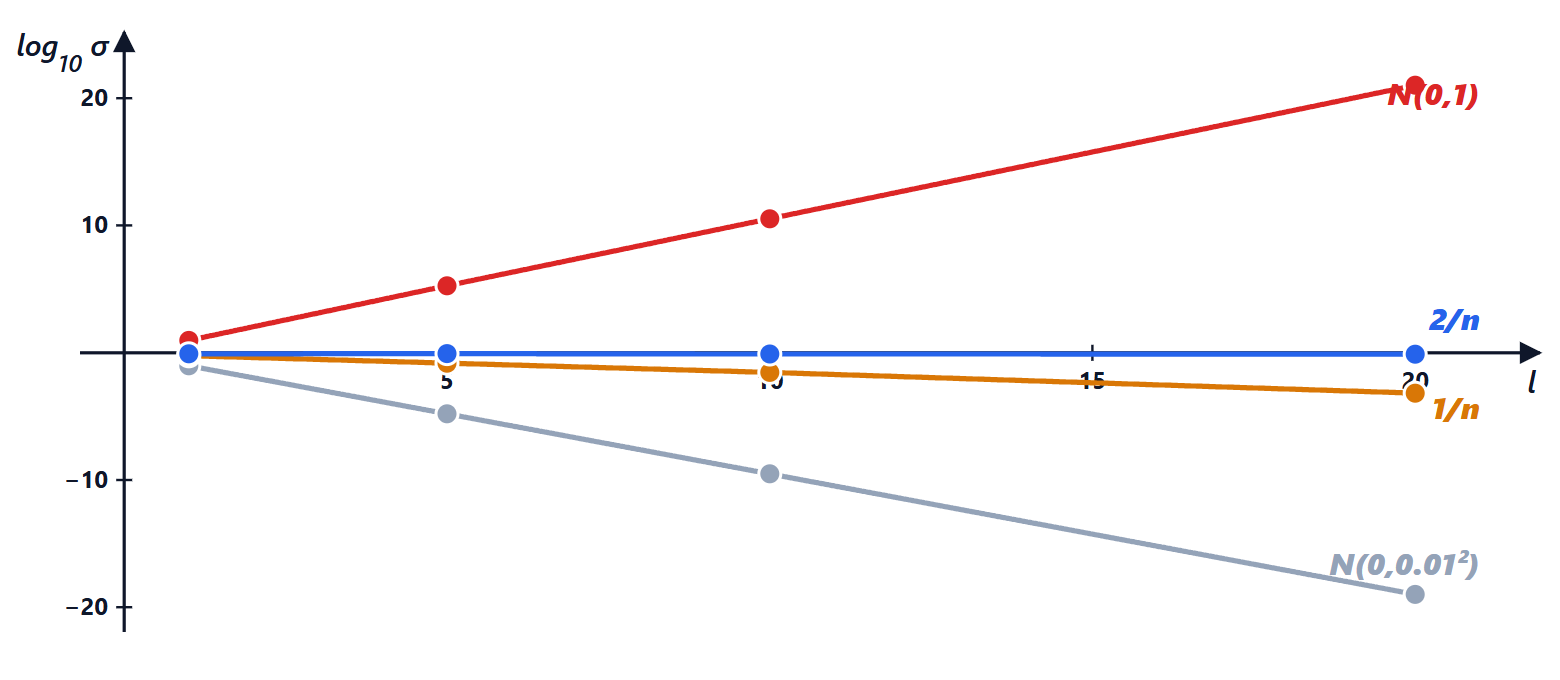
Per attivazioni simmetriche come la tanh il fattore 1/2 non c’è e si ottiene  (Xavier o Glorot, 2010). Esperimento: 20 strati da 256 neuroni ReLU, deviazione standard delle attivazioni:
| pesi | dopo 1 strato | dopo 5 | dopo 10 | dopo 20 |
|---|---|---|---|---|
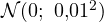 | 0,094 |  |  |  |
 | 9,35 |  |  |  |
Xavier,  | 0,58 | 0,15 | 0,028 | 0,00067 |
He,  | 0,83 | 0,86 | 0,80 | 0,76 |
Con la ReLU solo l’inizializzazione di He mantiene il segnale; quella di Xavier lo dimezza (in varianza) a ogni strato, esattamente il fattore 1/2 della dimostrazione.
La normalizzazione
La batch normalization (2015) normalizza le somme pesate di ogni neurone sul mini-lotto (media 0, varianza 1) e poi le riscala con due parametri imparati. Rende l’addestramento molto meno sensibile all’inizializzazione e al passo, e permette passi più grandi. Nei transformer si usa la layer normalization, che normalizza sulle componenti di un singolo esempio invece che sul lotto, e funziona anche con lotti piccoli e sequenze di lunghezza variabile. Anche gli ingressi vanno normalizzati: variabili con scale molto diverse (una temperatura in kelvin e una tensione in millivolt) peggiorano il condizionamento (lezione 1).
Contro il sovradattamento
- Più dati: è il rimedio più efficace di tutti, come mostra l’esperimento qui sotto.
- Aumento dei dati: nuove copie degli esempi trasformate in modi che non cambiano la risposta (spostamenti, rotazioni, rumore, variazioni di luce).
- Weight decay: la penalità
 della lezione 1.
- Dropout (Srivastava e altri, 2014): durante l’addestramento ogni neurone viene spento a caso con probabilità
 , e quelli rimasti vengono moltiplicati per
 . Così il valore atteso di ogni uscita è lo stesso con e senza dropout:
 , e in uso la rete si usa intera senza correzioni. L’idea è impedire che i neuroni si “appoggino” gli uni sugli altri.
- Arresto anticipato (early stopping): si controlla l’errore di validazione durante l’addestramento e ci si ferma quando comincia a salire.
Gli esperimenti. Rete densa 64 → 1024 → 1024 → 10 sulle cifre 8×8, addestrata per 300 passi su sottoinsiemi di dimensione crescente, accuratezza sulle 450 cifre di prova (media su 3 semi):
| esempi di addestramento | 50 | 100 | 200 | 400 | 1347 |
|---|---|---|---|---|---|
| accuratezza di prova | 76,4 % | 89,5 % | 91,9 % | 95,5 % | 97,0 % |
Il dropout (p = 0,5), sulla stessa rete con 100 esempi, ha dato 89,5 % contro 89,1 % senza (media su 5 semi): nessuna differenza misurabile; con 50 esempi 77,8 % contro 77,9 %. Il weight decay con  ha peggiorato leggermente (86,0 %). Su questo problema, piccolo e già facile, la regolarizzazione conta poco e la quantità di dati conta moltissimo. Su reti molto grandi e problemi più difficili (le immagini di ImageNet, i modelli linguistici) dropout e weight decay danno invece vantaggi misurabili. La morale è quella della lezione: le tecniche si provano sul proprio problema, con una validazione onesta.
Le metriche
L’accuratezza (frazione di risposte giuste) inganna quando le classi sono sbilanciate: se un guasto capita nell’1 % dei casi, un classificatore che dice sempre “nessun guasto” ha il 99 % di accuratezza ed è inutile. Per una classe “positiva”, con VP, FP, FN i veri positivi, i falsi positivi e i falsi negativi:
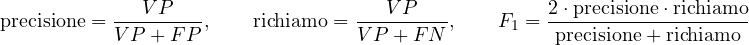
La precisione dice quante delle segnalazioni sono vere, il richiamo quanti dei casi veri vengono trovati. Spostando la soglia di decisione si scambia l’una con l’altro; quale sia più importante dipende dall’applicazione (in un sistema di frenata d’emergenza un falso negativo è molto più grave di un falso positivo, in un filtro antispam il contrario). La matrice di confusione, usata nell’ultima lezione, mostra tutti gli errori classe per classe.
La scelta degli iperparametri
Passo, dimensioni, regolarizzazione, dimensione del lotto sono iperparametri: non si imparano con il gradiente, si scelgono confrontando i risultati sulla validazione. La ricerca casuale (Bergstra e Bengio, 2012) è di solito migliore della ricerca a griglia: se solo pochi iperparametri contano davvero, provare valori casuali esplora molti più valori diversi di quelli importanti. Il passo si cerca su scala logaritmica ( ,
 ,
 , …).
import numpy as np, torch, torch.nn as nn
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split

# 1) inizializzazione: deviazione standard delle attivazioni attraverso 20 strati ReLU
g = np.random.default_rng(0)
h0 = g.normal(0, 1, (1000, 256))
for nome, dev in (("N(0, 0.01^2)", lambda n: 0.01), ("N(0, 1)", lambda n: 1.0),
                  ("Xavier 1/n", lambda n: np.sqrt(1 / n)), ("He 2/n", lambda n: np.sqrt(2 / n))):
    h, valori = h0.copy(), []
    for strato in range(20):
        h = np.maximum(h @ g.normal(0, dev(256), (256, 256)), 0)
        valori.append(h.std())
    print(f"{nome:13s}: dopo 1, 5, 10, 20 strati {valori[0]:.3g}, {valori[4]:.3g}, {valori[9]:.3g}, {valori[19]:.3g}")

# 2) quantità di dati: la stessa rete addestrata su sottoinsiemi sempre più grandi
d = load_digits()
Xa, Xp, ya, yp = train_test_split(d.data / 16.0, d.target, test_size=0.25, random_state=0, stratify=d.target)
Xa, Xp = torch.tensor(Xa, dtype=torch.float32), torch.tensor(Xp, dtype=torch.float32)
ya, yp = torch.tensor(ya), torch.tensor(yp)

def prova(n, seme, dropout=0.0):
    torch.manual_seed(seme)
    strati = [nn.Linear(64, 1024), nn.ReLU()] + ([nn.Dropout(dropout)] if dropout else []) \
           + [nn.Linear(1024, 1024), nn.ReLU()] + ([nn.Dropout(dropout)] if dropout else []) + [nn.Linear(1024, 10)]
    rete = nn.Sequential(*strati)
    opt = torch.optim.Adam(rete.parameters(), lr=1e-3)
    idx = torch.randperm(len(Xa), generator=torch.Generator().manual_seed(seme))[:n]
    for _ in range(300):                                   # 300 passi sull'intero sottoinsieme
        rete.train()
        perdita = nn.functional.cross_entropy(rete(Xa[idx]), ya[idx])
        opt.zero_grad(); perdita.backward(); opt.step()
    rete.eval()                                            # in uso il dropout è spento
    with torch.no_grad():
        return float((rete(Xp).argmax(1) == yp).float().mean())

for n in (50, 100, 200, 400, 1347):
    print(f"{n:4d} esempi: accuratezza di prova {np.mean([prova(n, s) for s in range(3)]):.3f}")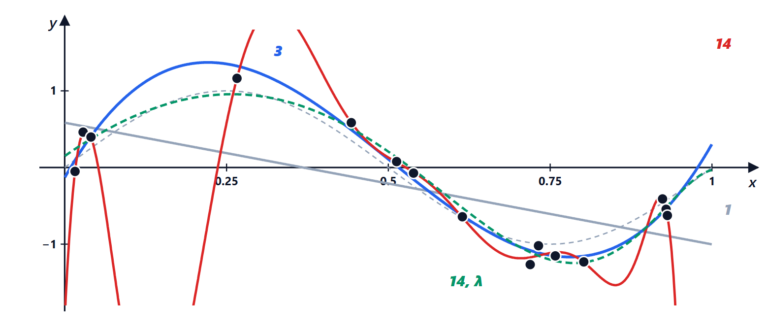
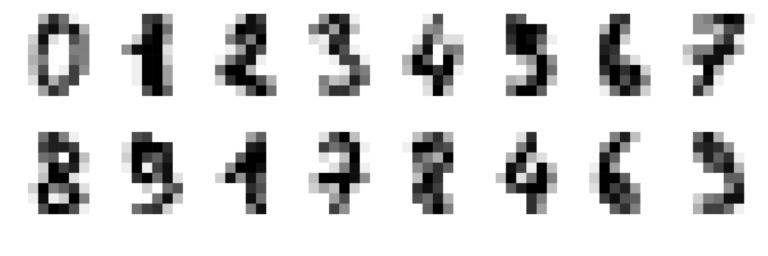


Sono l'autore di questa pagina su «L’addestramento in pratica: dati, inizializzazione di He, normalizzazione, dropout e metriche». Se qualcosa non è chiaro, se vi serve un esempio in più o volete approfondire un punto, scrivetelo qui sotto nei commenti: rispondo personalmente. Se la pagina vi è stata utile, lasciate un voto con le stelle in cima all'articolo.I am the author of this page on “Training in practice: data, He initialisation, normalisation, dropout and metrics”. If something is unclear, if you need another example or want to go deeper into a point, write it in the comments below: I answer personally. If the page was useful, leave a star rating at the top of the article.