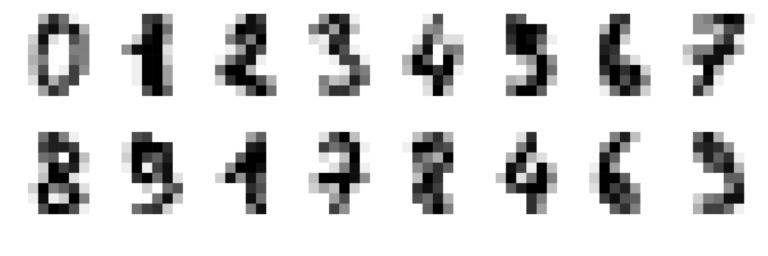La retropropagazione: equazioni dimostrate in forma matriciale e controllo numerico del gradiente
La regola della catena sul grafo di calcolo, le equazioni della retropropagazione dimostrate, il costo indipendente dal numero di parametri, la differenziazione automatica, implementazione da zero in NumPy verificata con le differenze centrali.
Per addestrare una rete con la discesa del gradiente serve la derivata della perdita rispetto a ogni peso: milioni, o miliardi, di derivate a ogni passo. Calcolarle una per una sarebbe impossibile. La retropropagazione (backpropagation, resa popolare da Rumelhart, Hinton e Williams nel 1986) le calcola tutte con un costo dello stesso ordine di quello di valutare la rete (circa tre volte in tutto), applicando la regola della catena all’indietro, dall’uscita verso l’ingresso. Questa lezione la ricava in forma matriciale per una rete a più strati, spiega perché è così efficiente, la implementa da zero in NumPy e la verifica con il controllo numerico del gradiente.
Il grafo di calcolo e la regola della catena
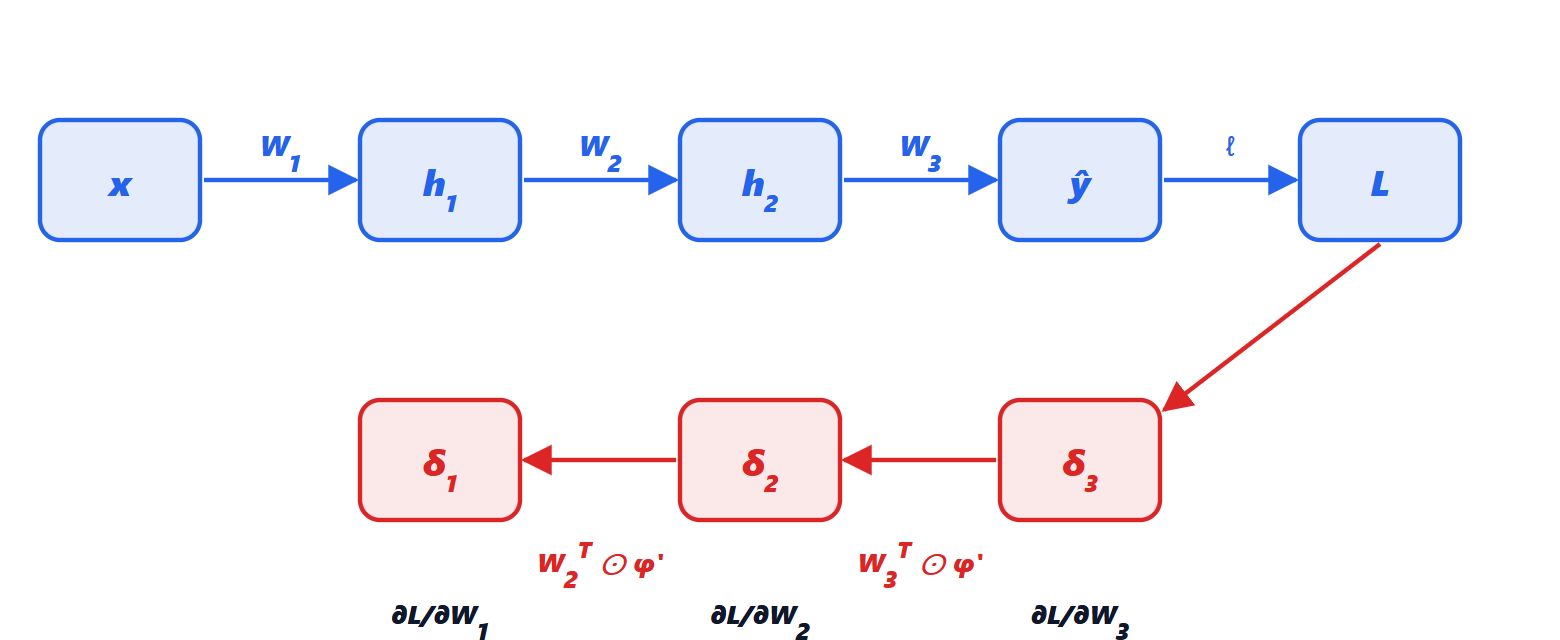
Una rete è una composizione di funzioni:  . Per la regola della catena, la derivata rispetto a un parametro di uno strato interno è il prodotto delle derivate di tutti gli strati che lo seguono. L’osservazione chiave è che questi prodotti hanno fattori in comune: la derivata rispetto all’uscita dello strato
 serve per i parametri dello strato e anche, moltiplicata per un fattore in più, per tutti gli strati precedenti. Calcolandola una volta sola, partendo dalla fine, si evita di ripetere il lavoro. È lo stesso principio della programmazione dinamica.
La retropropagazione per una rete a più strati
Per una rete con strati 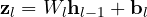 ,
 (con
 ), si definisce l’errore dello strato
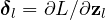 .
Teorema (le equazioni della retropropagazione).
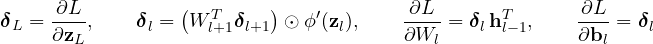
dove  è il prodotto elemento per elemento.
Dimostrazione. La componente  di
 dipende da
 attraverso
 . Per la regola della catena
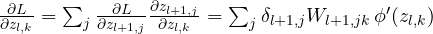 , che in forma vettoriale è la seconda equazione. Per i pesi:
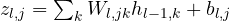 , quindi
 e
 . ∎
L’ultimo strato. Con la softmax e l’entropia incrociata (lezione 1),  : la probabilità prevista meno quella vera (codificata “one-hot”, 1 nella classe giusta e 0 altrove). Con un mini-lotto di
 esempi,
 e
 diventano matrici con un esempio per riga, e le formule diventano
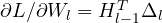 (media sul lotto): prodotti tra matrici, esattamente quello in cui le GPU sono velocissime.
Il costo. Il passaggio in avanti costa un prodotto matrice-vettore per strato; quello all’indietro due (uno per  , uno per il gradiente dei pesi). In tutto circa il triplo del solo passaggio in avanti, indipendentemente dal numero di parametri. Calcolare le derivate con le differenze finite richiederebbe invece un passaggio in avanti per ogni parametro.
La differenziazione automatica
Le librerie moderne (PyTorch, JAX, TensorFlow) non chiedono di scrivere queste formule. Durante il passaggio in avanti registrano ogni operazione in un grafo di calcolo; chiamando backward() lo percorrono all’indietro applicando a ogni operazione la sua derivata nota. È la differenziazione automatica in modalità inversa: la retropropagazione generalizzata a qualunque programma, comprese condizioni e cicli. Non è un’approssimazione numerica: le derivate sono esatte, a meno degli arrotondamenti.
Il controllo numerico del gradiente
Quando si scrive la retropropagazione a mano (o un nuovo strato) la si verifica con le differenze centrali: per un peso  ,
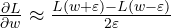 , con errore dell’ordine di
 (gli ordini dispari dello sviluppo di Taylor si cancellano). Con
 e calcoli in doppia precisione, un’implementazione corretta dà un errore relativo intorno a
 –
 ; un errore anche piccolo nella formula dà valori dell’ordine di
 o più.
import numpy as np

def inizializza(dimensioni, seme=0):
    g = np.random.default_rng(seme)
    return [(g.normal(0, np.sqrt(2 / a), (a, b)), np.zeros(b)) for a, b in zip(dimensioni[:-1], dimensioni[1:])]

def avanti(parametri, X):
    attivazioni = [X]
    for i, (W, b) in enumerate(parametri):
        z = attivazioni[-1] @ W + b
        attivazioni.append(np.maximum(z, 0) if i < len(parametri) - 1 else z)   # ReLU, ultimo strato lineare
    return attivazioni

def perdita_e_gradienti(parametri, X, Y):
    att = avanti(parametri, X)
    z = att[-1] - att[-1].max(1, keepdims=True)
    p = np.exp(z); p /= p.sum(1, keepdims=True)                                 # softmax
    N = len(X)
    perdita = -np.log(p[np.arange(N), Y]).mean()                                # entropia incrociata
    delta = p.copy(); delta[np.arange(N), Y] -= 1; delta /= N                   # delta dell'ultimo strato: p - y
    gradienti = []
    for i in range(len(parametri) - 1, -1, -1):
        W, b = parametri[i]
        gradienti.append((att[i].T @ delta, delta.sum(0)))                      # dL/dW = h^T delta
        if i > 0:
            delta = (delta @ W.T) * (att[i] > 0)                                # delta all'indietro, derivata della ReLU
    return perdita, gradienti[::-1]

rng = np.random.default_rng(1)
X = rng.normal(0, 1, (8, 5)); Y = rng.integers(0, 3, 8)                         # 8 esempi, 5 ingressi, 3 classi
par = inizializza([5, 7, 3])
_, grad = perdita_e_gradienti(par, X, Y)

eps, numerico = 1e-6, np.zeros_like(par[0][0])
for i in range(5):
    for j in range(7):
        par[0][0][i, j] += eps;     Lp, _ = perdita_e_gradienti(par, X, Y)
        par[0][0][i, j] -= 2 * eps; Lm, _ = perdita_e_gradienti(par, X, Y)
        par[0][0][i, j] += eps
        numerico[i, j] = (Lp - Lm) / (2 * eps)                                  # differenze centrali
errore = np.abs(numerico - grad[0][0]).max() / np.abs(numerico).max()
print(f"errore relativo tra retropropagazione e differenze centrali: {errore:.1e}")
L’esecuzione dà un errore relativo di circa –: la retropropagazione è corretta. Le stesse due funzioni, con un ciclo di discesa del gradiente, bastano ad addestrare una rete vera: è il progetto dell’ultima lezione del corso, che riconosce le cifre scritte a mano con il 98 % di accuratezza.