Rétropropagation : équations démontrées sous forme matricielle et vérification numérique du gradient
La règle de dérivation en chaîne sur le graphe de calcul, les équations de rétropropagation démontrées, un coût indépendant du nombre de paramètres, la différentiation automatique, une réalisation NumPy de zéro vérifiée par différences centrées.
https://www.electronics-engineering.com/fr/retropropagation-verification-du-gradient/
Pour entraîner un réseau par descente de gradient, il faut la dérivée de la perte par rapport à chaque poids : des millions, ou des milliards de dérivées à chaque pas. Les calculer une à une serait impossible. La rétropropagation (backpropagation, popularisée par Rumelhart, Hinton et Williams en 1986) les calcule toutes pour un coût du même ordre que l’évaluation du réseau (environ trois fois en tout), en appliquant la règle de dérivation en chaîne à rebours, de la sortie vers l’entrée. Cette leçon l’établit sous forme matricielle pour un réseau multicouche, explique pourquoi elle est si efficace, la réalise de zéro en NumPy et la vérifie avec la vérification numérique du gradient.
Le graphe de calcul et la règle de dérivation en chaîne
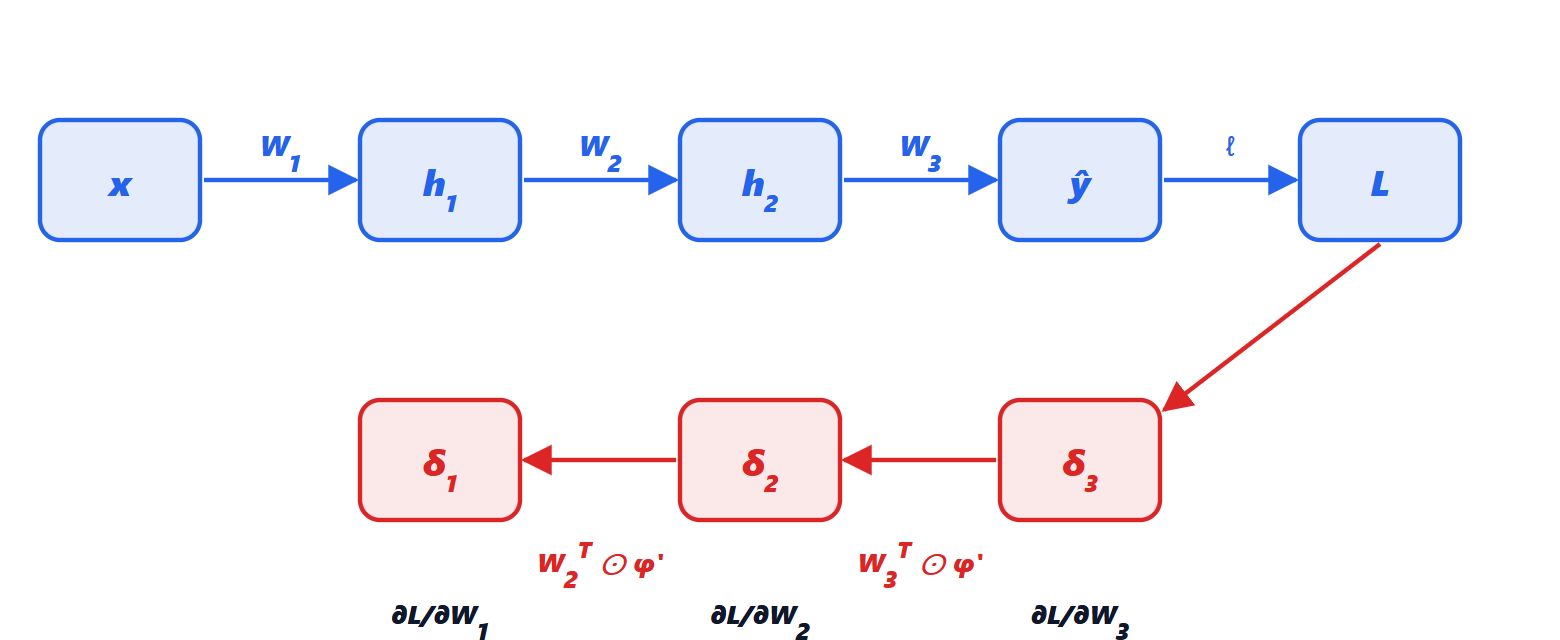
Un réseau est une composition de fonctions :  . Par la règle de dérivation en chaîne, la dérivée par rapport à un paramètre d’une couche interne est le produit des dérivées de toutes les couches qui la suivent. L’observation clé est que ces produits ont des facteurs communs : la dérivée par rapport à la sortie de la couche
 est nécessaire pour les paramètres de la couche et aussi, multipliée par un facteur de plus, pour toutes les couches précédentes. La calculer une seule fois, en partant de la fin, évite de répéter le travail. C’est le même principe que la programmation dynamique.
La rétropropagation pour un réseau multicouche
Pour un réseau de couches 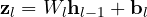 ,
 (avec
 ), l’erreur de couche se définit comme
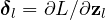 .
Théorème (les équations de rétropropagation).
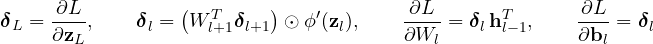
où  est le produit terme à terme.
Démonstration. La composante  de
 dépend de
 par
 . Par la règle de dérivation en chaîne,
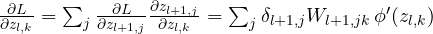 , ce qui, sous forme vectorielle, est la deuxième équation. Pour les poids :
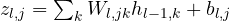 , donc
 et
 . ∎
La dernière couche. Avec la softmax et l’entropie croisée (leçon 1),  : la probabilité prédite moins la vraie (codée « one-hot », 1 dans la bonne classe et 0 ailleurs). Avec un mini-lot de
 exemples,
 et
 deviennent des matrices avec un exemple par ligne, et les formules deviennent
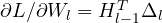 (moyennée sur le lot) : des produits de matrices, exactement ce pour quoi les GPU sont très rapides.
Le coût. La passe avant coûte un produit matrice-vecteur par couche ; la passe arrière deux (un pour  , un pour le gradient des poids). En tout, environ trois fois la passe avant seule, quel que soit le nombre de paramètres. Calculer les dérivées par différences finies demanderait au contraire une passe avant pour chaque paramètre.
La différentiation automatique
Les bibliothèques modernes (PyTorch, JAX, TensorFlow) ne demandent pas d’écrire ces formules. Pendant la passe avant, elles enregistrent chaque opération dans un graphe de calcul ; en appelant backward(), elles le parcourent à rebours en appliquant à chaque opération sa dérivée connue. C’est la différentiation automatique en mode inverse : la rétropropagation généralisée à tout programme, y compris avec conditions et boucles. Ce n’est pas une approximation numérique : les dérivées sont exactes, aux arrondis près.
La vérification numérique du gradient
Quand la rétropropagation (ou une nouvelle couche) est écrite à la main, on la vérifie avec des différences centrées : pour un poids  ,
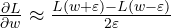 , avec une erreur d’ordre
 (les ordres impairs du développement de Taylor s’annulent). Avec
 et des calculs en double précision, une réalisation correcte donne une erreur relative d’environ
 –
 ; même une petite erreur dans la formule donne des valeurs d’ordre
 ou plus.
import numpy as np

def initialise(sizes, seed=0):
    g = np.random.default_rng(seed)
    return [(g.normal(0, np.sqrt(2 / a), (a, b)), np.zeros(b)) for a, b in zip(sizes[:-1], sizes[1:])]

def forward(params, X):
    activations = [X]
    for i, (W, b) in enumerate(params):
        z = activations[-1] @ W + b
        activations.append(np.maximum(z, 0) if i < len(params) - 1 else z)     # ReLU, last layer linear
    return activations

def loss_and_gradients(params, X, Y):
    act = forward(params, X)
    z = act[-1] - act[-1].max(1, keepdims=True)
    p = np.exp(z); p /= p.sum(1, keepdims=True)                                 # softmax
    N = len(X)
    loss = -np.log(p[np.arange(N), Y]).mean()                                   # cross-entropy
    delta = p.copy(); delta[np.arange(N), Y] -= 1; delta /= N                   # delta of the last layer: p - y
    gradients = []
    for i in range(len(params) - 1, -1, -1):
        W, b = params[i]
        gradients.append((act[i].T @ delta, delta.sum(0)))                      # dL/dW = h^T delta
        if i > 0:
            delta = (delta @ W.T) * (act[i] > 0)                                # delta backwards, ReLU derivative
    return loss, gradients[::-1]

rng = np.random.default_rng(1)
X = rng.normal(0, 1, (8, 5)); Y = rng.integers(0, 3, 8)                         # 8 examples, 5 inputs, 3 classes
par = initialise([5, 7, 3])
_, grad = loss_and_gradients(par, X, Y)

eps, numerical = 1e-6, np.zeros_like(par[0][0])
for i in range(5):
    for j in range(7):
        par[0][0][i, j] += eps;     Lp, _ = loss_and_gradients(par, X, Y)
        par[0][0][i, j] -= 2 * eps; Lm, _ = loss_and_gradients(par, X, Y)
        par[0][0][i, j] += eps
        numerical[i, j] = (Lp - Lm) / (2 * eps)                                 # central differences
error = np.abs(numerical - grad[0][0]).max() / np.abs(numerical).max()
print(f"relative error between backpropagation and central differences: {error:.1e}")
Son exécution donne une erreur relative d’environ – : la rétropropagation est correcte. Les deux mêmes fonctions, avec une boucle de descente de gradient, suffisent à entraîner un vrai réseau : c’est le projet de la dernière leçon du cours, qui reconnaît des chiffres manuscrits avec 98 % de précision.






Sono l'autore di questa pagina su «La retropropagazione: equazioni dimostrate in forma matriciale e controllo numerico del gradiente». Se qualcosa non è chiaro, se vi serve un esempio in più o volete approfondire un punto, scrivetelo qui sotto nei commenti: rispondo personalmente. Se la pagina vi è stata utile, lasciate un voto con le stelle in cima all'articolo.I am the author of this page on “Backpropagation: equations proved in matrix form and numerical gradient check”. If something is unclear, if you need another example or want to go deeper into a point, write it in the comments below: I answer personally. If the page was useful, leave a star rating at the top of the article.