Le perceptron et les réseaux multicouches : théorème de Novikoff, XOR et approximation universelle
Le perceptron et le théorème de convergence de Novikoff démontré, le problème du XOR, les réseaux multicouches et les fonctions d'activation, le théorème d'approximation universelle, une expérience sur 100 graines concernant la taille du réseau.
https://www.electronics-engineering.com/fr/perceptron-reseaux-multicouches-xor-approximation-universelle/
Un réseau de neurones est une fonction construite en composant de nombreuses fonctions simples, les neurones : chacun calcule une somme pondérée de ses entrées et la fait passer par une fonction non linéaire. Cette leçon part du neurone le plus simple, le perceptron de Rosenblatt (1958), démontre qu’il apprend en un nombre fini de pas quand les classes sont séparables par une droite, montre pourquoi une seule couche ne suffit pas (le problème du XOR) et introduit les réseaux multicouches, avec le théorème d’approximation universelle et une expérience qui montre à quel point la taille du réseau compte.
Le perceptron
Le perceptron classe une entrée  dans deux classes,
 et
 , avec le signe d’une somme pondérée :
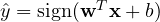 . Géométriquement, la frontière entre les classes est l’hyperplan
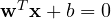 (une droite en deux dimensions). L’algorithme d’apprentissage est très simple : on parcourt les exemples et, quand l’un est mal classé, on déplace le vecteur des poids vers lui,
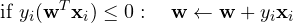
(l’ordonnée à l’origine  est incluse dans
 en ajoutant à une composante constante 1).
Théorème (Novikoff, 1962). S’il existe un vecteur unitaire  qui sépare les données avec une marge
 , c’est-à-dire
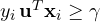 pour tout
 , et que
 , le perceptron fait au plus
 corrections.
Démonstration. On suit deux grandeurs après  corrections, en partant de
 . La projection sur croît d’au moins
 à chaque correction :
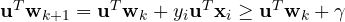 , donc
 . La norme, elle, croît peu :
 , parce que la correction n’a lieu que si
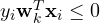 ; donc
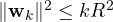 . Par l’inégalité de Cauchy-Schwarz,
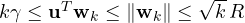 , c’est-à-dire
 . ∎
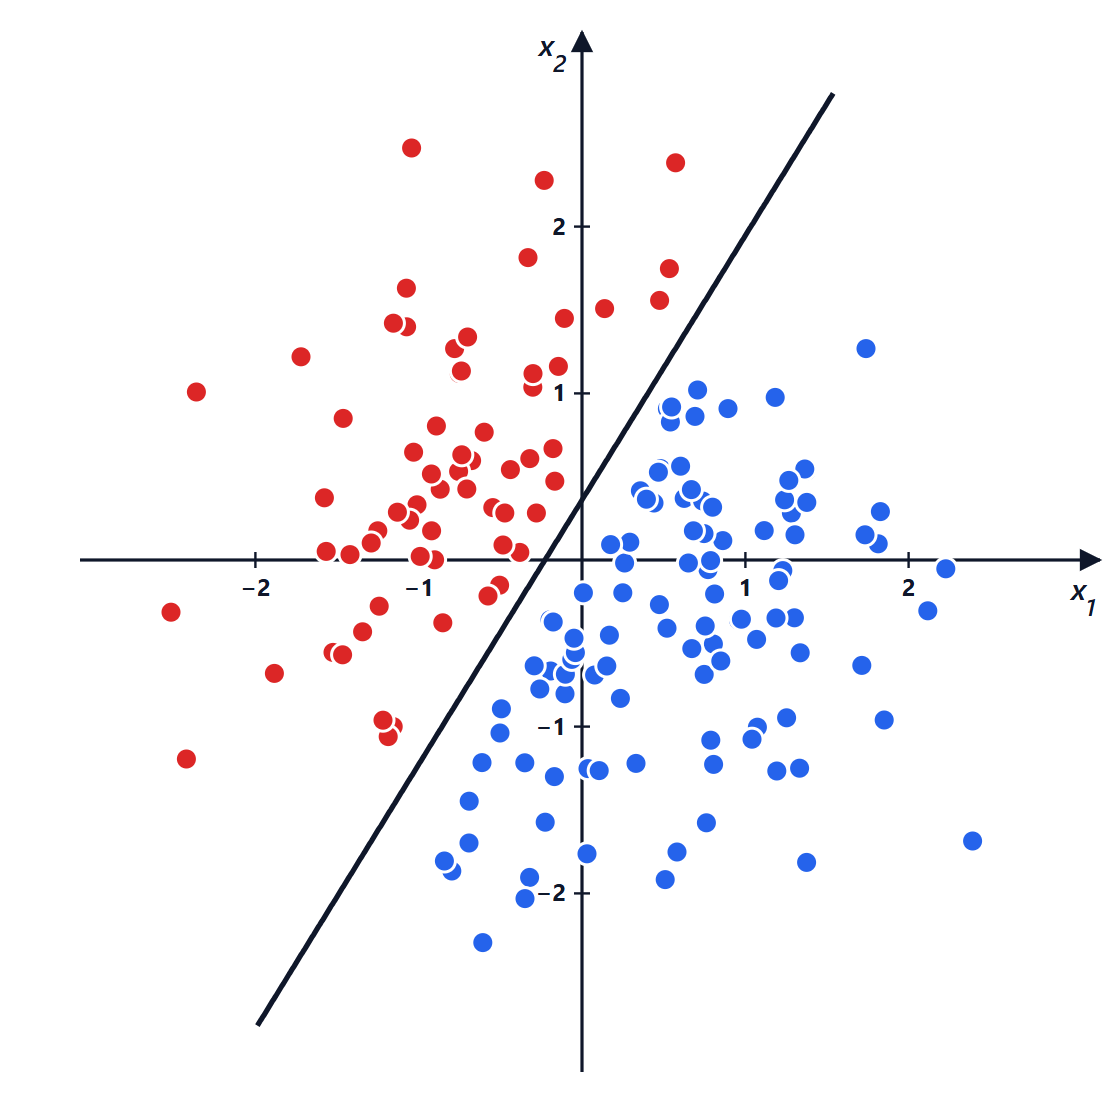
La borne ne dépend ni du nombre d’exemples ni de la dimension de l’espace, mais seulement de la « distance » entre les classes par rapport à leur étendue. Dans une expérience avec 167 points séparables avec une marge de 0,15, le perceptron a fait 11 corrections en 3 passages sur les données ; la borne de Novikoff était 421 : le théorème est un pire cas, la pratique fait en général bien mieux.
La limite d’une couche : le XOR
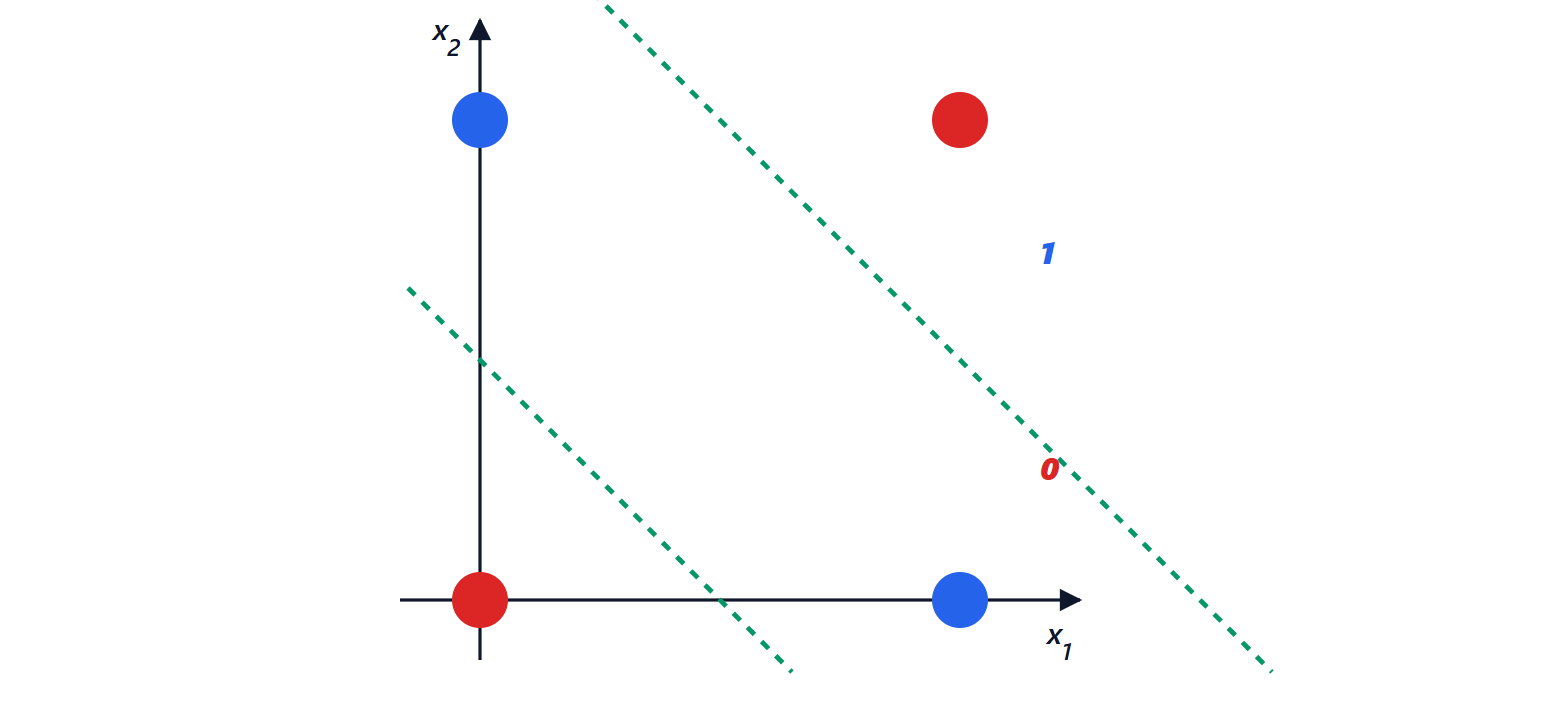
Le perceptron trouve une droite, mais de nombreux problèmes ne sont pas séparables par une droite. Le plus simple est le XOR (ou exclusif) : la sortie vaut 1 si exactement l’une des deux entrées vaut 1. Les points (0, 1) et (1, 0) doivent être d’un côté, (0, 0) et (1, 1) de l’autre : aucune droite ne peut le faire. Minsky et Papert l’ont souligné en 1969, et la recherche sur les réseaux de neurones a ralenti pendant des années.
La solution est d’ajouter une couche cachée : les neurones cachés transforment les entrées en de nouvelles variables dans lesquelles le problème devient séparable. Deux neurones cachés suffisent : l’un peut calculer « au moins une vaut 1 » (OR), l’autre « les deux valent 1 » (AND), et la sortie « OR mais pas AND ».
Les réseaux multicouches
Un réseau multicouche (perceptron multicouche, MLP) applique en séquence des transformations linéaires et des non-linéarités :
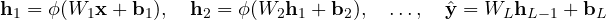
La fonction d’activation  est essentielle : sans elle, la composition de transformations linéaires est encore linéaire et le réseau ne serait pas plus puissant qu’une seule couche. Les plus utilisées :
- la sigmoïde
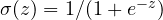 et la tangente hyperbolique
 : lisses, mais elles « saturent » pour de grands
 , où la dérivée est presque nulle ;
- la ReLU
 : très simple, de dérivée 1 pour
 , elle ne sature pas dans un sens. C’est le choix par défaut depuis 2012 ;
- des variantes lisses comme la GELU et la SiLU, utilisées dans les transformers.
Théorème d’approximation universelle (Cybenko 1989, Hornik 1991). Un réseau à une seule couche cachée et à fonction d’activation non polynomiale peut approcher avec une erreur arbitrairement petite toute fonction continue sur un ensemble fermé et borné, pourvu qu’il ait assez de neurones.
Idée de la démonstration (pour une variable, avec la sigmoïde). Une sigmoïde très raide 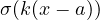 est presque un échelon en
 ; la différence de deux échelons est un « rectangle » entre et
 . Une fonction continue peut être approchée par une fonction en escalier (des sommes de rectangles) avec une erreur aussi petite que l’on veut, en rétrécissant les marches ; chaque rectangle coûte deux neurones. ∎
Le théorème dit que le réseau peut représenter la fonction, pas que la descente de gradient la trouvera, ni combien de neurones il faut (ils peuvent être très nombreux). En pratique, les réseaux profonds, avec de nombreuses couches de largeur modérée, représentent des fonctions utiles avec bien moins de paramètres qu’un réseau large peu profond : chaque couche construit des caractéristiques plus abstraites à partir de celles de la couche précédente.
Une expérience : quelle taille doit avoir le réseau
On entraîne le XOR par descente de gradient à partir de poids aléatoires, en répétant avec 100 graines différentes, et l’on compte combien de fois le réseau apprend vraiment la fonction :
| neurones cachés | XOR résolu |
|---|---|
| 2 | 49 fois sur 100 |
| 3 | 92 fois sur 100 |
| 4 | 98 fois sur 100 |
Avec deux neurones cachés, la solution existe, mais la moitié du temps la descente de gradient s’arrête dans un minimum local (par exemple avec une sortie de 0,5 sur deux des quatre cas). En ajoutant des neurones, le paysage de l’erreur devient plus facile à parcourir et presque tout point de départ mène à une solution. C’est l’une des raisons pour lesquelles les réseaux modernes ont bien plus de paramètres que ce qui serait nécessaire en théorie.
import numpy as np

X = np.array([[0, 0], [0, 1], [1, 0], [1, 1]], float)
y = np.array([0, 1, 1, 0], float)                          # XOR
sig = lambda z: 1 / (1 + np.exp(-z))

def train(hidden, seed, steps=10000, eta=0.5):
    g = np.random.default_rng(seed)
    W1, b1 = g.normal(0, 1, (2, hidden)), np.zeros(hidden)
    W2, b2 = g.normal(0, 1, hidden), 0.0
    for _ in range(steps):
        h = np.tanh(X @ W1 + b1)                           # hidden layer
        out = sig(h @ W2 + b2)
        d2 = out - y                                       # gradient of cross-entropy + sigmoid
        dh = np.outer(d2, W2) * (1 - h ** 2)               # derivative of tanh
        W2 -= eta * h.T @ d2; b2 -= eta * d2.sum()
        W1 -= eta * X.T @ dh; b1 -= eta * dh.sum(0)
    return sig(np.tanh(X @ W1 + b1) @ W2 + b2)

for hidden in (2, 3, 4):
    solved = sum(np.all(np.abs(train(hidden, s) - y) < 0.1) for s in range(100))
    print(f"{hidden} hidden neurons: XOR solved {solved} times out of 100")
print("example with 3 neurons:", np.round(train(3, 0), 3))
Le calcul du gradient écrit ici à la main, pour une couche cachée, se généralise à un nombre quelconque de couches avec la rétropropagation (backpropagation), sujet de la leçon suivante.



Benvenuti nella pagina su «Il percettrone e le reti a più strati: teorema di Novikoff, XOR e approssimazione universale». L'ho scritta pensando a chi studia ingegneria elettronica: se un passaggio non vi torna, un esercizio vi dà un risultato diverso o volete altro materiale sull'argomento, chiedete pure nei commenti e vi risponderò. Un voto con le stelle qui sopra mi aiuta a capire quali pagine migliorare.Welcome to the page on “The perceptron and multilayer networks: Novikoff's theorem, XOR and universal approximation”. I wrote it for engineering students: if a step does not add up, an exercise gives you a different result or you would like more material on the topic, just ask in the comments and I will reply. A star rating above helps me understand which pages to improve.