Projet : reconnaître des chiffres manuscrits avec NumPy et PyTorch, jusqu'à ONNX et la quantification sur 8 bits
Un réseau écrit de zéro en NumPy et le même en PyTorch sur des chiffres 8x8 (98 % de précision), matrice de confusion et analyse des erreurs, export ONNX et quantification des poids sur 8 bits pour les microcontrôleurs.
https://www.electronics-engineering.com/fr/projet-reseau-de-neurones-chiffres-numpy-pytorch-onnx-quantification/
Cette leçon réunit tout le cours dans un projet complet qui fonctionne : reconnaître des chiffres manuscrits. Le réseau est d’abord écrit de zéro en NumPy, avec la rétropropagation de la leçon 3, puis le même réseau en PyTorch, où les gradients sont calculés par différentiation automatique ; le résultat est évalué avec la matrice de confusion et les erreurs sont examinées ; enfin, le modèle est préparé pour une utilisation hors de Python (format ONNX) et pour un microcontrôleur, avec une quantification des poids sur 8 bits. Tous les nombres rapportés viennent de l’exécution du code au bas de la page.
Les données
La collection de scikit-learn contient 1797 chiffres écrits à la main par 43 personnes, réduits à des images de 8×8 pixels à 17 niveaux de gris (de 0 à 16) : assez petits pour entraîner un réseau en une seconde sur un ordinateur portable, mais un vrai problème, avec des écritures différentes. Les valeurs sont divisées par 16 (entrées entre 0 et 1, leçon 7) et les données sont réparties en 1347 exemples d’entraînement et 450 exemples de test, stratifiés (chaque chiffre dans la même proportion dans les deux ensembles) et avec une graine fixe, pour que le résultat soit reproductible.
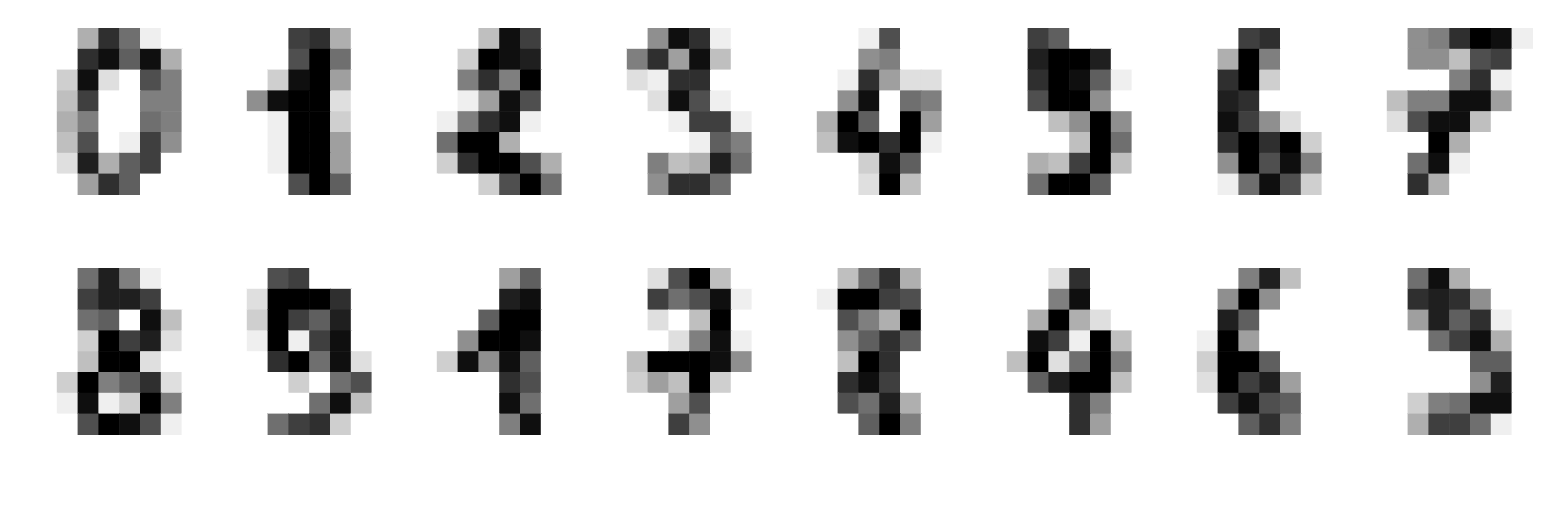
Le réseau en NumPy
Architecture 64 → 64 → 10 : 64 entrées (les pixels), une couche cachée de 64 neurones ReLU, 10 sorties avec softmax. Poids initialisés avec la règle de He (leçon 7), entropie croisée, descente de gradient stochastique avec des lots de 32 exemples et un pas de 0,1 pendant 100 époques. La boucle d’entraînement est la traduction directe des équations de rétropropagation :  , gradients de la dernière couche
 ,
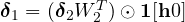 , gradients de la première couche
 . Résultat : 98,0 % de précision en test, en 0,3-0,4 seconde.
Le même réseau en PyTorch
En PyTorch, le réseau se déclare comme une suite de couches, et le gradient est calculé par loss.backward(). Avec la même architecture, le même optimiseur et les mêmes hyperparamètres, on obtient 97,8 % : la petite différence (un exemple sur 450) vient de l’initialisation aléatoire différente (PyTorch utilise par défaut une distribution uniforme mise à l’échelle) et de l’ordre des lots. Pour un réseau si petit, PyTorch est même plus lent que NumPy (1,6 s) : le vrai avantage vient avec les grands réseaux, sur GPU, et avec des architectures compliquées dont personne ne voudrait écrire les dérivées à la main.
La matrice de confusion
Lignes : chiffre vrai ; colonnes : chiffre prédit par le réseau PyTorch. Sur la diagonale, les bonnes réponses :
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | |
|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 45 | |||||||||
| 1 | 45 | 1 | ||||||||
| 2 | 1 | 43 | ||||||||
| 3 | 46 | |||||||||
| 4 | 1 | 43 | 1 | |||||||
| 5 | 1 | 1 | 44 | |||||||
| 6 | 1 | 44 | ||||||||
| 7 | 45 | |||||||||
| 8 | 2 | 41 | ||||||||
| 9 | 1 | 44 |
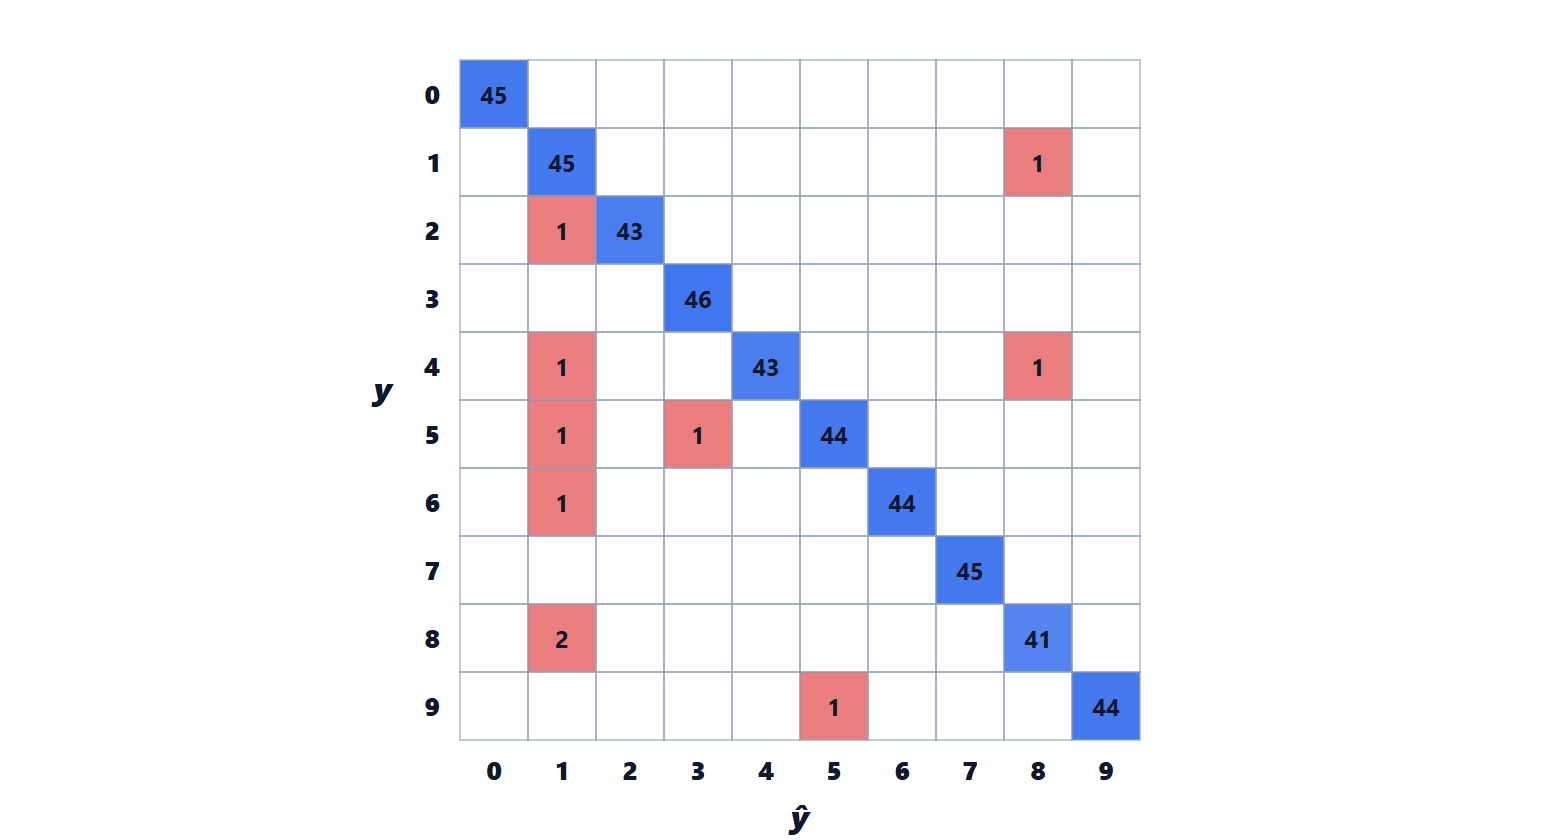
Dix erreurs sur 450, et la moitié aboutit dans la colonne du 1 : à 8×8 pixels, un trait vertical un peu épais suffit à faire ressembler un 8, un 4 ou un 6 à un 1. Regarder où un modèle se trompe est l’étape la plus utile pour l’améliorer : ici, elle suggérerait des images de plus haute résolution, un CNN (leçon 5), ou davantage d’exemples des paires confondues.
Du modèle au produit
- Sauvegarde :
torch.saveenregistre les poids ; pour les recharger, il faut le même code du réseau. - ONNX (Open Neural Network Exchange) :
torch.onnx.exportenregistre le réseau et les poids dans un format standard, qui s’exécute avec ONNX Runtime en C++, C#, Java ou JavaScript, sur des serveurs, des téléphones ou dans le navigateur, sans Python. - Microcontrôleurs : un réseau peut aussi tourner sur un microcontrôleur avec quelques centaines de kilooctets de mémoire (TensorFlow Lite for Microcontrollers, ou du code C généré par des outils comme STM32Cube.AI). L’étape décisive est la quantification : les poids deviennent des entiers sur 8 bits,
 avec
 entre −127 et 127 et une échelle
 par matrice. La mémoire des poids est divisée par quatre et les calculs deviennent des opérations sur entiers, bien plus rapides et économes en énergie. Sur le réseau des chiffres, la mémoire des poids passe de 18 944 à 4 736 octets et la précision ne change pas (97,8 %). Sur de plus grands réseaux, la perte est en général de quelques dixièmes de point ; quand c’est trop, on entraîne le réseau en tenant compte de la quantification (quantization-aware training).
Le code complet
import time
import numpy as np
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split

# data: 1797 handwritten digits, 8x8 pixels with values 0..16
d = load_digits()
Xtr, Xte, ytr, yte = train_test_split(d.data / 16.0, d.target, test_size=0.25, random_state=0, stratify=d.target)

# ---------------- network from scratch in NumPy: 64 -> 64 (ReLU) -> 10 (softmax) ----------------
rng = np.random.default_rng(0)
W1 = rng.normal(0, np.sqrt(2 / 64), (64, 64)); b1 = np.zeros(64)       # He initialisation
W2 = rng.normal(0, np.sqrt(2 / 64), (64, 10)); b2 = np.zeros(10)

def forward(X):
    z1 = X @ W1 + b1
    h = np.maximum(z1, 0)
    z2 = h @ W2 + b2
    p = np.exp(z2 - z2.max(1, keepdims=True))
    return h, p / p.sum(1, keepdims=True)

t0 = time.time()
LR, EPOCHS, BATCH = 0.1, 100, 32
for epoch in range(EPOCHS):
    perm = rng.permutation(len(Xtr))
    for i in range(0, len(Xtr), BATCH):
        idx = perm[i:i + BATCH]
        X, y = Xtr[idx], ytr[idx]
        h, p = forward(X)
        d2 = p.copy(); d2[np.arange(len(y)), y] -= 1; d2 /= len(y)    # gradient of softmax + cross-entropy
        gW2, gb2 = h.T @ d2, d2.sum(0)
        d1 = (d2 @ W2.T) * (h > 0)                                    # backpropagation through the ReLU
        gW1, gb1 = X.T @ d1, d1.sum(0)
        W1 -= LR * gW1; b1 -= LR * gb1; W2 -= LR * gW2; b2 -= LR * gb2
acc_np = (forward(Xte)[1].argmax(1) == yte).mean()
print(f"NumPy: test accuracy {acc_np:.4f} in {time.time() - t0:.1f} s")

# ---------------- the same network in PyTorch ----------------
import torch
import torch.nn as nn

torch.manual_seed(0)
model = nn.Sequential(nn.Linear(64, 64), nn.ReLU(), nn.Linear(64, 10))
opt = torch.optim.SGD(model.parameters(), lr=LR)
Xt, yt = torch.tensor(Xtr, dtype=torch.float32), torch.tensor(ytr)
t0 = time.time()
for epoch in range(EPOCHS):
    perm = torch.randperm(len(Xt))
    for i in range(0, len(Xt), BATCH):
        idx = perm[i:i + BATCH]
        loss = nn.functional.cross_entropy(model(Xt[idx]), yt[idx])  # autograd computes the gradient
        opt.zero_grad(); loss.backward(); opt.step()
with torch.no_grad():
    pred = model(torch.tensor(Xte, dtype=torch.float32)).argmax(1).numpy()
print(f"PyTorch: test accuracy {(pred == yte).mean():.4f} in {time.time() - t0:.1f} s")

# confusion matrix: rows = true digit, columns = predicted digit
conf = np.zeros((10, 10), int)
for t, q in zip(yte, pred):
    conf[t, q] += 1
print(conf)

# 8-bit weight quantisation (symmetric, one scale per matrix), as on microcontrollers
qmodel = nn.Sequential(nn.Linear(64, 64), nn.ReLU(), nn.Linear(64, 10))
qmodel.load_state_dict(model.state_dict())
with torch.no_grad():
    for layer in (qmodel[0], qmodel[2]):
        scale = layer.weight.abs().max() / 127                         # the largest weight becomes 127
        q = torch.round(layer.weight / scale).clamp(-127, 127)          # integers from -127 to 127
        layer.weight.copy_(q * scale)                                   # values the network actually sees
    qpred = qmodel(torch.tensor(Xte, dtype=torch.float32)).argmax(1).numpy()
print(f"8-bit weights: test accuracy {(qpred == yte).mean():.4f}, weight memory {sum(p.numel() for p in model.parameters() if p.dim() == 2)} bytes instead of {4 * sum(p.numel() for p in model.parameters() if p.dim() == 2)}")
torch.save(model.state_dict(), "digits.pt")
torch.onnx.export(model, torch.zeros(1, 64), "digits.onnx")                 # to use it outside Python
La suite
Le cours a construit toutes les pièces : descente de gradient, réseaux multicouches, rétropropagation, optimiseurs, convolutions, séquences et attention, pratique de l’entraînement. Les mêmes idées, changées d’échelle de plusieurs ordres de grandeur, sont celles des modèles de vision et des modèles de langage. Le cours d’apprentissage par renforcement montre comment les réseaux apprennent à décider au lieu de reconnaître, avec un environnement à la place de données étiquetées.


Sono l'autore di questa pagina su «Progetto: riconoscere le cifre scritte a mano in NumPy e PyTorch, fino a ONNX e alla quantizzazione a 8 bit». Se qualcosa non è chiaro, se vi serve un esempio in più o volete approfondire un punto, scrivetelo qui sotto nei commenti: rispondo personalmente. Se la pagina vi è stata utile, lasciate un voto con le stelle in cima all'articolo.I am the author of this page on “Project: recognising handwritten digits in NumPy and PyTorch, up to ONNX and 8-bit quantisation”. If something is unclear, if you need another example or want to go deeper into a point, write it in the comments below: I answer personally. If the page was useful, leave a star rating at the top of the article.