Optimiseurs : SGD, momentum, RMSProp et Adam avec correction du biais
La descente de gradient stochastique par mini-lots, le momentum, RMSProp, Adam et la correction du biais démontrée, AdamW, le démarrage progressif et la décroissance par paliers, comparaison des méthodes sur la fonction de Rosenbrock.
https://www.electronics-engineering.com/fr/optimiseurs-sgd-momentum-adam-rosenbrock/
La descente de gradient de la leçon 1 fonctionne, mais sur les réseaux de neurones elle est lente : la surface d’erreur a des vallées étroites et longues, des régions plates et des millions de dimensions de courbures très différentes. Les optimiseurs modernes modifient la règle de mise à jour pour aller plus vite et de façon plus stable. Cette leçon présente la descente de gradient stochastique par mini-lots, le momentum, RMSProp et Adam (l’optimiseur le plus utilisé), démontre pourquoi Adam a besoin de la « correction du biais », discute le choix du pas dans le temps, et compare les méthodes sur la fonction de Rosenbrock, une vallée courbe qui est le banc d’essai classique.
La descente de gradient stochastique
Le gradient de la perte est une moyenne sur les  exemples. Avec des millions d’exemples, le calculer en entier à chaque pas est un gaspillage. La descente de gradient stochastique (SGD) utilise à chaque pas un mini-lot
 de quelques dizaines ou centaines d’exemples tirés au hasard :
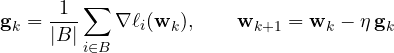
 est une estimation non biaisée du vrai gradient (la moyenne d’un échantillon aléatoire a pour espérance la moyenne de la population), avec une variance qui décroît comme
 . Le bruit n’est pas seulement un défaut : il aide à sortir des régions plates et, selon de nombreuses études, conduit à des minima « plus larges » qui généralisent mieux. Un passage complet sur les données s’appelle une époque (epoch).
Le momentum
Dans une vallée étroite, le gradient pointe surtout vers les parois : la descente rebondit d’un côté à l’autre et avance lentement le long du fond. Le momentum (Polyak, 1964 : la « méthode de la bille lourde ») accumule une vitesse :

avec  . Les composantes du gradient qui changent de signe à chaque pas (à travers la vallée) s’annulent dans la moyenne ; celles qui ont toujours le même signe (le long de la vallée) s’additionnent. Si le gradient était constant, la vitesse tendrait vers
 : avec
 , un pas dix fois plus long dans la bonne direction.
RMSProp et Adam : un pas par paramètre
Des paramètres différents peuvent avoir des gradients d’échelles très différentes (par exemple les poids des premières couches et ceux des dernières). RMSProp (Hinton, 2012) divise le pas de chaque paramètre par une moyenne mobile de la racine de son gradient au carré : ceux qui ont de grands gradients font des pas plus courts, ceux qui en ont de petits des pas plus longs. Adam (Kingma et Ba, 2014) combine cette idée avec le momentum :
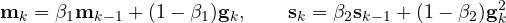

avec les valeurs par défaut  ,
 ,
 . Le pas effectif est presque indépendant de l’échelle du gradient : il vaut environ
 dans la direction du signe du gradient moyen.
Théorème (correction du biais). Si les gradients ont une moyenne constante  et
 , alors
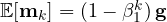 ; donc
 a exactement pour moyenne
 .
Démonstration. En déroulant la récurrence, 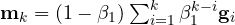 . En prenant la moyenne,
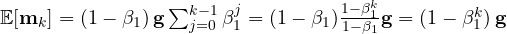 . Il en va de même pour
 avec
 . ∎
Sans correction, dans les premiers pas,  et
 seraient très proches de zéro (ils partent de zéro) et, surtout avec , le dénominateur serait sous-estimé : les premiers pas seraient énormes. Après quelques milliers de pas,
 et la correction n’a plus d’importance. AdamW (2017) sépare la pénalité sur les poids (weight decay) du pas adaptatif, et c’est aujourd’hui le choix par défaut pour les transformers.
Le pas dans le temps
Un grand pas constant avance vite mais, à la fin, « danse » autour du minimum ; un petit pas est précis mais lent. C’est pourquoi on fait varier le pas pendant l’entraînement :
- démarrage progressif (warm-up) : pendant quelques centaines ou milliers de pas, le pas croît de zéro à sa pleine valeur, tandis que les estimations d’Adam se stabilisent et que le réseau quitte la phase initiale chaotique ;
- décroissance : linéaire, par paliers, ou cosinus (le pas suit une demi-période de cosinus jusqu’à presque zéro). On l’a vue aussi dans le PPO du cours d’apprentissage par renforcement : le pas qui décroît jusqu’à zéro a stabilisé la politique finale.
La comparaison sur la fonction de Rosenbrock
La fonction 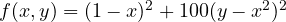 a son minimum en (1, 1) au fond d’une vallée étroite, courbe, en forme de banane : au fond de la vallée, le gradient est presque nul, sur les parois énorme. En partant de (−1,5 ; 2), on compte combien de pas sont nécessaires pour atteindre
 :
| méthode | pas | pas pour |
|---|---|---|
| descente de gradient | 0.001 | 15 681 |
| momentum () | 0.001 | 1 484 |
| Adam | 0.02 | 2 286 |
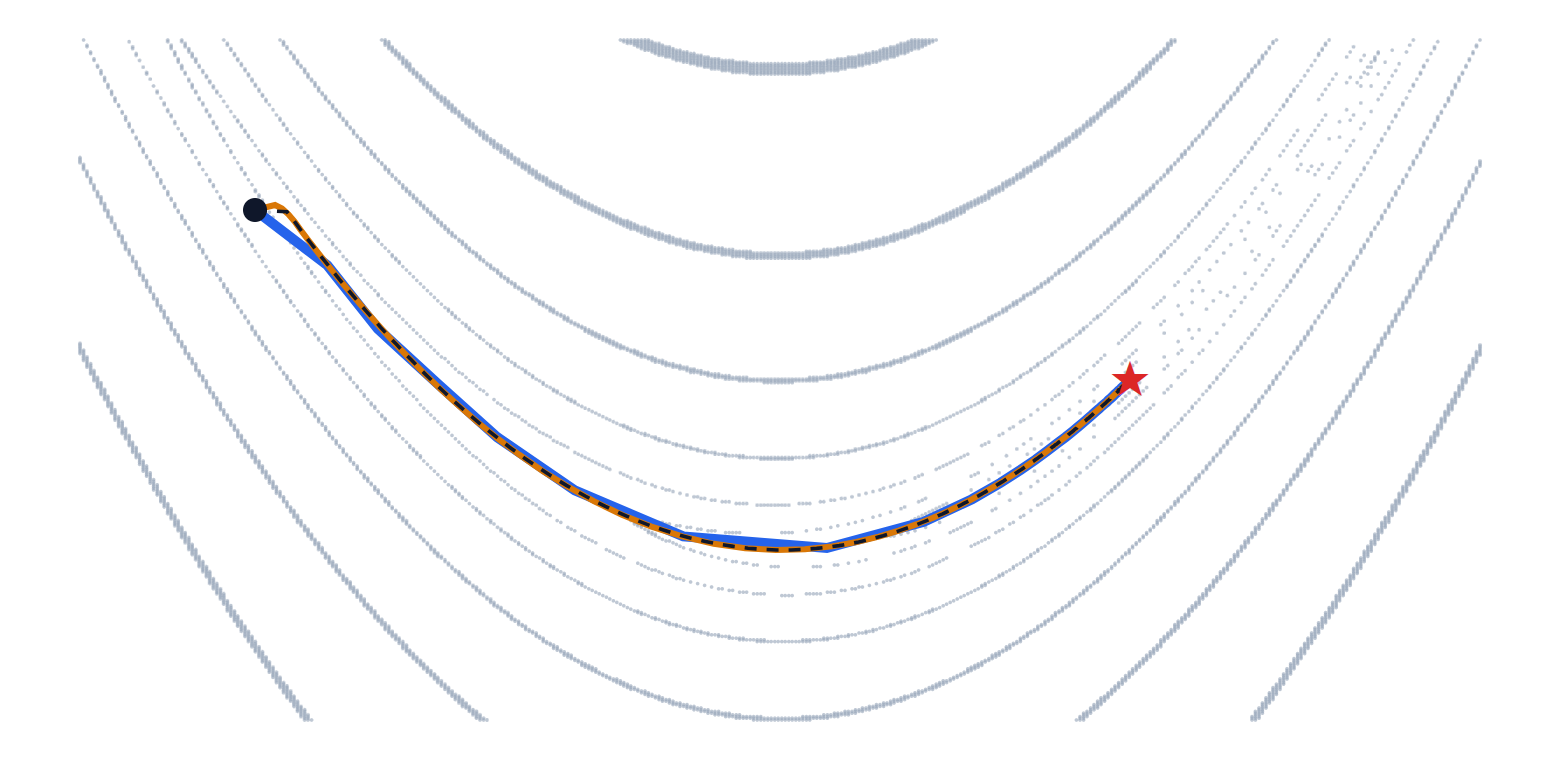
Le momentum est environ dix fois plus rapide que la descente simple (15 681 / 1 484 = 10,6), comme le prédit le facteur  . Adam, avec un pas qui ne dépend pas de l’échelle du gradient, arrive en un nombre de pas semblable. Sur de vrais réseaux de neurones, les différences sont souvent moins nettes et dépendent du problème : la SGD avec momentum est encore très utilisée pour les réseaux convolutifs, Adam et AdamW pour les transformers et les réseaux récurrents. Le choix du pas compte presque toujours plus que le choix de l’optimiseur.
import numpy as np

f = lambda p: (1 - p[0]) ** 2 + 100 * (p[1] - p[0] ** 2) ** 2
grad = lambda p: np.array([-2 * (1 - p[0]) - 400 * p[0] * (p[1] - p[0] ** 2), 200 * (p[1] - p[0] ** 2)])

def optimise(method, eta, steps=20000):
    p, v, m, s = np.array([-1.5, 2.0]), np.zeros(2), np.zeros(2), np.zeros(2)
    for k in range(1, steps + 1):
        g = grad(p)
        if method == "gradient":
            p = p - eta * g
        elif method == "momentum":
            v = 0.9 * v + g
            p = p - eta * v
        else:                                              # Adam
            m = 0.9 * m + 0.1 * g
            s = 0.999 * s + 0.001 * g * g
            m_hat, s_hat = m / (1 - 0.9 ** k), s / (1 - 0.999 ** k)     # bias correction
            p = p - eta * m_hat / (np.sqrt(s_hat) + 1e-8)
        if f(p) < 1e-6:
            return k
    return None

for method, eta in (("gradient", 1e-3), ("momentum", 1e-3), ("adam", 2e-2)):
    print(f"{method:9s}: f < 1e-6 after {optimise(method, eta)} steps")




Ciao, sono l'autore di «Gli ottimizzatori: SGD, momentum, RMSProp e Adam con la correzione della distorsione». Domande, dubbi, segnalazioni di errori o richieste di approfondimento sono benvenuti: scriveteli qui sotto e vi rispondo io. Potete anche votare la pagina con le stelle all'inizio dell'articolo.Hi, I am the author of “Optimisers: SGD, momentum, RMSProp and Adam with bias correction”. Questions, doubts, error reports and requests for more detail are all welcome: write them below and I will answer. You can also rate the page with the stars at the top of the article.