Réseaux convolutifs : convolution, équivariance par translation, pooling et dimensions
La convolution à deux dimensions, l'équivariance par translation démontrée, le pooling, les formules de dimension et du nombre de paramètres, LeNet, AlexNet et ResNet, réseau dense contre CNN sur des chiffres manuscrits.
https://www.electronics-engineering.com/fr/reseaux-convolutifs-cnn-equivariance-pooling/
Une image couleur d’un mégapixel contient trois millions de valeurs : un réseau dense avec mille neurones dans la première couche aurait trois milliards de poids rien que là, et devrait apprendre séparément qu’un chat en haut à gauche et un chat en bas à droite sont la même chose. Les réseaux convolutifs (CNN) résolvent les deux problèmes avec deux idées venues du traitement du signal : les poids sont locaux (chaque neurone ne regarde qu’une petite zone) et partagés (le même filtre glisse sur toute l’image). Cette leçon définit la convolution, démontre la propriété qui rend les CNN adaptés aux images (l’équivariance par translation), établit les formules de dimension et compare un CNN à un réseau dense sur des chiffres manuscrits.
La convolution
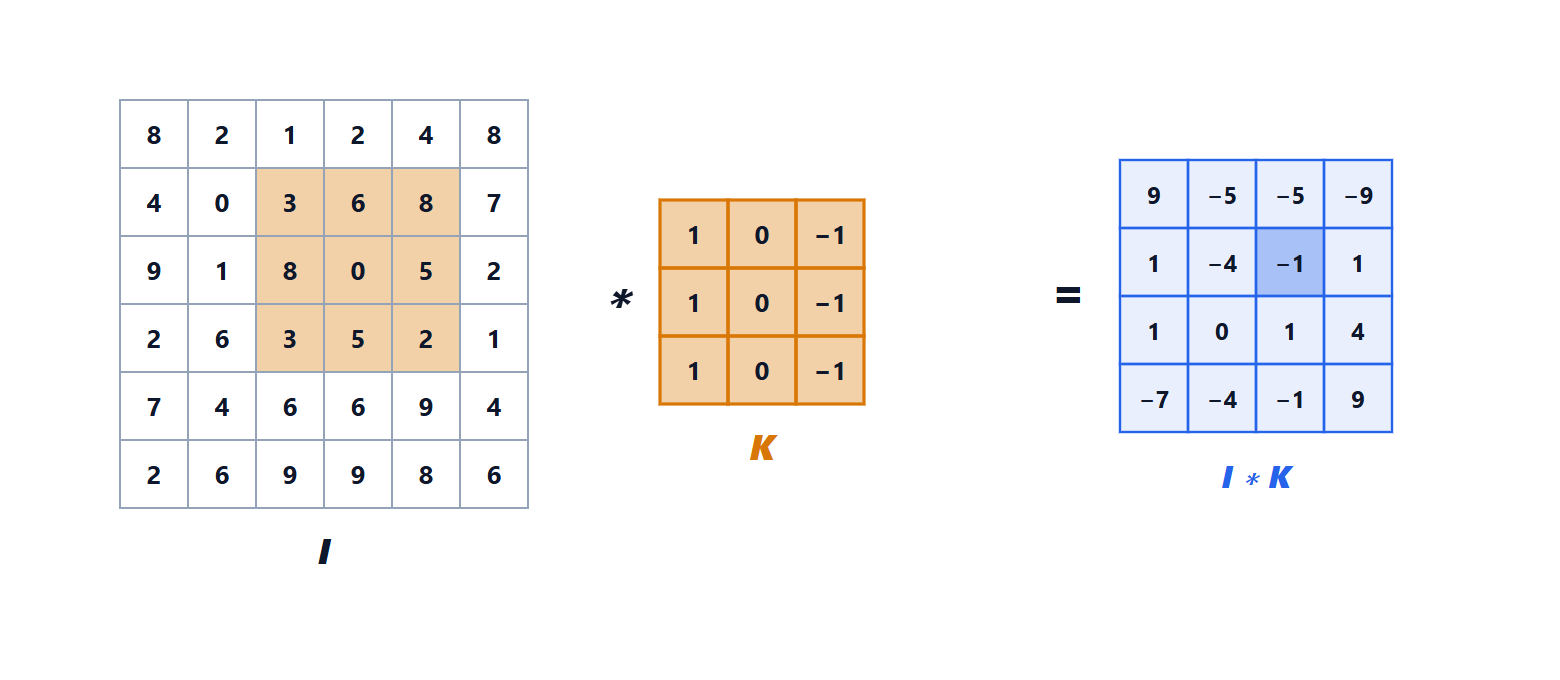
Une couche convolutive applique un petit filtre (noyau)  , par exemple 3×3, à chaque position de l’image
 :
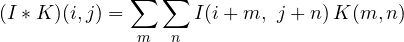
(les réseaux de neurones utilisent cette forme, qui est à proprement parler une corrélation ; la vraie convolution a le filtre retourné, mais comme le filtre est appris, la différence n’a pas d’importance). C’est le même filtre FIR du traitement numérique du signal, en deux dimensions. Avec plusieurs canaux d’entrée (les trois couleurs, ou les sorties de la couche précédente), le filtre a un canal pour chacun et les contributions sont sommées ; avec plusieurs filtres, on obtient plusieurs cartes de caractéristiques (feature maps) en sortie.
Un filtre 3×3 de valeurs  sur chaque ligne, par exemple, répond aux bords verticaux. On ne donne pas au réseau des filtres écrits à la main : il les apprend par rétropropagation, et dans les premières couches d’un CNN entraîné apparaissent des détecteurs de bords et de taches de couleur ; dans les couches suivantes, des combinaisons de plus en plus complexes (coins, textures, parties d’objets).
Pourquoi ça marche : l’équivariance par translation
Théorème. La convolution commute avec les translations : si l’image est décalée, la carte de sortie se décale de la même quantité. Avec  la translation
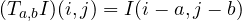 :
 .
Démonstration. 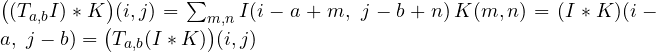 . ∎
Un détecteur d’œil appris dans un coin de l’image fonctionne automatiquement partout : il n’a pas besoin d’être réappris pour chaque position. Ce biais inductif (une connaissance préalable du problème, intégrée dans la structure du réseau) réduit beaucoup les paramètres et les données nécessaires. Pour obtenir aussi une invariance partielle (même réponse même si l’objet bouge), on ajoute le pooling : le max-pooling 2×2 remplace chaque bloc 2×2 de valeurs par le maximum, ce qui divise la taille par deux et rend le réseau insensible aux petits décalages.
Les dimensions
Pour une entrée de côté  , un filtre de côté
 , un remplissage (padding)
 (bordure de zéros ajoutée) et un pas (stride)
 , le côté de la sortie est

(le filtre part de la position 0 et peut faire  déplacements). Avec
 ,
 ,
 , la sortie a la même taille que l’entrée. Une couche avec
 canaux d’entrée et
 filtres a
 paramètres, indépendamment de la taille de l’image. Le champ récepteur (la zone d’entrée qui influence un neurone) croît de
 pixels pour chaque couche 3×3 et double à chaque pooling : en empilant les couches, les neurones profonds « voient » toute l’image.
Les architectures historiques montrent l’évolution : LeNet (1998) lisait les codes postaux ; AlexNet (2012) a remporté le concours ImageNet avec une marge énorme en utilisant des GPU et la ReLU, ouvrant l’ère de l’apprentissage profond ; ResNet (2015) a ajouté les connexions résiduelles 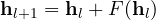 , qui permettent au gradient de traverser des centaines de couches sans s’évanouir.
L’expérience : réseau dense contre réseau convolutif
Sur les 1797 chiffres manuscrits 8×8 de scikit-learn (1347 pour l’entraînement, 450 pour le test), deux réseaux entraînés avec Adam pendant 60 époques :
- réseau dense : 64 entrées → 64 neurones ReLU → 10 sorties ;
- CNN : deux couches convolutives 3×3 (8 et 16 filtres) avec ReLU, un max-pooling 2×2, une couche dense finale.
| réseau | paramètres | précision en test | avec l’image décalée d’un pixel |
|---|---|---|---|
| dense | 4 810 | 96,9 % | 42,9 % |
| convolutif | 3 818 | 98,2 % | 65,1 % |
Le CNN est plus précis avec moins de paramètres, parce que la structure convolutive lui dit déjà que les pixels voisins doivent être regardés ensemble. En décalant d’un pixel vers la droite toutes les images de test (un changement minime pour un œil humain), le réseau dense s’effondre à 43 % : il a appris « ce pixel allumé veut dire 7 », pas la forme. Le CNN résiste mieux mais perd quand même beaucoup, parce que sur des images 8×8 un pixel représente plus de 10 % de la largeur et que le pooling ne donne qu’un peu d’invariance. En pratique, on ajoute l’augmentation de données : on s’entraîne aussi sur des copies décalées, tournées, mises à l’échelle des images.
import numpy as np, torch, torch.nn as nn
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split

d = load_digits()
Xa, Xp, ya, yp = train_test_split(d.data / 16.0, d.target, test_size=0.25, random_state=0, stratify=d.target)
Xa, Xp = torch.tensor(Xa, dtype=torch.float32), torch.tensor(Xp, dtype=torch.float32)
ya, yp = torch.tensor(ya), torch.tensor(yp)

def train(model, epochs=60):
    torch.manual_seed(0)
    opt = torch.optim.Adam(model.parameters(), lr=1e-3)
    for _ in range(epochs):
        perm = torch.randperm(len(Xa))
        for i in range(0, len(Xa), 64):
            idx = perm[i:i + 64]
            loss = nn.functional.cross_entropy(model(Xa[idx]), ya[idx])
            opt.zero_grad(); loss.backward(); opt.step()
    return model

def accuracy(model, X):
    with torch.no_grad():
        return float((model(X).argmax(1) == yp).float().mean())

torch.manual_seed(0)
dense = nn.Sequential(nn.Linear(64, 64), nn.ReLU(), nn.Linear(64, 10))
torch.manual_seed(0)
cnn = nn.Sequential(nn.Unflatten(1, (1, 8, 8)),                    # from 64 values to a 1x8x8 image
                    nn.Conv2d(1, 8, 3, padding=1), nn.ReLU(),       # 8 filters 3x3
                    nn.Conv2d(8, 16, 3, padding=1), nn.ReLU(),      # 16 filters 3x3x8
                    nn.MaxPool2d(2),                                # 8x8 -> 4x4
                    nn.Flatten(), nn.Linear(16 * 4 * 4, 10))
train(dense); train(cnn)

shifted = torch.roll(Xp.view(-1, 8, 8), 1, dims=2)                  # all digits one pixel to the right
shifted[:, :, 0] = 0
shifted = shifted.view(-1, 64)
for name, m in (("dense", dense), ("convolutional", cnn)):
    n = sum(p.numel() for p in m.parameters())
    print(f"{name:15s}: {n} parameters, test {accuracy(m, Xp):.4f}, shifted {accuracy(m, shifted):.4f}")


Benvenuti nella pagina su «Le reti convoluzionali: convoluzione, equivarianza alle traslazioni, pooling e dimensioni». L'ho scritta pensando a chi studia ingegneria elettronica: se un passaggio non vi torna, un esercizio vi dà un risultato diverso o volete altro materiale sull'argomento, chiedete pure nei commenti e vi risponderò. Un voto con le stelle qui sopra mi aiuta a capire quali pagine migliorare.Welcome to the page on “Convolutional networks: convolution, translation equivariance, pooling and sizes”. I wrote it for engineering students: if a step does not add up, an exercise gives you a different result or you would like more material on the topic, just ask in the comments and I will reply. A star rating above helps me understand which pages to improve.