L'entraînement en pratique : données, initialisation de He, normalisation, dropout et métriques
Entraînement, validation et test, l'initialisation de He démontrée et mesurée sur 20 couches, normalisation par lot et par couche, dropout, quantité de données, précision, rappel et F1, recherche d'hyperparamètres, avec des expériences honnêtes.
https://www.electronics-engineering.com/fr/entrainement-en-pratique-initialisation-dropout-metriques/
Entre la théorie des leçons précédentes et un réseau qui fonctionne vraiment, il y a de nombreux choix pratiques : comment répartir les données, comment initialiser les poids, comment normaliser, comment éviter le surapprentissage, comment mesurer le résultat. Cette leçon les présente avec leurs raisons mathématiques et avec des expériences mesurées, y compris celles qui ne confirment pas les attentes : dans l’entraînement des réseaux, de nombreuses « astuces » fonctionnent sur certains problèmes et pas sur d’autres, et le seul moyen de savoir est de mesurer.
La répartition des données
Les données se répartissent en trois parties : l’entraînement (pour les poids), la validation (pour les choix : taille du réseau, pas, régularisation, quand s’arrêter) et le test, utilisé une seule fois à la fin pour estimer la performance sur de nouvelles données. Si l’on fait des choix en regardant l’ensemble de test, le test devient une seconde validation et l’estimation est optimiste. Avec peu de données, on utilise la validation croisée : on divise l’ensemble en  parties, on entraîne fois en laissant de côté une partie différente, et l’on fait la moyenne des résultats. Deux avertissements pratiques : la répartition doit être faite avant toute normalisation (moyenne et variance se calculent seulement sur l’ensemble d’entraînement), et pour des données dans le temps (séries de capteurs), le test doit venir après les données d’entraînement, pas mélangé à elles.
L’initialisation des poids
Si les poids initiaux sont trop petits, les activations (et les gradients) s’évanouissent couche après couche ; s’ils sont trop grands, ils explosent. La bonne initialisation maintient la variance constante.
Théorème (initialisation de He, 2015). Dans un réseau à activations ReLU, avec des poids indépendants de moyenne nulle et  entrées par neurone, la variance des sommes pondérées reste constante d’une couche à la suivante si
 .
Démonstration. Pour un neurone  avec
 indépendant de
 et de moyenne nulle,
 . Avec
 et
 symétrique autour de zéro, la ReLU laisse passer la moitié de la distribution :
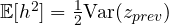 . Donc
 , qui reste la même si
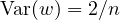 . ∎
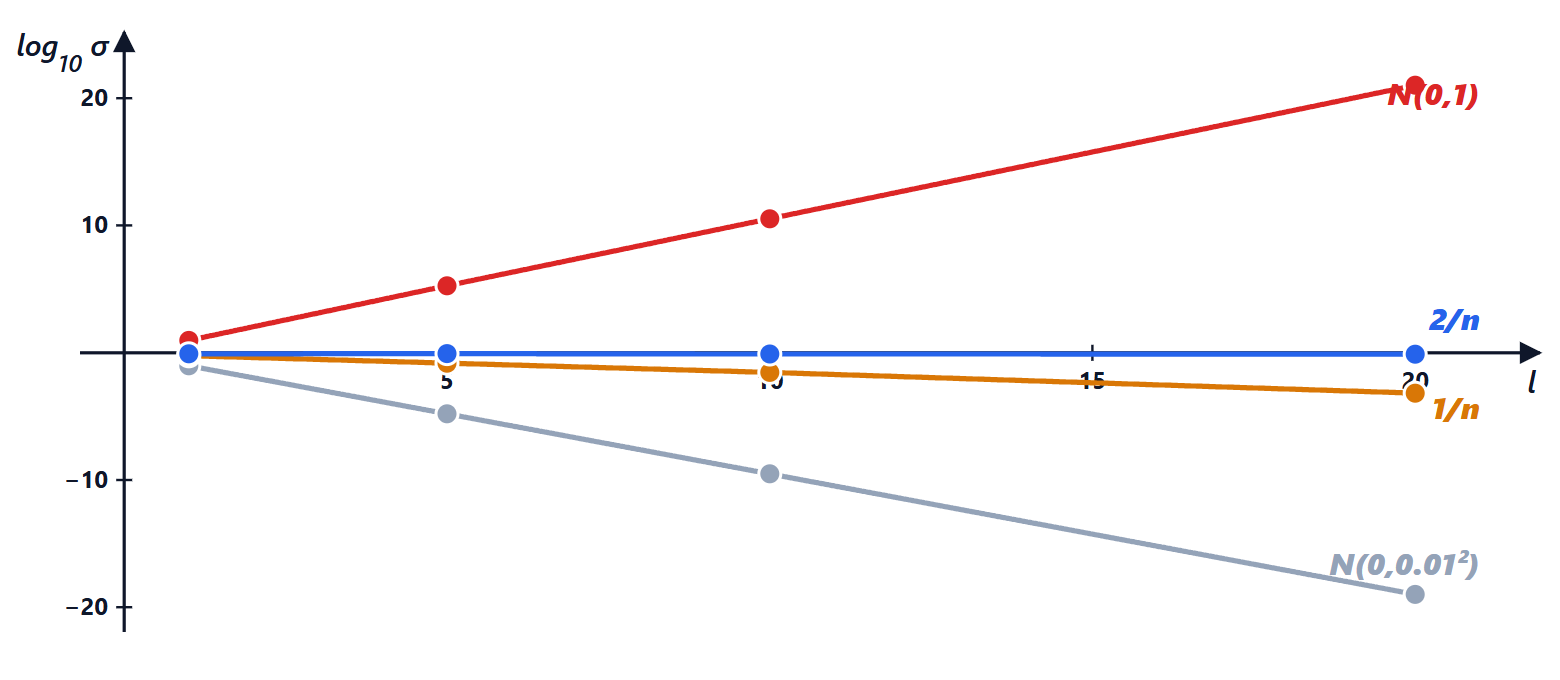
Pour des activations symétriques comme la tanh, le facteur 1/2 est absent et l’on obtient  (Xavier ou Glorot, 2010). Expérience : 20 couches de 256 neurones ReLU, écart-type des activations :
| poids | après 1 couche | après 5 | après 10 | après 20 |
|---|---|---|---|---|
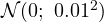 | 0.094 |  |  |  |
 | 9.35 |  |  |  |
Xavier,  | 0.58 | 0.15 | 0.028 | 0.00067 |
He,  | 0.83 | 0.86 | 0.80 | 0.76 |
Avec la ReLU, seule l’initialisation de He préserve le signal ; celle de Xavier le divise par deux (en variance) à chaque couche, exactement le facteur 1/2 de la démonstration.
La normalisation
La normalisation par lot (batch normalization, 2015) normalise les sommes pondérées de chaque neurone sur le mini-lot (moyenne 0, variance 1) puis les remet à l’échelle avec deux paramètres appris. Elle rend l’entraînement bien moins sensible à l’initialisation et au pas, et permet des pas plus grands. Dans les transformers, on utilise la normalisation par couche (layer normalization), qui normalise sur les composantes d’un seul exemple au lieu de le faire sur le lot, et fonctionne même avec de petits lots et des séquences de longueur variable. Les entrées aussi doivent être normalisées : des variables d’échelles très différentes (une température en kelvins et une tension en millivolts) dégradent le conditionnement (leçon 1).
Contre le surapprentissage
- Plus de données : le remède le plus efficace de tous, comme le montre l’expérience ci-dessous.
- Augmentation de données : de nouvelles copies des exemples transformées de façons qui ne changent pas la réponse (décalages, rotations, bruit, changements d’éclairage).
- Weight decay : la pénalité
 de la leçon 1.
- Dropout (Srivastava et al., 2014) : pendant l’entraînement, chaque neurone est éteint au hasard avec une probabilité
 , et les neurones restants sont multipliés par
 . Ainsi, la valeur attendue de chaque sortie est la même avec et sans dropout :
 , et à l’usage, tout le réseau est utilisé sans corrections. L’idée est d’empêcher les neurones de « s’appuyer » les uns sur les autres.
- Arrêt précoce (early stopping) : on surveille l’erreur de validation pendant l’entraînement et l’on arrête quand elle commence à monter.
Les expériences. Réseau dense 64 → 1024 → 1024 → 10 sur les chiffres 8×8, entraîné pendant 300 pas sur des sous-ensembles de taille croissante, précision sur les 450 chiffres de test (moyenne sur 3 graines) :
| exemples d’entraînement | 50 | 100 | 200 | 400 | 1347 |
|---|---|---|---|---|---|
| précision en test | 76,4 % | 89,5 % | 91,9 % | 95,5 % | 97,0 % |
Le dropout (p = 0,5), sur le même réseau avec 100 exemples, a donné 89,5 % contre 89,1 % sans (moyenne sur 5 graines) : aucune différence mesurable ; avec 50 exemples, 77,8 % contre 77,9 %. Le weight decay avec  l’a légèrement dégradé (86,0 %). Sur ce problème, petit et déjà facile, la régularisation compte peu et la quantité de données compte beaucoup. Sur de très grands réseaux et des problèmes plus difficiles (images ImageNet, modèles de langage), le dropout et le weight decay donnent en revanche des bénéfices mesurables. La morale est celle de la leçon : il faut essayer les techniques sur son propre problème, avec une validation honnête.
Les métriques
La précision globale (accuracy, la fraction de bonnes réponses) est trompeuse quand les classes sont déséquilibrées : si une panne survient dans 1 % des cas, un classifieur qui dit toujours « pas de panne » a 99 % de précision globale et est inutile. Pour une classe « positive », avec TP, FP, FN les vrais positifs, les faux positifs et les faux négatifs :

La précision (precision) dit combien d’alarmes sont vraies, le rappel (recall) combien de cas vrais sont trouvés. Déplacer le seuil de décision échange l’un contre l’autre ; ce qui compte le plus dépend de l’application (dans un système de freinage d’urgence, un faux négatif est bien plus grave qu’un faux positif, dans un filtre antispam, c’est l’inverse). La matrice de confusion, utilisée dans la dernière leçon, montre toutes les erreurs classe par classe.
Le choix des hyperparamètres
Le pas, les tailles, la régularisation, la taille de lot sont des hyperparamètres : ils ne sont pas appris par le gradient, on les choisit en comparant les résultats sur l’ensemble de validation. La recherche aléatoire (Bergstra et Bengio, 2012) est en général meilleure que la recherche en grille : si seuls quelques hyperparamètres comptent vraiment, essayer des valeurs aléatoires explore beaucoup plus de valeurs différentes des importants. Le pas se cherche sur une échelle logarithmique ( ,
 ,
 , …).
import numpy as np, torch, torch.nn as nn
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split

# 1) initialisation: standard deviation of the activations through 20 ReLU layers
g = np.random.default_rng(0)
h0 = g.normal(0, 1, (1000, 256))
for name, std in (("N(0, 0.01^2)", lambda n: 0.01), ("N(0, 1)", lambda n: 1.0),
                  ("Xavier 1/n", lambda n: np.sqrt(1 / n)), ("He 2/n", lambda n: np.sqrt(2 / n))):
    h, values = h0.copy(), []
    for layer in range(20):
        h = np.maximum(h @ g.normal(0, std(256), (256, 256)), 0)
        values.append(h.std())
    print(f"{name:13s}: after 1, 5, 10, 20 layers {values[0]:.3g}, {values[4]:.3g}, {values[9]:.3g}, {values[19]:.3g}")

# 2) amount of data: the same network trained on larger and larger subsets
d = load_digits()
Xa, Xp, ya, yp = train_test_split(d.data / 16.0, d.target, test_size=0.25, random_state=0, stratify=d.target)
Xa, Xp = torch.tensor(Xa, dtype=torch.float32), torch.tensor(Xp, dtype=torch.float32)
ya, yp = torch.tensor(ya), torch.tensor(yp)

def trial(n, seed, dropout=0.0):
    torch.manual_seed(seed)
    layers = [nn.Linear(64, 1024), nn.ReLU()] + ([nn.Dropout(dropout)] if dropout else []) \
           + [nn.Linear(1024, 1024), nn.ReLU()] + ([nn.Dropout(dropout)] if dropout else []) + [nn.Linear(1024, 10)]
    net = nn.Sequential(*layers)
    opt = torch.optim.Adam(net.parameters(), lr=1e-3)
    idx = torch.randperm(len(Xa), generator=torch.Generator().manual_seed(seed))[:n]
    for _ in range(300):                                   # 300 steps on the whole subset
        net.train()
        loss = nn.functional.cross_entropy(net(Xa[idx]), ya[idx])
        opt.zero_grad(); loss.backward(); opt.step()
    net.eval()                                             # dropout is off in use
    with torch.no_grad():
        return float((net(Xp).argmax(1) == yp).float().mean())

for n in (50, 100, 200, 400, 1347):
    print(f"{n:4d} examples: test accuracy {np.mean([trial(n, s) for s in range(3)]):.3f}")




Sono l'autore di questa pagina su «L’addestramento in pratica: dati, inizializzazione di He, normalizzazione, dropout e metriche». Se qualcosa non è chiaro, se vi serve un esempio in più o volete approfondire un punto, scrivetelo qui sotto nei commenti: rispondo personalmente. Se la pagina vi è stata utile, lasciate un voto con le stelle in cima all'articolo.I am the author of this page on “Training in practice: data, He initialisation, normalisation, dropout and metrics”. If something is unclear, if you need another example or want to go deeper into a point, write it in the comments below: I answer personally. If the page was useful, leave a star rating at the top of the article.