Index : arbres B+, hachage et optimisation des requêtes
Pages et coût d'accès, arbres B+ avec démonstration de la hauteur et un exemple sur un milliard de lignes, hachage, index primaires, secondaires et composites, coût sur les écritures, l'optimiseur et EXPLAIN.
https://www.electronics-engineering.com/fr/index-arbres-b-plus-optimiseur-de-requetes/
Une table d’un milliard de lignes peut être lue en entier, mais cela prend des minutes. Trouver le client d’un code donné en quelques millisecondes demande un index, comme celui d’un livre. Dans cette leçon, nous regardons comment une base de données organise les données sur le disque, les arbres B+ avec la démonstration de leur hauteur et un exemple numérique, les index de hachage, les index composites et la règle du préfixe, le coût des index sur les écritures et le travail de l’optimiseur.
Pages et accès
Le SGBD lit et écrit les données par pages (blocs) de quelques kilo-octets, typiquement 4-16 Ko. Le coût d’une requête se mesure en pages lues, parce qu’un accès au disque est des milliers de fois plus lent qu’une opération en mémoire : environ 10 ms sur un disque magnétique, 0,1 ms sur un SSD. Un tampon (buffer) en mémoire garde les pages les plus utilisées. Sans index, chercher une valeur exige un balayage (scan) de toute la table : pour un milliard de lignes de 100 octets, 100 Go.
Les arbres B+
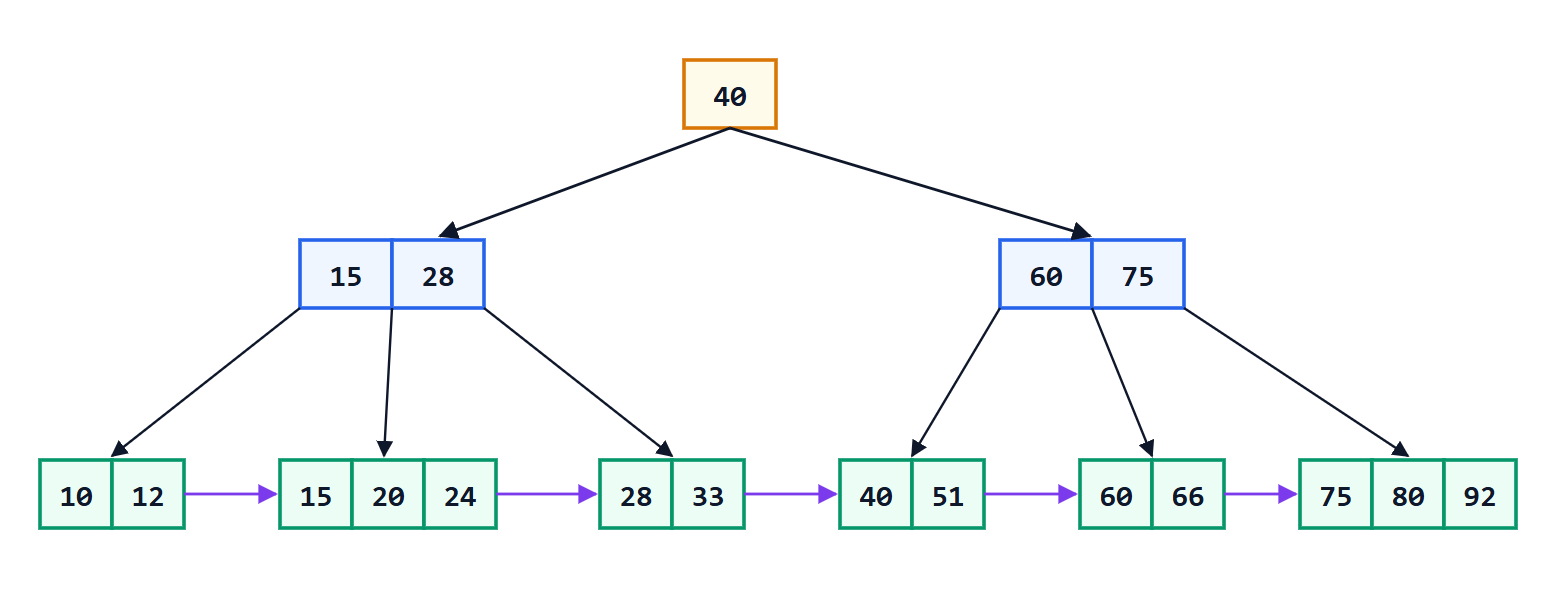
L’index le plus utilisé est l’arbre B+ : un arbre équilibré dont chaque nœud occupe une page et contient de nombreuses clés ordonnées avec des pointeurs vers les enfants. Les feuilles contiennent les clés avec des références aux lignes (ou les lignes elles-mêmes) et sont reliées en une liste ordonnée. Tout nœud sauf la racine est rempli au moins à moitié, et toutes les feuilles sont à la même profondeur.
Théorème. Un arbre B+ de  clés dans ses feuilles, où chaque nœud interne a au plus
 enfants et au moins
 (la racine au moins 2), a une hauteur
 qui satisfait
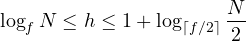
Démonstration. *Borne inférieure.* Chaque niveau multiplie le nombre de nœuds par au plus , donc un arbre de hauteur a au plus  positions de feuilles : pour contenir clés il faut
 , c’est-à-dire
 . *Borne supérieure.* La racine a au moins 2 enfants et tout autre nœud interne au moins : au niveau des feuilles il y a au moins
 nœuds, donc (avec des feuilles remplies au moins à moitié) au moins autant de portions de clés. De
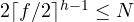 on tire
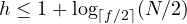 . ∎
Le point essentiel est le facteur de branchement (fan-out) : avec des pages de 8 Ko et des clés de 40 octets avec leurs pointeurs, vaut environ 200. Exemple. Avec  clés,
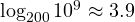 : 4 niveaux suffisent, et même dans le pire cas, avec des nœuds à moitié pleins, il en faut 5. Les deux ou trois premiers niveaux, quelques milliers de pages, restent toujours dans le tampon : trouver une ligne parmi un milliard coûte une ou deux lectures sur disque. Les insertions et les suppressions gardent l’arbre équilibré en scindant les nœuds pleins et en fusionnant ceux qui sont trop vides, à un coût lui aussi logarithmique.
Les feuilles reliées rendent aussi efficaces les recherches par intervalle (« notes entre 25 et 28 », « commandes de mars ») ainsi que le tri : on trouve la première valeur et l’on parcourt la liste.
Les index de hachage
Un index de hachage calcule à partir de chaque clé, avec une fonction de hachage, le numéro du seau où la chercher : en moyenne un seul accès, quelle que soit la taille de la table. Mais il ne fonctionne que pour les recherches d’égalité : les clés sont dispersées au hasard entre les seaux, et il ne sert à rien pour les intervalles et le tri. C’est pourquoi les SGBD utilisent presque toujours des arbres B+, et les index de hachage dans des cas particuliers, comme les jointures en mémoire.
Index primaires, secondaires et composites
Un index primaire (ou groupé, clustered) détermine l’ordre physique des lignes dans la table : les lignes de clés voisines sont dans les mêmes pages, et un intervalle se lit avec quelques pages consécutives. Il ne peut y en avoir qu’un. Les index secondaires contiennent des références à des lignes dispersées : lire beaucoup de lignes par un index secondaire peut coûter plus qu’un balayage, une page différente pour chaque ligne.
Un index composite sur plusieurs colonnes, par exemple (nom, prénom), est trié d’abord par nom et, à nom égal, par prénom. Il sert les recherches par nom, ou par nom et prénom, mais pas celles par prénom seul, qui est dispersé dans tout l’index : c’est la règle du préfixe le plus à gauche.
Le prix des index
Chaque index accélère les lectures mais ralentit les écritures : chaque insertion, mise à jour ou suppression doit mettre à jour tous les index de la table, et chaque index occupe de la place. On indexe donc les colonnes réellement utilisées dans les conditions de recherche et de jointure, en particulier les clés étrangères, et non toutes les colonnes « au cas où ».
L’optimiseur
Pour chaque requête, le SGBD évalue de nombreux plans d’exécution équivalents (quel index utiliser, dans quel ordre joindre les tables, avec quel algorithme de jointure) et choisit celui de moindre coût estimé, en s’appuyant sur des statistiques sur les données : nombre de lignes, valeurs distinctes, distribution. Un index est rentable quand la condition est sélective, c’est-à-dire qu’elle sélectionne une petite fraction des lignes, typiquement moins de 5-10 % ; sinon, un balayage séquentiel est plus rapide. La commande EXPLAIN montre le plan choisi, et c’est le premier outil quand une requête est lente : on découvre souvent un balayage complet là où l’on attendait un index, à cause d’une colonne non indexée ou d’une condition écrite de façon à empêcher l’usage de l’index, comme une fonction appliquée à la colonne.


Sono l'autore di questa pagina su «Indici: alberi B+, hash e ottimizzazione delle interrogazioni». Se qualcosa non è chiaro, se vi serve un esempio in più o volete approfondire un punto, scrivetelo qui sotto nei commenti: rispondo personalmente. Se la pagina vi è stata utile, lasciate un voto con le stelle in cima all'articolo.I am the author of this page on “Indexes: B+ trees, hashing and query optimisation”. If something is unclear, if you need another example or want to go deeper into a point, write it in the comments below: I answer personally. If the page was useful, leave a star rating at the top of the article.