Données distribuées : réplication, théorème CAP, NoSQL et entrepôts de données
Réplication synchrone et asynchrone, la condition de quorum démontrée, le théorème CAP démontré, cohérence à terme et NoSQL, entrepôts de données, schéma en étoile et OLAP, protection des données personnelles.
https://www.electronics-engineering.com/fr/donnees-distribuees-quorum-theoreme-cap-entrepot-de-donnees/
Les grands systèmes d’information ne reposent pas sur un seul serveur : les données sont copiées sur plusieurs machines pour ne pas s’arrêter quand l’une tombe en panne, réparties sur de nombreux nœuds pour gérer des volumes énormes, et réorganisées dans des stockages séparés pour l’analyse. Dans cette leçon, nous regardons la réplication et la condition de quorum avec sa démonstration, le théorème CAP avec démonstration, la cohérence à terme et les bases NoSQL, les entrepôts de données avec le schéma en étoile et l’analyse OLAP, et la protection des données personnelles.
La réplication
Garder plusieurs copies des mêmes données sur des serveurs différents augmente la disponibilité (leçon sur les architectures) et permet de répartir les lectures. Le problème est de les garder alignées. Dans la réplication synchrone, une écriture n’est acquittée que lorsque toutes les copies l’ont reçue : les copies sont toujours identiques, mais chaque écriture attend le nœud le plus lent et se bloque si l’un ne répond pas. Dans la réplication asynchrone, l’écriture est acquittée aussitôt et propagée plus tard : rapide, mais pendant un instant une copie peut renvoyer d’anciennes données, et si le nœud primaire tombe en panne avant de propager, les dernières écritures sont perdues.
Les quorums
Une voie médiane : avec  copies, une écriture est acquittée quand
 copies l’ont reçue, et une lecture interroge
 copies et prend la valeur la plus récente (chaque valeur porte un numéro de version).
Théorème. Si  , chaque lecture voit la dernière écriture acquittée.
Démonstration. La dernière écriture acquittée se trouve sur un ensemble d’au moins copies ; la lecture interroge un ensemble de copies. Si les deux ensembles étaient disjoints, ils contiendraient ensemble copies distinctes, plus qu’il n’en existe : impossible. Donc au moins une copie interrogée a la dernière version, et la lecture, en prenant la version la plus récente, la renvoie. ∎
Avec  , le choix typique
 tolère la panne d’une copie pour les lectures comme pour les écritures ;
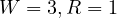 rend les lectures rapides et les écritures lentes.
Le théorème CAP
Dans un système distribué, on voudrait trois propriétés :
- la cohérence (C) : chaque lecture renvoie la dernière écriture, comme s’il n’y avait qu’une seule copie ;
- la disponibilité (A) : chaque requête adressée à un nœud qui fonctionne reçoit une réponse ;
- la tolérance au partitionnement (P) : le système continue de fonctionner même si le réseau se scinde en parties qui ne peuvent pas communiquer.
Théorème (CAP, Brewer, démontré par Gilbert et Lynch). Pendant un partitionnement du réseau, un système ne peut pas être à la fois cohérent et disponible.
Démonstration. Considérons deux nœuds qui ont chacun une copie de la donnée  , initialement 0, séparés par un partitionnement : aucun message ne passe entre eux. Un client écrit
 sur le premier nœud ; si le système est disponible, l’écriture reçoit une réponse. Puis un autre client lit sur le second nœud ; si le système est disponible, la lecture reçoit aussi une réponse. Mais le second nœud n’a rien pu recevoir du premier, donc il répond 0 : la cohérence est violée. Pour être cohérent, le système doit refuser ou retarder indéfiniment l’écriture ou la lecture, en renonçant à la disponibilité. ∎
Les partitionnements arrivent dans les réseaux réels, donc le vrai choix est entre C et A quand il y a un partitionnement : les banques et les systèmes de réservation choisissent la cohérence (mieux vaut refuser une opération que vendre deux fois la même place), les réseaux sociaux et les paniers d’achat choisissent la disponibilité.
Cohérence à terme et NoSQL
Les systèmes qui privilégient la disponibilité offrent la cohérence à terme (eventual consistency) : si aucune nouvelle écriture n’arrive, tôt ou tard toutes les copies convergent vers la même valeur. De nombreuses bases NoSQL, conçues pour répartir les données sur des centaines de nœuds, reposent sur ce modèle :
- clé-valeur (comme dans une table de hachage distribuée), pour les sessions et les caches ;
- les stockages de documents, qui contiennent des objets JSON à structure souple ;
- les stockages à familles de colonnes, pour d’énormes tables creuses ;
- les bases de graphes, pour des relations complexes comme les réseaux sociaux.
Elles renoncent en partie aux jointures et aux transactions sur plusieurs objets en échange de la capacité de montée en charge. Ces dernières années, les bases NewSQL et distribuées (avec des protocoles de consensus comme Raft et Paxos) offrent de nouveau des transactions ACID sur de nombreux nœuds, en payant la cohérence par un peu de latence.
L’entrepôt de données
Les systèmes opérationnels sont optimisés pour de nombreuses petites transactions ; les analyses de direction (« ventes par région et par trimestre sur les cinq dernières années ») lisent des millions de lignes et ralentiraient tout. On construit donc un entrepôt de données (data warehouse) : un stockage séparé, alimenté périodiquement par un processus d’extraction, transformation et chargement (ETL) qui nettoie et intègre les données des différentes sources.
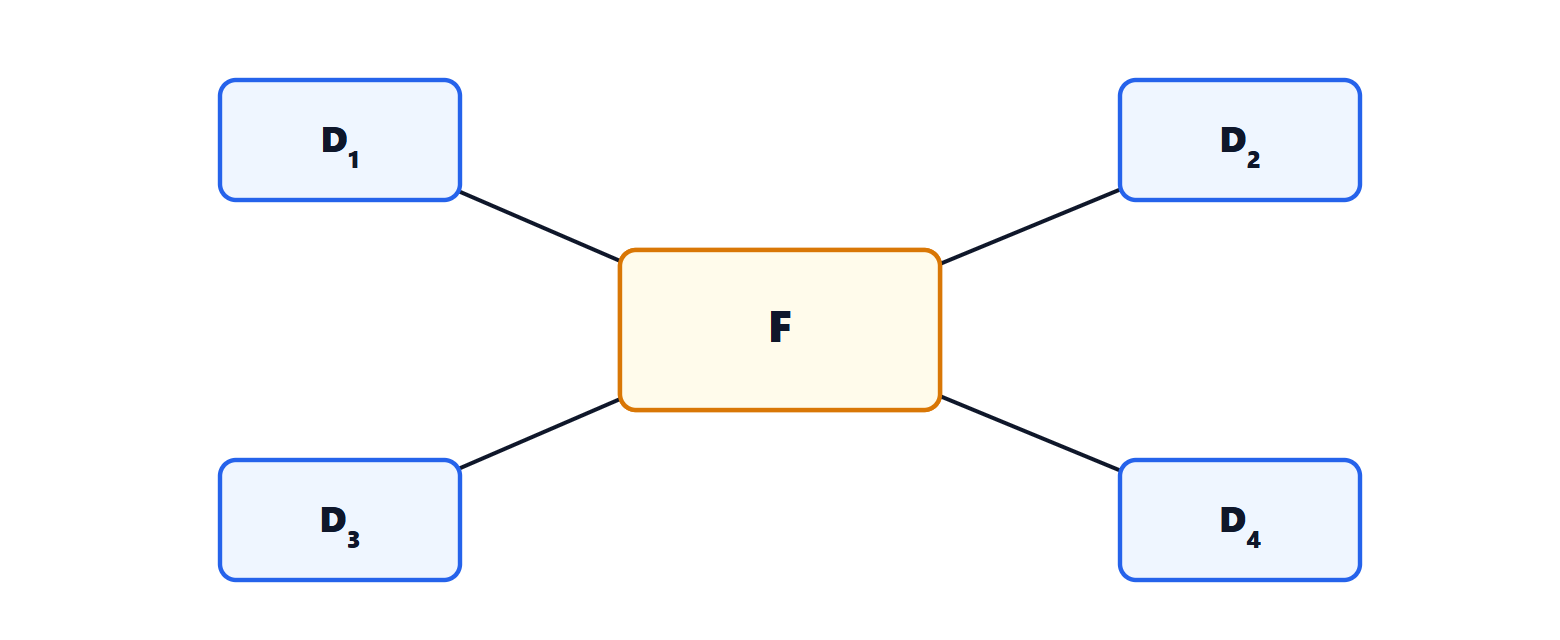
Le schéma typique est une étoile : une table de faits avec les mesures (montants, quantités) et les clés vers les tables de dimensions (temps, produit, client, lieu), volontairement non normalisées pour demander peu de jointures (leçon sur la normalisation). L’analyse OLAP navigue dans ce cube de données : consolider (des mois aux années), forer vers le détail (drill down), trancher selon une région (slice). Les systèmes modernes stockent les données par colonnes plutôt que par lignes : une requête qui additionne une seule colonne d’un milliard de lignes ne lit que cette colonne, compressée. Les lacs de données (data lakes), eux, conservent les données brutes, même non structurées, pour des analyses futures et pour l’apprentissage automatique.
La protection des données personnelles
Un système d’information qui traite des données de personnes doit respecter les règles de protection des données, en Europe le RGPD : ne collecter que les données nécessaires à une finalité déclarée (minimisation), ne les garder que le temps nécessaire, les protéger par des mesures adéquates (chiffrement, contrôle d’accès, journalisation des opérations), permettre aux personnes de les consulter, de les corriger et de demander leur effacement, et notifier les violations. La protection doit être conçue dès le départ (privacy by design), non ajoutée à la fin : le schéma même de la base de données, qui sépare les données d’identification des données d’usage et pseudonymise quand c’est possible, en fait partie.


Benvenuti nella pagina su «Dati distribuiti: replicazione, teorema CAP, NoSQL e data warehouse». L'ho scritta pensando a chi studia ingegneria elettronica: se un passaggio non vi torna, un esercizio vi dà un risultato diverso o volete altro materiale sull'argomento, chiedete pure nei commenti e vi risponderò. Un voto con le stelle qui sopra mi aiuta a capire quali pagine migliorare.Welcome to the page on “Distributed data: replication, the CAP theorem, NoSQL and data warehouses”. I wrote it for engineering students: if a step does not add up, an exercise gives you a different result or you would like more material on the topic, just ask in the comments and I will reply. A star rating above helps me understand which pages to improve.