Dati distribuiti: replicazione, teorema CAP, NoSQL e data warehouse
Replicazione sincrona e asincrona, condizione dei quorum dimostrata, teorema CAP dimostrato, consistenza finale e NoSQL, data warehouse, schema a stella e OLAP, protezione dei dati personali.
I grandi sistemi informativi non stanno su un solo server: i dati sono copiati su più macchine per non fermarsi in caso di guasto, distribuiti su molti nodi per gestire volumi enormi, e riorganizzati in archivi separati per le analisi. In questa lezione vediamo la replicazione e la condizione dei quorum con la sua dimostrazione, il teorema CAP con la dimostrazione, la consistenza finale e le basi di dati NoSQL, i data warehouse con lo schema a stella e l’analisi OLAP, e la protezione dei dati personali.
La replicazione
Tenere più copie degli stessi dati su server diversi aumenta la disponibilità (lezione sulle architetture) e permette di distribuire le letture. Il problema è tenerle allineate. Nella replicazione sincrona una scrittura è confermata solo quando tutte le copie l’hanno ricevuta: le copie sono sempre uguali, ma ogni scrittura aspetta il nodo più lento e si blocca se uno non risponde. In quella asincrona la scrittura è confermata subito e propagata dopo: veloce, ma per qualche istante una copia può restituire dati vecchi, e se il nodo principale si guasta prima di propagare si perdono le ultime scritture.
I quorum
Una soluzione intermedia: con  copie, una scrittura è confermata quando l’hanno ricevuta
 copie, e una lettura interroga
 copie e prende il valore più recente (ogni valore porta un numero di versione).
Teorema. Se  , ogni lettura vede l’ultima scrittura confermata.
Dimostrazione. L’ultima scrittura confermata è su un insieme di almeno copie; la lettura interroga un insieme di copie. Se i due insiemi fossero disgiunti, insieme conterrebbero copie distinte, più di quante ne esistono: impossibile. Quindi almeno una copia interrogata ha l’ultima versione, e la lettura, prendendo la versione più recente, la restituisce. ∎
Con  , la scelta tipica
 tollera il guasto di una copia sia in lettura sia in scrittura;
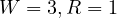 rende veloci le letture e lente le scritture.
Il teorema CAP
In un sistema distribuito si vorrebbero tre proprietà:
- consistenza (C): ogni lettura restituisce l’ultima scrittura, come se ci fosse una sola copia;
- disponibilità (A): ogni richiesta a un nodo funzionante riceve una risposta;
- tolleranza alle partizioni (P): il sistema continua a funzionare anche se la rete si divide in parti che non comunicano.
Teorema (CAP, Brewer, dimostrato da Gilbert e Lynch). Durante una partizione della rete un sistema non può essere insieme consistente e disponibile.
Dimostrazione. Si considerino due nodi con una copia ciascuno del dato  , inizialmente 0, separati da una partizione: nessun messaggio passa tra loro. Un client scrive
 sul primo nodo; se il sistema è disponibile, la scrittura riceve risposta. Poi un altro client legge dal secondo nodo; se il sistema è disponibile, anche la lettura riceve risposta. Ma il secondo nodo non ha potuto ricevere nulla dal primo, quindi risponde 0: la consistenza è violata. Per essere consistente il sistema deve rifiutare o ritardare indefinitamente la scrittura o la lettura, rinunciando alla disponibilità. ∎
Le partizioni nelle reti reali capitano, quindi la scelta vera è tra C e A quando c’è una partizione: le banche e i sistemi di prenotazione scelgono la consistenza (meglio rifiutare un’operazione che vendere due volte lo stesso posto), i social network e i carrelli degli acquisti la disponibilità.
La consistenza finale e il NoSQL
I sistemi che privilegiano la disponibilità offrono la consistenza finale (eventual consistency): se non arrivano nuove scritture, prima o poi tutte le copie convergono allo stesso valore. Su questo modello si basano molte basi di dati NoSQL, progettate per distribuire i dati su centinaia di nodi:
- chiave-valore (come in una tabella hash distribuita), per sessioni e cache;
- a documenti, che memorizzano oggetti JSON con struttura flessibile;
- a colonne, per enormi tabelle sparse;
- a grafo, per relazioni complesse come le reti sociali.
Rinunciano in parte alle giunzioni e alle transazioni tra più oggetti in cambio di scalabilità. Negli ultimi anni le basi di dati NewSQL e distribuite (con protocolli di consenso come Raft e Paxos) offrono di nuovo transazioni ACID su molti nodi, pagando la consistenza con un po’ di latenza.
Il data warehouse
I sistemi operativi sono ottimizzati per tante piccole transazioni; le analisi direzionali (“le vendite per regione e trimestre negli ultimi cinque anni”) leggono milioni di righe e rallenterebbero tutto. Si costruisce allora un data warehouse: un archivio separato, alimentato periodicamente con un processo di estrazione, trasformazione e caricamento (ETL) che ripulisce e integra i dati delle varie fonti.
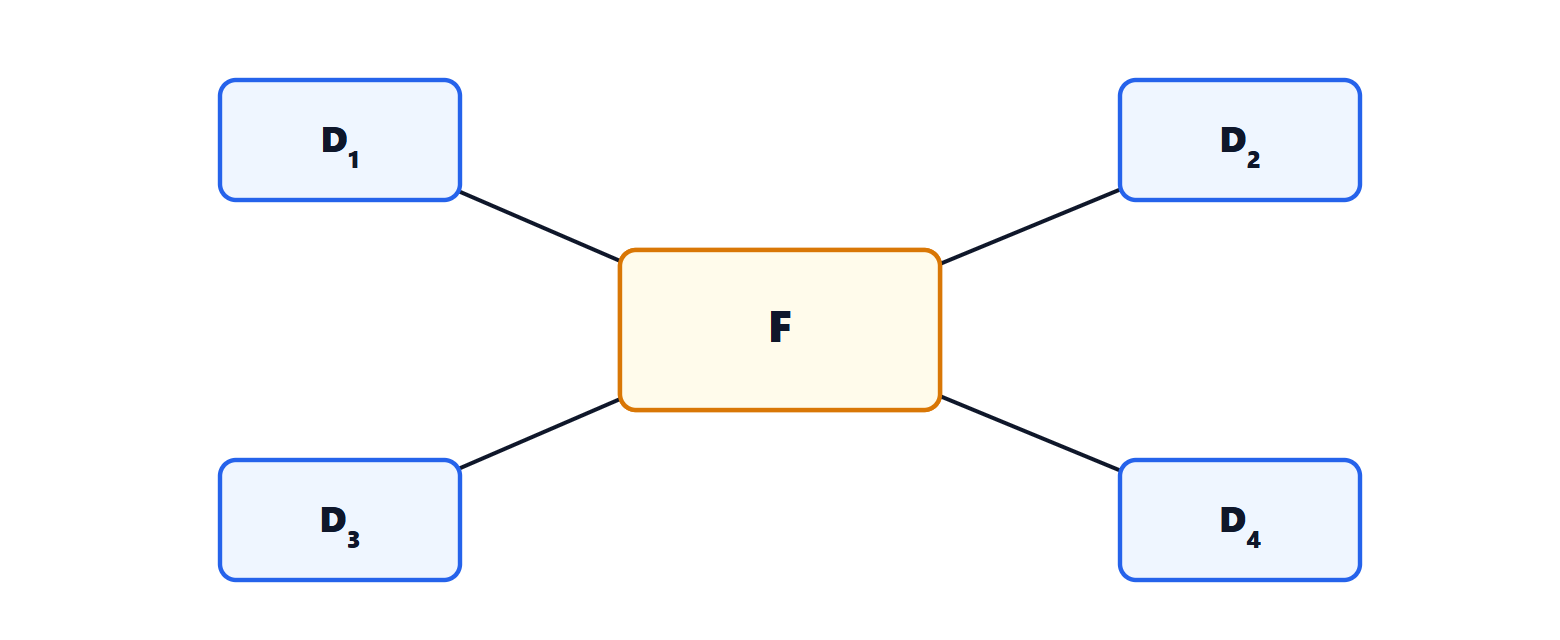
Lo schema tipico è a stella: una tabella dei fatti con le misure (importi, quantità) e le chiavi verso le tabelle delle dimensioni (tempo, prodotto, cliente, luogo), volutamente non normalizzate per richiedere poche giunzioni (lezione sulla normalizzazione). L’analisi OLAP naviga questo cubo di dati: aggregare (da mesi ad anni), scendere nel dettaglio, affettare per una regione. I sistemi moderni memorizzano i dati per colonne invece che per righe: una query che somma una sola colonna di un miliardo di righe legge solo quella, compressa. I data lake conservano invece i dati grezzi, anche non strutturati, per analisi future e per l’apprendimento automatico.
La protezione dei dati personali
Un sistema informativo che tratta dati di persone deve rispettare le norme sulla protezione dei dati, in Europa il GDPR: raccogliere solo i dati necessari a uno scopo dichiarato (minimizzazione), conservarli solo per il tempo necessario, proteggerli con misure adeguate (cifratura, controllo degli accessi, registrazione delle operazioni), permettere alle persone di consultarli, correggerli e chiederne la cancellazione, e notificare le violazioni. La protezione va progettata fin dall’inizio (privacy by design), non aggiunta alla fine: anche lo schema della base di dati, separando i dati identificativi da quelli d’uso e pseudonimizzando dove possibile, ne fa parte.