Indici: alberi B+, hash e ottimizzazione delle interrogazioni
Pagine e costo degli accessi, alberi B+ con dimostrazione dell'altezza ed esempio su un miliardo di righe, indici hash, primari, secondari e composti, costo sulle scritture, ottimizzatore ed EXPLAIN.
Una tabella con un miliardo di righe si può leggere tutta, ma ci vogliono minuti. Trovare il cliente con un certo codice in pochi millisecondi richiede un indice, come quello di un libro. In questa lezione vediamo come una base di dati organizza i dati su disco, gli alberi B+ con la dimostrazione della loro altezza e un esempio numerico, gli indici hash, gli indici composti e la regola del prefisso, il costo degli indici sulle scritture e il lavoro dell’ottimizzatore.
Pagine e accessi
Il DBMS legge e scrive i dati a pagine (blocchi) di qualche kilobyte, tipicamente 4-16 KB. Il costo di un’interrogazione si misura in pagine lette, perché un accesso a un disco è migliaia di volte più lento di un’operazione in memoria: circa 10 ms su un disco magnetico, 0,1 ms su un SSD. Un buffer in memoria tiene le pagine usate più spesso. Senza indici, cercare un valore richiede la scansione di tutta la tabella: per un miliardo di righe da 100 byte, 100 GB.
Gli alberi B+
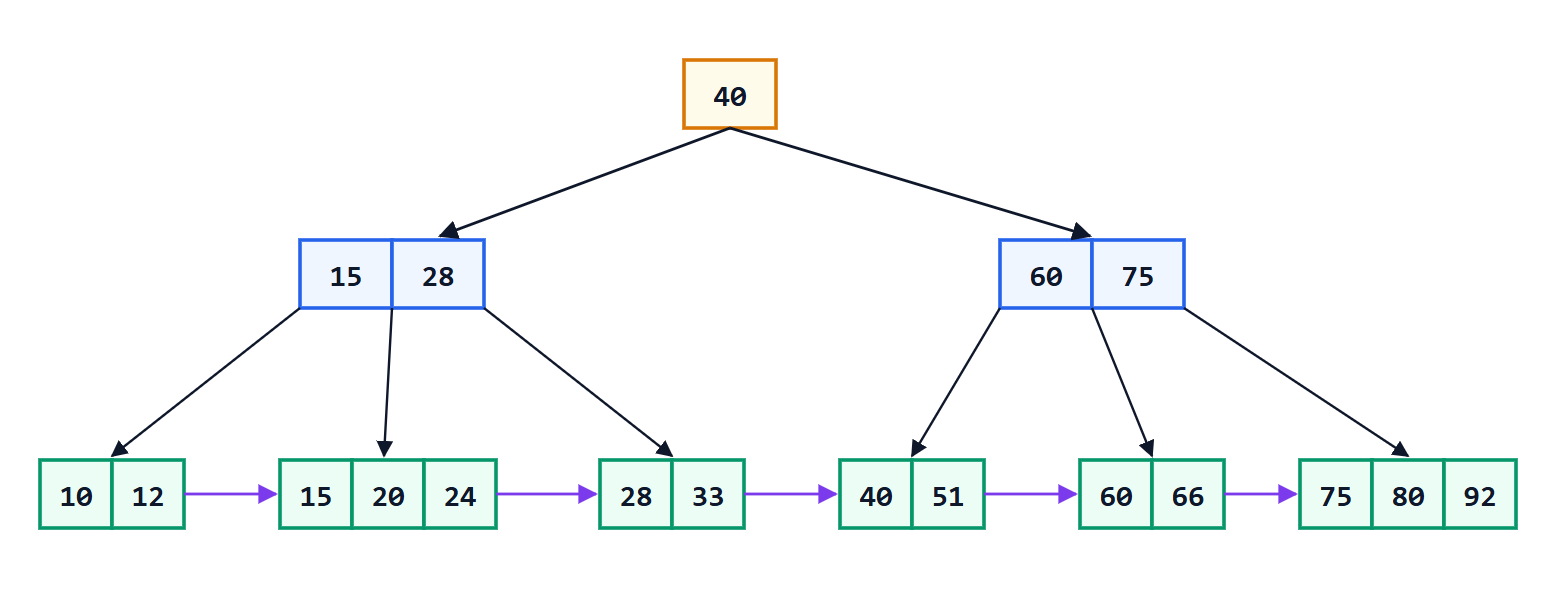
L’indice più usato è l’albero B+: un albero bilanciato in cui ogni nodo occupa una pagina e contiene molte chiavi ordinate con i puntatori ai figli. Le foglie contengono le chiavi con i riferimenti alle righe (o le righe stesse) e sono collegate in una lista ordinata. Ogni nodo, tranne la radice, è pieno almeno per metà, e tutte le foglie sono alla stessa profondità.
Teorema. Un albero B+ con  chiavi nelle foglie, in cui ogni nodo interno ha al massimo
 figli e almeno
 (la radice almeno 2), ha altezza
 che soddisfa
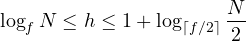
Dimostrazione. *Limite inferiore.* Ogni livello moltiplica il numero di nodi al più per , quindi un albero di altezza ha al più  posizioni nelle foglie: perché contenga chiavi serve
 , cioè
 . *Limite superiore.* La radice ha almeno 2 figli e ogni altro nodo interno almeno : al livello delle foglie ci sono almeno
 nodi, quindi (considerando le foglie piene almeno per metà) almeno altrettante porzioni di chiavi. Da
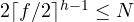 segue
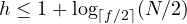 . ∎
Il punto è il fattore di diramazione : con pagine da 8 KB e chiavi con puntatori da 40 byte, è circa 200. Esempio. Con  chiavi,
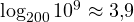 : bastano 4 livelli, e anche nel caso peggiore, con nodi pieni a metà, ne servono 5. I primi due o tre livelli, poche migliaia di pagine, stanno sempre nel buffer: trovare una riga tra un miliardo costa una o due letture dal disco. Inserimenti e cancellazioni mantengono l’albero bilanciato dividendo i nodi pieni e unendo quelli troppo vuoti, con costo anch’esso logaritmico.
Le foglie collegate rendono efficienti anche le ricerche per intervallo (“i voti tra 25 e 28”, “gli ordini di marzo”) e gli ordinamenti: si trova il primo valore e si scorre la lista.
Gli indici hash
Un indice hash calcola da ogni chiave, con una funzione di hash, il numero del contenitore in cui cercarla: in media un solo accesso, indipendentemente dalla dimensione della tabella. Ma funziona solo per le ricerche di uguaglianza: le chiavi sono sparse a caso tra i contenitori, e non serve per intervalli e ordinamenti. Per questo i DBMS usano quasi sempre gli alberi B+, e gli indici hash in casi particolari, come le giunzioni in memoria.
Indici primari, secondari e composti
Un indice primario (o clustered) determina l’ordine fisico delle righe nella tabella: le righe con chiavi vicine stanno nelle stesse pagine, e un intervallo si legge con poche pagine consecutive. Può essercene uno solo. Gli indici secondari contengono riferimenti a righe sparse: leggere molte righe attraverso un indice secondario può costare più della scansione, una pagina diversa per ogni riga.
Un indice composto su più colonne, per esempio (cognome, nome), è ordinato prima per cognome e, a parità, per nome. Serve alle ricerche per cognome, o per cognome e nome, ma non a quelle per solo nome, che è sparso in tutto l’indice: è la regola del prefisso più a sinistra.
Il prezzo degli indici
Ogni indice accelera le letture ma rallenta le scritture: ogni inserimento, modifica o cancellazione deve aggiornare tutti gli indici della tabella, e ogni indice occupa spazio. Si indicizzano quindi le colonne usate davvero nelle condizioni di ricerca e nelle giunzioni, in particolare le chiavi esterne, e non tutte le colonne “per sicurezza”.
L’ottimizzatore
Per ogni query il DBMS valuta molti piani di esecuzione equivalenti (quale indice usare, in che ordine unire le tabelle, con quale algoritmo di giunzione) e sceglie quello di costo stimato minore, usando le statistiche sui dati: numero di righe, valori distinti, distribuzione. Un indice conviene quando la condizione è selettiva, cioè seleziona una piccola parte delle righe, tipicamente meno del 5-10 %; altrimenti la scansione sequenziale è più rapida. Il comando EXPLAIN mostra il piano scelto, ed è il primo strumento quando una query è lenta: spesso si scopre una scansione completa dove ci si aspettava un indice, per una colonna non indicizzata o per una condizione scritta in modo che l’indice non si possa usare, come una funzione applicata alla colonna.