Sostituzione delle pagine: LRU, anomalia di Belady e thrashing
Costo degli errori di pagina con esempio, FIFO, ottimo e LRU, anomalia di Belady, proprietà di pila di LRU dimostrata, algoritmo dell'orologio, insieme di lavoro e thrashing.
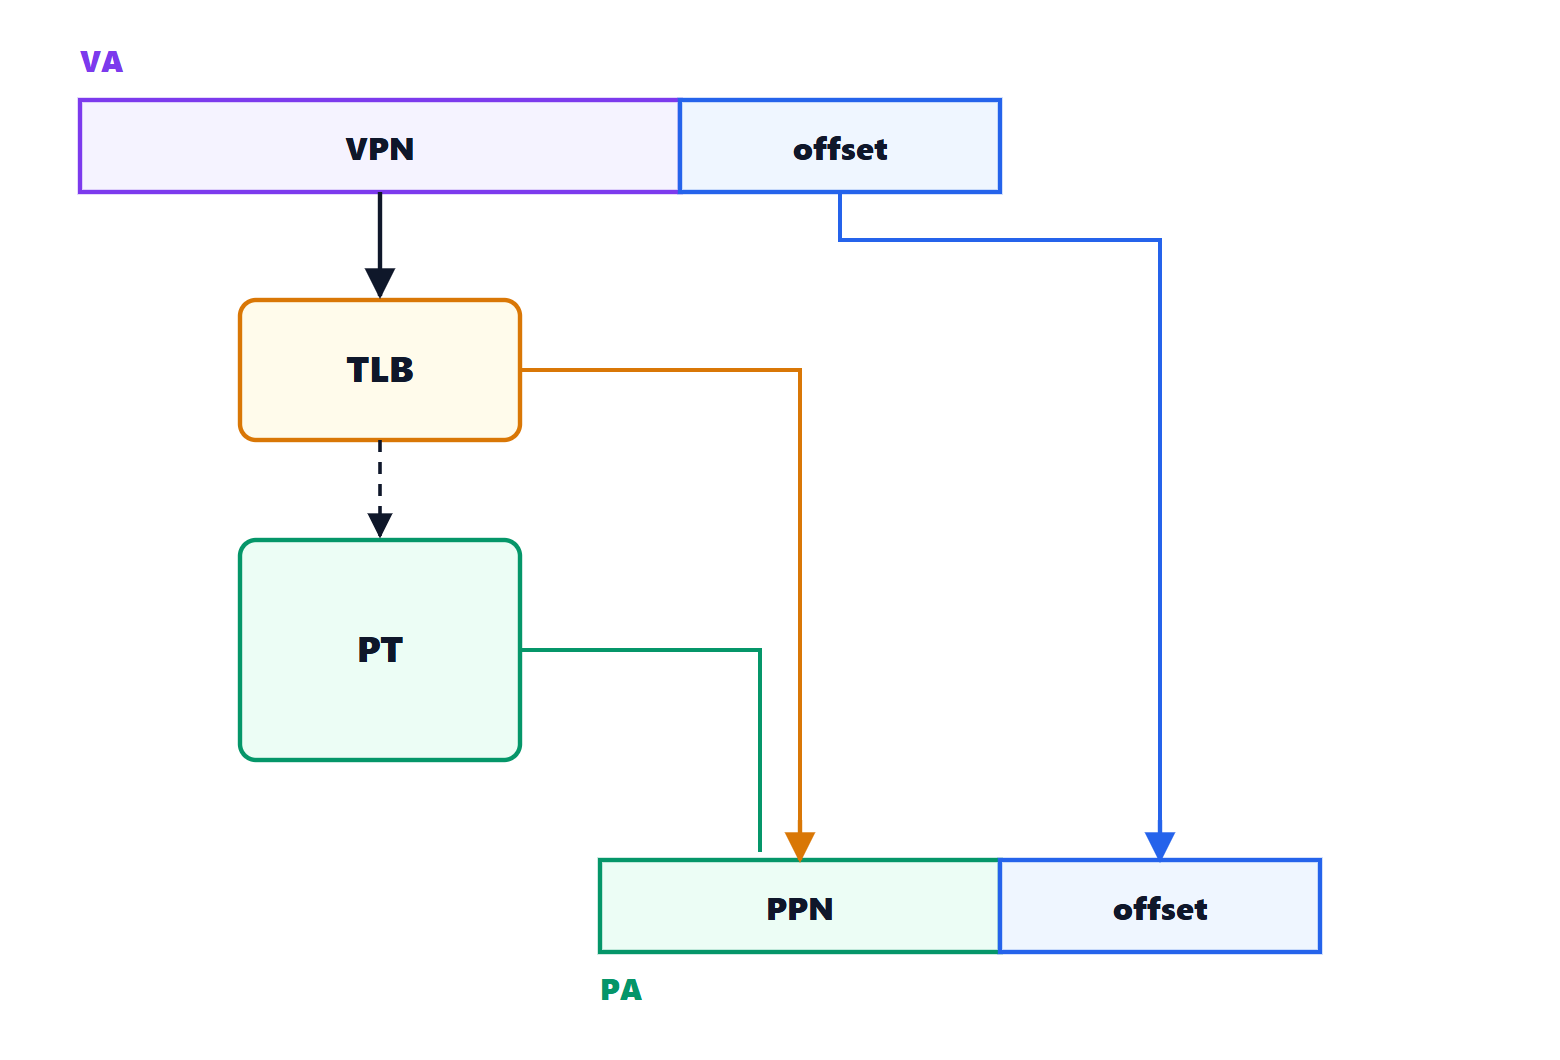
La memoria virtuale (lezione sulla memoria virtuale di Sistemi di elaborazione) dà a ogni processo uno spazio di indirizzamento privato, diviso in pagine che il sistema operativo carica in memoria solo quando servono. Quando la memoria fisica è piena e serve una pagina nuova, bisogna scegliere quale togliere: è il problema della sostituzione delle pagine, e la scelta pesa enormemente, perché un errore di pagina costa milioni di volte un accesso normale. In questa lezione vediamo il costo degli errori di pagina con un esempio, gli algoritmi FIFO, ottimo e LRU, l’anomalia di Belady con la dimostrazione che LRU non ne soffre, l’algoritmo dell’orologio, l’insieme di lavoro e il thrashing.
Il costo di un errore di pagina
Se la pagina richiesta non è in memoria, il processore genera un errore di pagina (page fault): il sistema operativo trova un frame libero (o ne libera uno), legge la pagina dal disco, aggiorna la tabella delle pagine e fa ripetere l’istruzione. Con probabilità di errore  , tempo di accesso alla memoria
 e tempo di servizio dell’errore
 , il tempo di accesso effettivo è
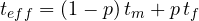
Esempio. Con  ns e
 ms (un disco magnetico), per non rallentare di più del 10 % serve
 ns, cioè
 ns circa,
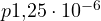 : meno di un errore ogni 800 000 accessi. Con un SSD (
 µs) il limite si allenta di ottanta volte, ma resta severo.
Gli algoritmi di sostituzione
- FIFO: si toglie la pagina caricata da più tempo. Semplice, ma toglie anche pagine usatissime, come quelle del codice principale.
- Ottimo (OPT, Belady): si toglie la pagina che verrà usata più tardi nel futuro. È il migliore possibile, ma richiede di conoscere il futuro; serve come termine di paragone nelle simulazioni.
- LRU (least recently used): si toglie la pagina non usata da più tempo. Usa il passato recente come previsione del futuro prossimo, sfruttando la località (lezione sulla memoria cache).
L’anomalia di Belady
Ci si aspetterebbe che con più frame gli errori diminuiscano sempre. Con FIFO non è così.
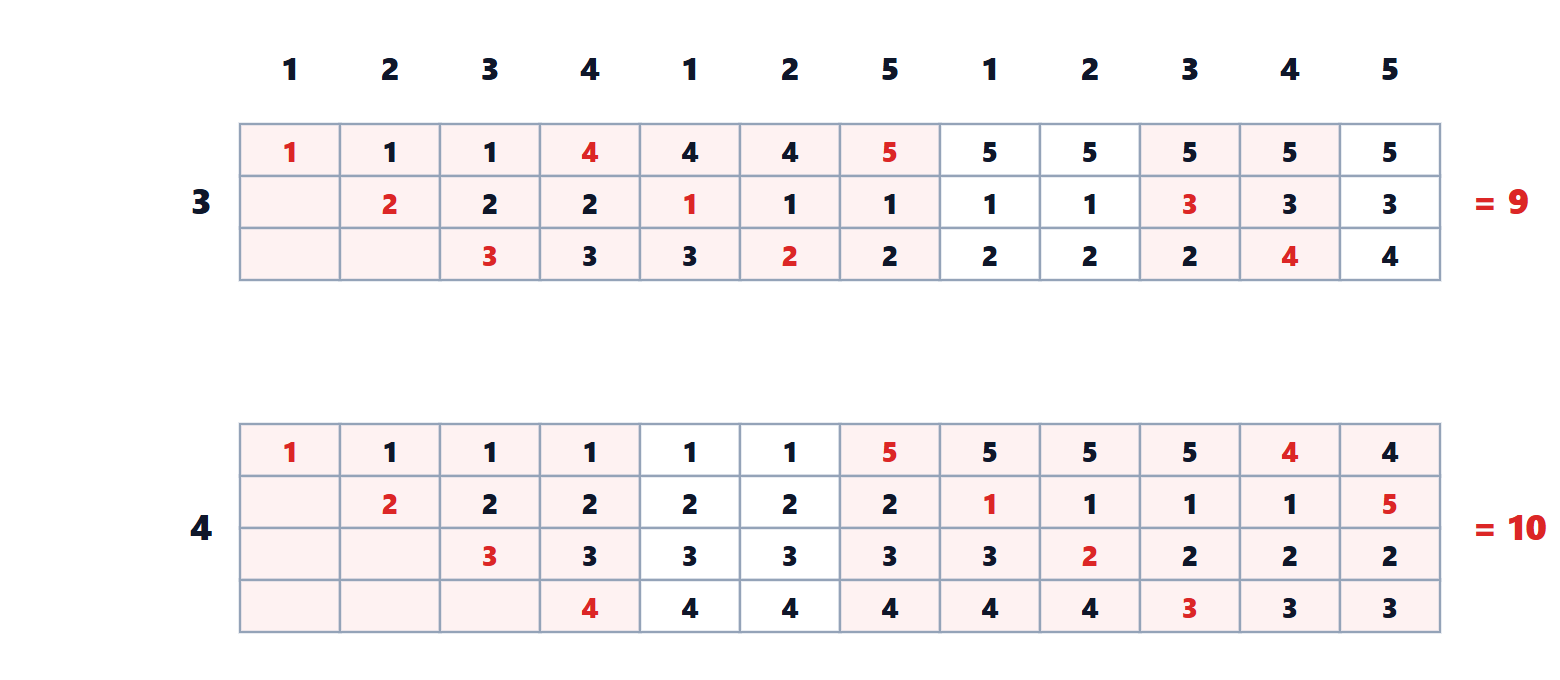
Con la sequenza 1, 2, 3, 4, 1, 2, 5, 1, 2, 3, 4, 5 FIFO fa 9 errori con 3 frame e 10 con 4: aggiungere memoria peggiora le cose. LRU e OPT non hanno questa anomalia, per una proprietà strutturale.
Teorema. Con LRU, in ogni istante, l’insieme delle pagine in memoria con  frame è contenuto nell’insieme delle pagine in memoria con
 frame. Di conseguenza il numero di errori con frame non supera quello con frame.
Dimostrazione. Con LRU, dopo il riscaldamento iniziale, la memoria con frame contiene esattamente le pagine distinte usate più di recente; prima, contiene tutte quelle usate finora. In entrambi i casi è l’insieme delle “prime ” pagine in ordine di uso recente, e le prime sono contenute nelle prime . Ogni riferimento che è un successo con frame (pagina presente) lo è anche con , quindi gli errori con frame sono al più quelli con . ∎
Gli algoritmi con questa proprietà si chiamano algoritmi a pila (stack algorithms). FIFO non lo è: l’insieme in memoria dipende dall’ordine di caricamento, non solo dall’uso recente.
L’algoritmo dell’orologio
LRU esatto richiederebbe di registrare l’istante di ogni accesso alla memoria, troppo costoso. L’hardware offre un bit di riferimento per pagina, che il processore mette a 1 a ogni accesso. L’algoritmo dell’orologio (seconda possibilità) dispone i frame in cerchio con una lancetta: quando serve un frame, guarda la pagina indicata; se il bit vale 1 lo azzera e passa oltre (le dà una seconda possibilità), se vale 0 la sceglie. Le pagine usate di recente sopravvivono a un giro della lancetta. È un’approssimazione di LRU usata, con varianti, nei sistemi reali. Si preferisce inoltre togliere pagine pulite (non modificate), che non vanno riscritte sul disco.
L’insieme di lavoro e il thrashing
L’insieme di lavoro (working set) di un processo è l’insieme delle pagine usate nell’ultima finestra di  riferimenti: rappresenta la sua località attuale. Se la somma degli insiemi di lavoro di tutti i processi supera la memoria fisica, ogni processo toglie pagine che servono agli altri, gli errori si moltiplicano e la CPU passa il tempo ad aspettare il disco. È il thrashing: aggiungere processi fa crollare il throughput invece di aumentarlo. La cura è ridurre il numero di processi attivi (sospenderne alcuni) finché gli insiemi di lavoro non stanno in memoria, oppure aggiungere memoria.
Altri usi della memoria virtuale
- Copia su scrittura dopo una fork (lezione sui processi).
- File mappati in memoria: un file diventa una zona dello spazio di indirizzamento, e leggerlo è accedere alla memoria; il sistema carica le pagine a richiesta.
- Librerie condivise: il codice di una libreria usata da cento processi sta in memoria una volta sola, mappata in tutti.
- Pagine grandi (2 MB o 1 GB invece di 4 KB) per i programmi che usano molta memoria, che riducono gli errori del TLB.