Remplacement de pages : LRU, anomalie de Belady et écroulement
Coût des défauts de page avec un exemple, FIFO, optimal et LRU, l'anomalie de Belady, la propriété de pile de LRU démontrée, l'algorithme de l'horloge, ensemble de travail et écroulement (thrashing).
https://www.electronics-engineering.com/fr/remplacement-de-pages-lru-anomalie-de-belady-ecroulement/
La mémoire virtuelle (leçon de Systèmes d’élaboration sur la mémoire virtuelle) donne à chaque processus un espace d’adressage privé, divisé en pages que le système d’exploitation ne charge en mémoire qu’en cas de besoin. Quand la mémoire physique est pleine et qu’il faut une nouvelle page, il faut en choisir une à retirer : c’est le problème du remplacement de pages, et le choix compte énormément, parce qu’un défaut de page coûte des millions de fois un accès normal. Dans cette leçon, nous regardons le coût des défauts de page avec un exemple, les algorithmes FIFO, optimal et LRU, l’anomalie de Belady avec la démonstration que LRU n’en souffre pas, l’algorithme de l’horloge, l’ensemble de travail et l’écroulement (thrashing).
Le coût d’un défaut de page
Si la page demandée n’est pas en mémoire, le processeur lève un défaut de page : le système d’exploitation trouve un cadre libre (ou en libère un), lit la page sur le disque, met à jour la table des pages et fait répéter l’instruction. Avec une probabilité de défaut  , un temps d’accès mémoire
 et un temps de service du défaut
 , le temps d’accès effectif est
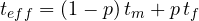
Exemple. Avec  ns et
 ms (un disque magnétique), pour ne pas ralentir de plus de 10 %, il faut
 ns, c’est-à-dire
 ns à peu près,
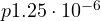 : moins d’un défaut tous les 800 000 accès. Avec un SSD (
 µs), la limite se relâche d’un facteur quatre-vingts, mais reste stricte.
Les algorithmes de remplacement
- FIFO : retirer la page chargée depuis le plus longtemps. Simple, mais il retire aussi des pages très utilisées, comme celles du code principal.
- Optimal (OPT, Belady) : retirer la page qui sera utilisée le plus loin dans le futur. C’est le meilleur possible, mais il exige de connaître l’avenir ; il sert de référence dans les simulations.
- LRU (least recently used) : retirer la page inutilisée depuis le plus longtemps. Il utilise le passé récent comme prédiction du futur proche, en exploitant la localité (leçon sur la mémoire cache).
L’anomalie de Belady
On s’attendrait à ce que les défauts diminuent toujours avec plus de cadres. Avec FIFO, ce n’est pas le cas.
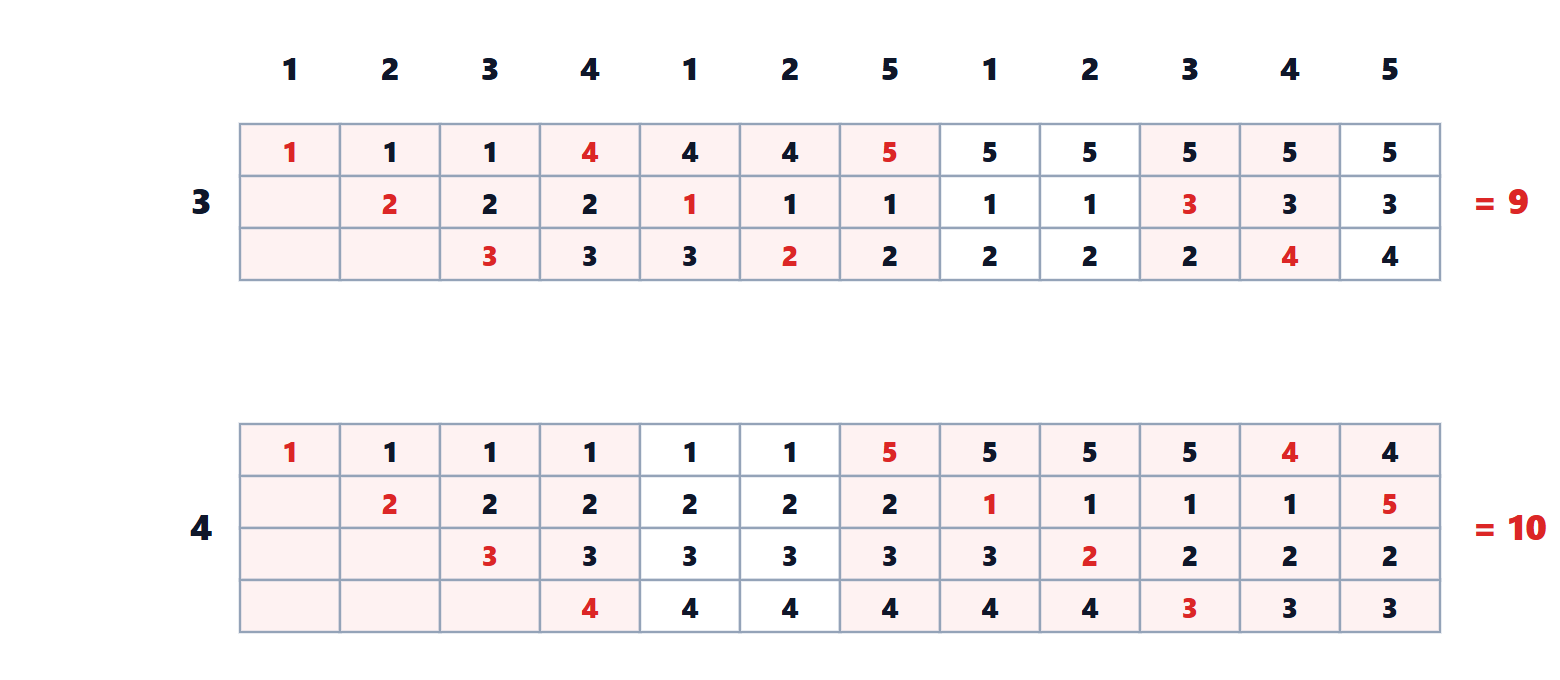
Avec la chaîne 1, 2, 3, 4, 1, 2, 5, 1, 2, 3, 4, 5, FIFO fait 9 défauts avec 3 cadres et 10 avec 4 : ajouter de la mémoire aggrave les choses. LRU et OPT n’ont pas cette anomalie, à cause d’une propriété structurelle.
Théorème. Avec LRU, à chaque instant, l’ensemble des pages en mémoire avec  cadres est contenu dans l’ensemble des pages en mémoire avec
 cadres. Par conséquent, le nombre de défauts avec cadres ne dépasse pas celui avec cadres.
Démonstration. Avec LRU, après la mise en route initiale, la mémoire à cadres contient exactement les pages distinctes les plus récemment utilisées ; avant, elle contient toutes celles utilisées jusque-là. Dans les deux cas, c’est l’ensemble des « premières » pages par ordre d’usage récent, et les premières sont contenues dans les premières. Toute référence qui est un succès avec cadres (page présente) est aussi un succès avec , donc les défauts avec cadres sont au plus ceux avec . ∎
Les algorithmes qui ont cette propriété s’appellent des algorithmes à pile (stack algorithms). FIFO n’en est pas un : l’ensemble en mémoire dépend de l’ordre de chargement, non seulement de l’usage récent.
L’algorithme de l’horloge
Un LRU exact exigerait d’enregistrer l’instant de chaque accès mémoire, ce qui est trop coûteux. Le matériel offre un bit de référence par page, que le processeur met à 1 à chaque accès. L’algorithme de l’horloge (seconde chance) dispose les cadres en cercle avec une aiguille : quand il faut un cadre, il regarde la page que l’aiguille désigne ; si le bit vaut 1, il le remet à zéro et avance (en lui donnant une seconde chance), s’il vaut 0, il la choisit. Les pages récemment utilisées survivent à un passage de l’aiguille. C’est une approximation de LRU utilisée, avec des variantes, dans les systèmes réels. On préfère aussi retirer les pages propres (non modifiées), puisqu’il n’est pas nécessaire de les récrire sur le disque.
Ensemble de travail et écroulement
L’ensemble de travail (working set) d’un processus est l’ensemble des pages utilisées dans la dernière fenêtre de  références : il représente sa localité courante. Si la somme des ensembles de travail de tous les processus dépasse la mémoire physique, chaque processus retire des pages dont les autres ont besoin, les défauts se multiplient et le processeur passe son temps à attendre le disque. C’est l’écroulement (thrashing) : ajouter des processus fait s’effondrer le débit au lieu de l’augmenter. Le remède est de réduire le nombre de processus actifs (en en suspendant) jusqu’à ce que les ensembles de travail tiennent en mémoire, ou d’ajouter de la mémoire.
Autres usages de la mémoire virtuelle
- La copie sur écriture (copy-on-write) après un fork (leçon sur les processus).
- Les fichiers projetés en mémoire : un fichier devient une zone de l’espace d’adressage, et le lire veut dire accéder à la mémoire ; le système charge les pages à la demande.
- Les bibliothèques partagées : le code d’une bibliothèque utilisée par cent processus n’est en mémoire qu’une fois, projeté dans tous.
- Les pages géantes (2 Mo ou 1 Go au lieu de 4 Ko) pour les programmes qui utilisent beaucoup de mémoire, qui réduisent les défauts de TLB.



Sono l'autore di questa pagina su «Sostituzione delle pagine: LRU, anomalia di Belady e thrashing». Se qualcosa non è chiaro, se vi serve un esempio in più o volete approfondire un punto, scrivetelo qui sotto nei commenti: rispondo personalmente. Se la pagina vi è stata utile, lasciate un voto con le stelle in cima all'articolo.I am the author of this page on “Page replacement: LRU, Belady's anomaly and thrashing”. If something is unclear, if you need another example or want to go deeper into a point, write it in the comments below: I answer personally. If the page was useful, leave a star rating at the top of the article.