Systèmes temps réel : EDF, priorités monotones en fréquence et temps de réponse
Tâches périodiques, condition d'utilisation démontrée, EDF optimal, la borne de Liu et Layland, analyse du temps de réponse avec un exemple, inversion de priorité et héritage, RTOS.
https://www.electronics-engineering.com/fr/systemes-temps-reel-edf-rate-monotonic-temps-de-reponse/
Dans un système temps réel, un résultat correct mais tardif est faux : la commande de freinage d’une voiture, un régulateur de moteur, un stimulateur cardiaque doivent répondre dans un délai fixé. Ce qui compte n’est pas la vitesse moyenne, mais la garantie dans le pire cas. Dans cette leçon, nous regardons le modèle de tâches périodiques, l’ordonnancement EDF avec la démonstration de la condition nécessaire, la priorité monotone en fréquence (rate monotonic) avec sa borne et l’analyse exacte du temps de réponse sur un exemple, l’inversion de priorité et les systèmes d’exploitation temps réel.
Le modèle de tâches périodiques
On distingue les systèmes durs (hard), où manquer une échéance est une défaillance (commandes de vol, airbags), et les mous (soft), où seule la qualité se dégrade (lecture vidéo). De nombreuses tâches de commande sont périodiques (leçon de Commande numérique sur l’implémentation) : la tâche  est lancée toutes les
 , demande au plus
 de calcul (le temps d’exécution au pire cas) et doit finir avant le lancement suivant. Son facteur d’utilisation est
 , et l’utilisation totale
 .
L’échéance la plus proche d’abord
L’algorithme EDF (earliest deadline first) exécute à chaque instant la tâche prête dont l’échéance est la plus proche, avec préemption.
Théorème. Sur un processeur, un ensemble de tâches périodiques dont l’échéance égale la période est ordonnançable par un algorithme quelconque seulement si  ; avec EDF, la condition est aussi suffisante.
Démonstration de la nécessité. Considérons l’intervalle  , où
 est le plus petit commun multiple des périodes. La tâche est lancée
 fois et demande en tout
 de calcul, qui doit être fait dans . La demande totale est
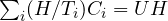 , et le processeur offre au plus : il faut
 , c’est-à-dire . ∎
La suffisance pour EDF (Liu et Layland, 1973) se démontre en montrant que, si une échéance était manquée, dans l’intervalle précédent le processeur aurait toujours été occupé par des tâches d’échéances non plus tardives, et leur demande dépasserait la longueur de l’intervalle, c’est-à-dire  . EDF est donc optimal : il utilise le processeur jusqu’à 100 %.
Priorité monotone en fréquence et temps de réponse
De nombreux systèmes utilisent plutôt des priorités fixes, plus simples et plus prévisibles en surcharge : avec la règle rate monotonic (RMS), la tâche de plus courte période a la plus haute priorité. Liu et Layland ont démontré que RMS garantit les échéances si
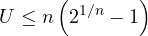
où  est le nombre de tâches : 0,83 pour deux, 0,78 pour trois, tendant vers
 . La condition n’est que suffisante ; pour une réponse exacte, on calcule le temps de réponse au pire cas, qui se produit quand toutes les tâches sont lancées ensemble. Pour la tâche
 , avec des tâches
 de plus haute priorité :
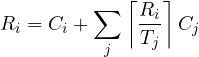
parce que pendant  , chaque tâche de plus haute priorité est lancée
 fois et l’interrompt chaque fois pendant
 . L’équation se résout par itération à partir de
 , jusqu’à ce que la valeur cesse de changer ; la tâche respecte son échéance si
 .
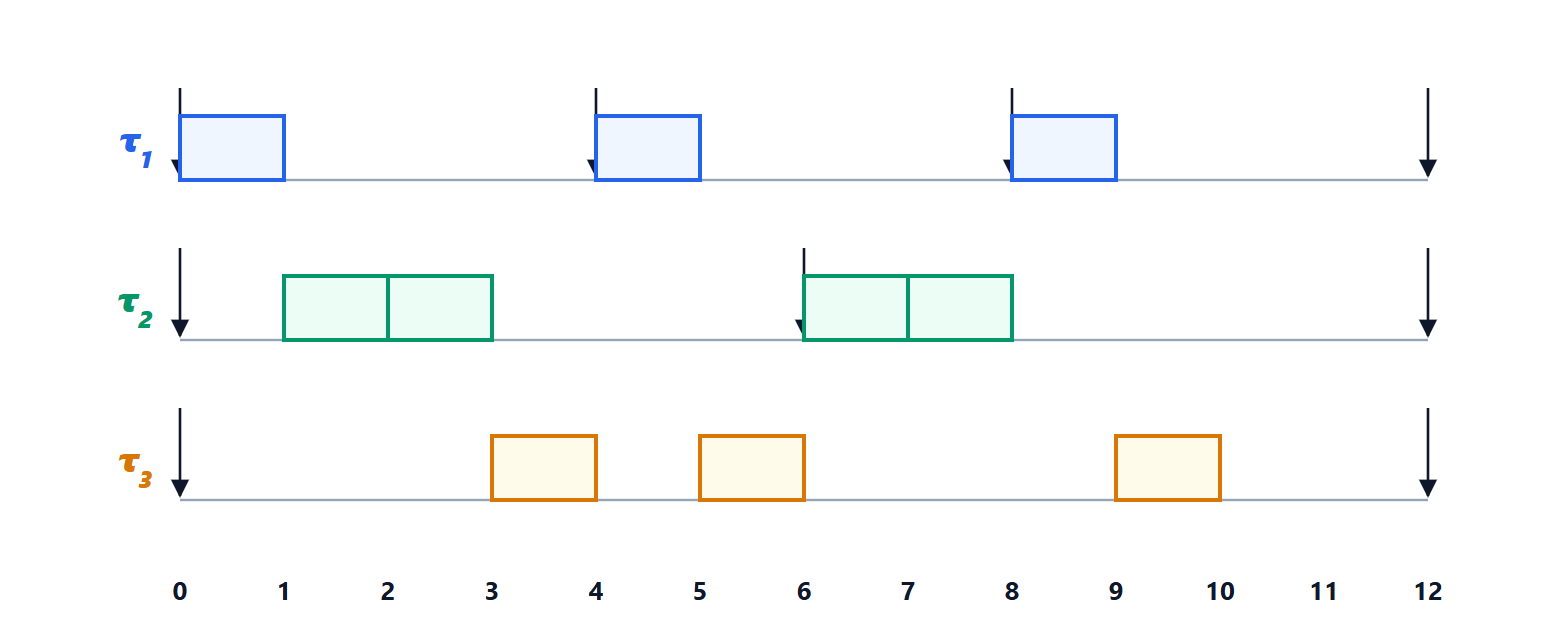
Exemple. Trois tâches  :
 ,
 ,
 , avec
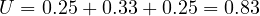 , au-dessus de la borne de 0,78 : le test suffisant est non concluant. Temps de réponse de
 : on part de
 ; puis
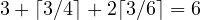 ; puis
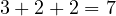 ; puis
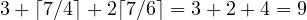 ; puis
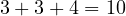 ; puis
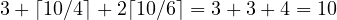 , stable.
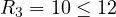 : l’ensemble est ordonnançable, comme le montre la figure.
L’inversion de priorité
Une tâche H de haute priorité attend un verrou détenu par une tâche L de basse priorité. Si entre-temps une tâche M de priorité moyenne est lancée, qui n’utilise pas le verrou, M préempte L, et H reste bloquée pendant toute la durée de M : une tâche moins importante retarde indirectement la plus importante, pendant un temps non borné s’il y a beaucoup de tâches moyennes. C’est l’inversion de priorité. En 1997, la sonde Mars Pathfinder se réinitialisait sans cesse pour cette raison, jusqu’à ce qu’on active depuis la Terre l’option d’héritage de priorité : tant que L détient un verrou demandé par H, L hérite temporairement de la priorité de H, M ne peut pas la préempter, et le blocage de H dure au plus autant que la section critique de L. Le protocole du plafond de priorité fait plus, et empêche aussi les interblocages entre verrous.
Les systèmes d’exploitation temps réel
Un système d’exploitation temps réel (RTOS) offre des ordonnanceurs préemptifs à priorités, des latences d’interruption petites et surtout bornées, des outils de synchronisation avec héritage de priorité et une allocation de mémoire prévisible. Sur les microcontrôleurs, on utilise de très petits noyaux comme FreeRTOS ou Zephyr, de quelques kilo-octets ; dans les systèmes plus grands, Linux avec les extensions PREEMPT_RT, qui rendent presque tout le noyau préemptible et ramènent les latences au pire cas à des dizaines de microsecondes. Le temps d’exécution au pire cas doit être mesuré ou calculé avec des outils d’analyse, en tenant compte des caches et des interruptions : c’est souvent la partie la plus difficile de la conception.



Benvenuti nella pagina su «Sistemi in tempo reale: EDF, priorità monotona e tempo di risposta». L'ho scritta pensando a chi studia ingegneria elettronica: se un passaggio non vi torna, un esercizio vi dà un risultato diverso o volete altro materiale sull'argomento, chiedete pure nei commenti e vi risponderò. Un voto con le stelle qui sopra mi aiuta a capire quali pagine migliorare.Welcome to the page on “Real-time systems: EDF, rate monotonic and response time”. I wrote it for engineering students: if a step does not add up, an exercise gives you a different result or you would like more material on the topic, just ask in the comments and I will reply. A star rating above helps me understand which pages to improve.