Pianificazione della CPU: FCFS, SJF, round robin e lo scheduler di Linux
Misure di prestazione, ottimalità di SJF dimostrata con lo scambio, media esponenziale delle raffiche, limite di attesa del round robin dimostrato, code multilivello, CFS.
Quando più processi sono pronti, lo scheduler decide chi usa la CPU e per quanto. Le scelte possibili privilegiano obiettivi diversi: finire tanti lavori, rispondere in fretta all’utente, essere equi, rispettare le scadenze. In questa lezione vediamo le misure di prestazione, gli algoritmi classici con la dimostrazione che “prima il più breve” minimizza l’attesa media, la stima delle durate, il round robin con il suo limite sul tempo di risposta, le priorità e lo scheduler di Linux.
Le misure
Per ogni processo si misurano:
- il tempo di completamento (turnaround): dall’arrivo alla fine;
- il tempo di attesa: il tempo passato pronto in coda, senza essere eseguito;
- il tempo di risposta: dall’arrivo alla prima esecuzione, importante per i programmi interattivi.
Per il sistema conta il throughput, il numero di lavori completati per unità di tempo, e l’utilizzo della CPU. I processi alternano raffiche di calcolo (CPU burst) e attese di ingresso e uscita: i processi interattivi hanno raffiche brevi, quelli di calcolo raffiche lunghe.
FCFS e SJF
FCFS (first come, first served) esegue i processi nell’ordine di arrivo. È semplice ma soffre dell’effetto convoglio: un lavoro lungo davanti fa aspettare tutti quelli brevi dietro. SJF (shortest job first) esegue per primo il lavoro con la raffica più breve.
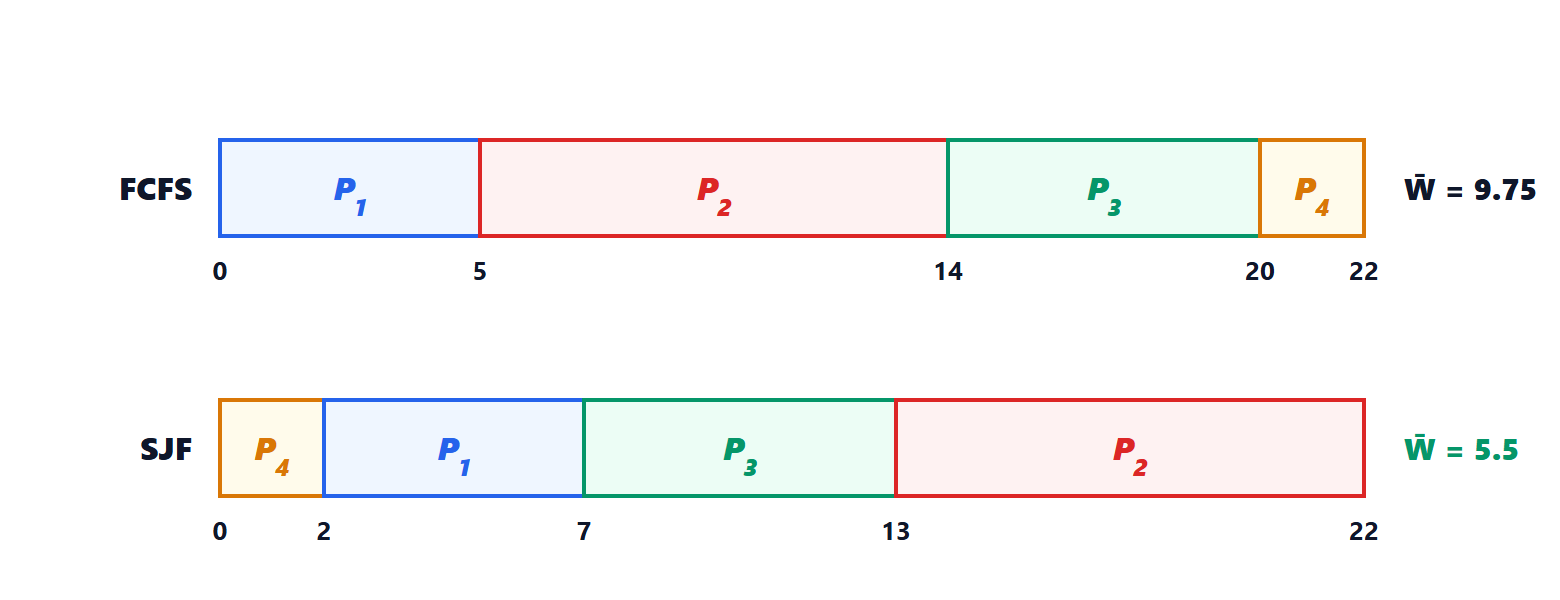
Esempio. Con FCFS le attese sono 0, 5, 14, 20, media 9,75; con SJF sono 0 (P4), 2 (P1), 7 (P3), 13 (P2), media 5,5.
Teorema. Tra tutti gli ordinamenti senza prelazione di  lavori disponibili all’istante 0, SJF minimizza il tempo di attesa medio.
Dimostrazione (scambio). Si consideri un ordinamento in cui due lavori consecutivi  e
 hanno durate
 , con prima di . Scambiandoli, l’attesa dei lavori precedenti e di quelli successivi non cambia (questi ultimi aspettano comunque
 per i due). L’attesa di diminuisce di
 e quella di aumenta di
 : la somma diminuisce di
 . Quindi ogni ordinamento con una coppia consecutiva “lunga prima di breve” si può migliorare, e l’ottimo non ne ha: è l’ordinamento per durate crescenti, cioè SJF. ∎
Lo stesso argomento di scambio dimostra molti risultati di ottimalità nella pianificazione (lezione sulla programmazione della produzione di Gestione aziendale).
Stimare il futuro
SJF richiede di conoscere la durata della prossima raffica, che non si sa. La si stima con una media esponenziale delle raffiche passate:
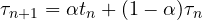
dove  è la durata misurata dell’ultima raffica e
 il peso della storia recente. È un filtro passa-basso del primo ordine (lezione sui sistemi a tempo discreto). La versione con prelazione, SRTF (shortest remaining time first), interrompe il processo in corso se ne arriva uno con raffica più breve del suo tempo residuo. Il rischio di entrambi è l’attesa indefinita (starvation) dei lavori lunghi, se continuano ad arrivare lavori brevi.
Round robin
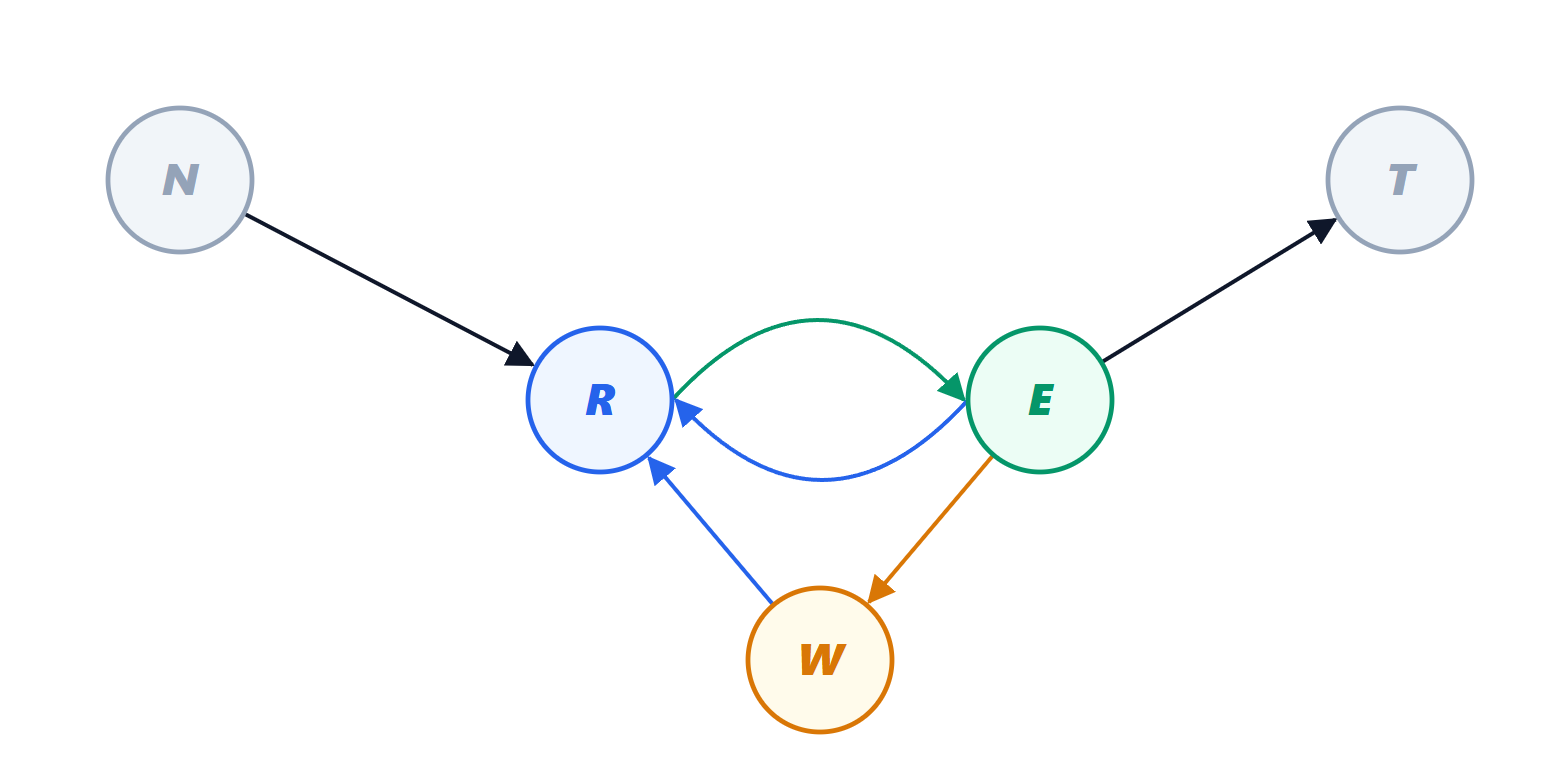
Il round robin dà a ogni processo pronto, a turno, un quanto di tempo  ; allo scadere il processo torna in fondo alla coda (è la transizione da esecuzione a pronto nel diagramma degli stati, lezione sui processi).
Teorema. Con processi pronti e quanto , nessun processo aspetta più di  prima del suo turno.
Dimostrazione. Davanti a un processo in coda ci sono al più  processi, e ciascuno usa la CPU al massimo per prima di essere rimesso in fondo. ∎
Il quanto è un compromesso. Se è grande il round robin diventa FCFS; se è piccolo la risposta è rapida, ma la commutazione di contesto, che dura  , pesa: la frazione di tempo utile è
 . Con
 µs e
 ms il costo è lo 0,1 %; con
 µs sarebbe quasi il 10 %. Di solito il quanto si sceglie più lungo della raffica tipica dei processi interattivi, che così finiscono prima che scada.
Priorità e code multiple
Gli scheduler reali assegnano priorità: i processi interattivi o di sistema prima di quelli di calcolo. Per evitare l’attesa indefinita dei processi a bassa priorità si usa l’invecchiamento (aging): la priorità cresce con il tempo passato in attesa.
La coda multilivello con retroazione (MLFQ) impara la natura dei processi senza conoscerla in anticipo: un processo nuovo entra nella coda più prioritaria con quanto breve; se consuma tutto il quanto scende di livello, se si blocca prima resta in alto. I processi interattivi restano così in alto, quelli di calcolo scendono verso code con quanti più lunghi.
Lo scheduler di Linux
Lo scheduler di Linux per i processi ordinari, CFS (completely fair scheduler, sostituito dalla versione 6.6 dall’evoluzione EEVDF con lo stesso principio), cerca di dare a ciascun processo una quota equa della CPU. Tiene per ogni processo un tempo di esecuzione virtuale, che cresce mentre il processo è in esecuzione, più lentamente per i processi più importanti; esegue sempre il processo con il tempo virtuale minimo, conservando i processi in un albero binario bilanciato. Un processo che dorme molto (interattivo) accumula poco tempo virtuale e, quando si sveglia, va subito in esecuzione. L’importanza si regola con il valore “nice”: ogni passo cambia il peso di circa il 25 %.
Sui sistemi multiprocessore lo scheduler deve anche bilanciare il carico tra i core e, al contrario, tenere un processo sullo stesso core (affinità) per sfruttare le cache già piene dei suoi dati. Per i processi in tempo reale servono regole diverse, con scadenze garantite (lezione sui sistemi in tempo reale).