Processi, chiamate di sistema e thread
Modalità utente e kernel, chiamate di sistema, stati di un processo, commutazione di contesto, fork ed exec con numero di processi dimostrato, thread, pipe e comunicazione tra processi.
Un sistema operativo fa due mestieri: offre ai programmi un’astrazione comoda della macchina (file invece di settori del disco, processi invece di registri del processore) e ne gestisce le risorse in modo che molti programmi convivano senza danneggiarsi. Il concetto centrale è il processo, un programma in esecuzione. In questa lezione vediamo la modalità protetta e le chiamate di sistema, la struttura di un processo e i suoi stati, la commutazione di contesto, la creazione dei processi in Unix con la dimostrazione di quanti ne nascono da una sequenza di fork, i thread e la comunicazione tra processi.
Modalità utente e modalità kernel
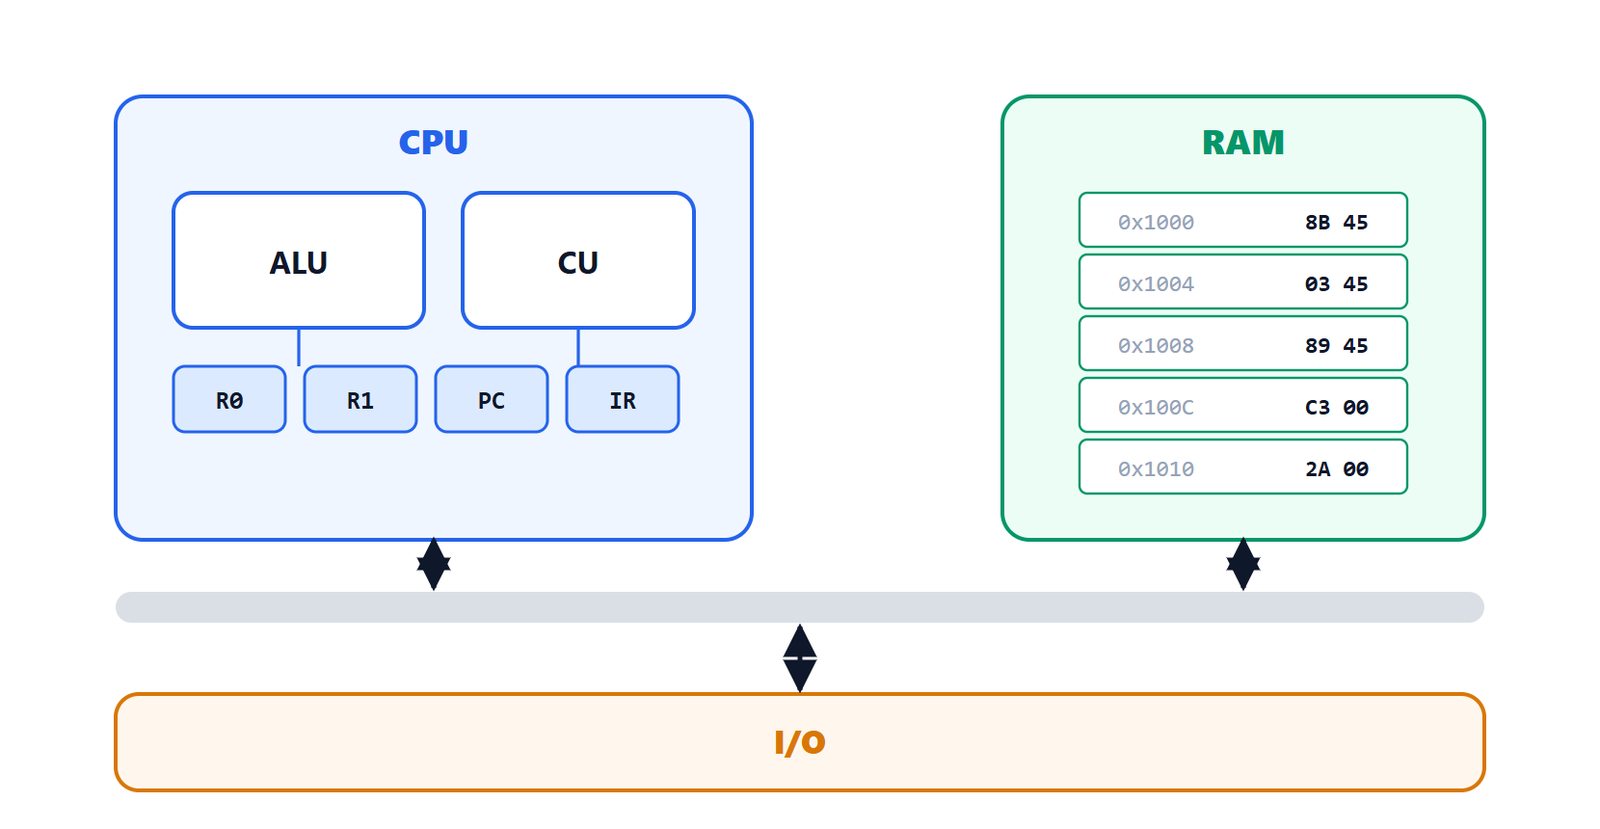
Il processore ha almeno due livelli di privilegio (lezione su ingresso e uscita di Sistemi di elaborazione). In modalità kernel si possono eseguire tutte le istruzioni, accedere a tutta la memoria e ai dispositivi; in modalità utente le istruzioni privilegiate provocano un’eccezione. I programmi girano in modalità utente; quando hanno bisogno di un servizio (leggere un file, creare un processo, allocare memoria) eseguono una chiamata di sistema: un’istruzione speciale (trap) passa il controllo al kernel in un punto stabilito, il kernel controlla i parametri, esegue il servizio e restituisce il risultato tornando in modalità utente.
Il passaggio costa da decine a centinaia di nanosecondi, molto più di una chiamata di funzione: per questo le librerie raggruppano le operazioni (per esempio la funzione printf del C accumula i caratteri in un buffer e chiama il kernel una volta sola).
Il processo
Un processo è formato da:
- uno spazio di indirizzamento privato: codice, dati globali, heap (memoria allocata dinamicamente) e stack (lezione sulla memoria dinamica di Fondamenti di informatica);
- lo stato del processore: contatore di programma, registri, puntatore allo stack;
- le risorse del sistema: file aperti, permessi, identificatore (PID), processo padre.
Il kernel tiene tutto questo in un descrittore di processo (PCB, process control block). Durante la vita un processo passa per diversi stati.
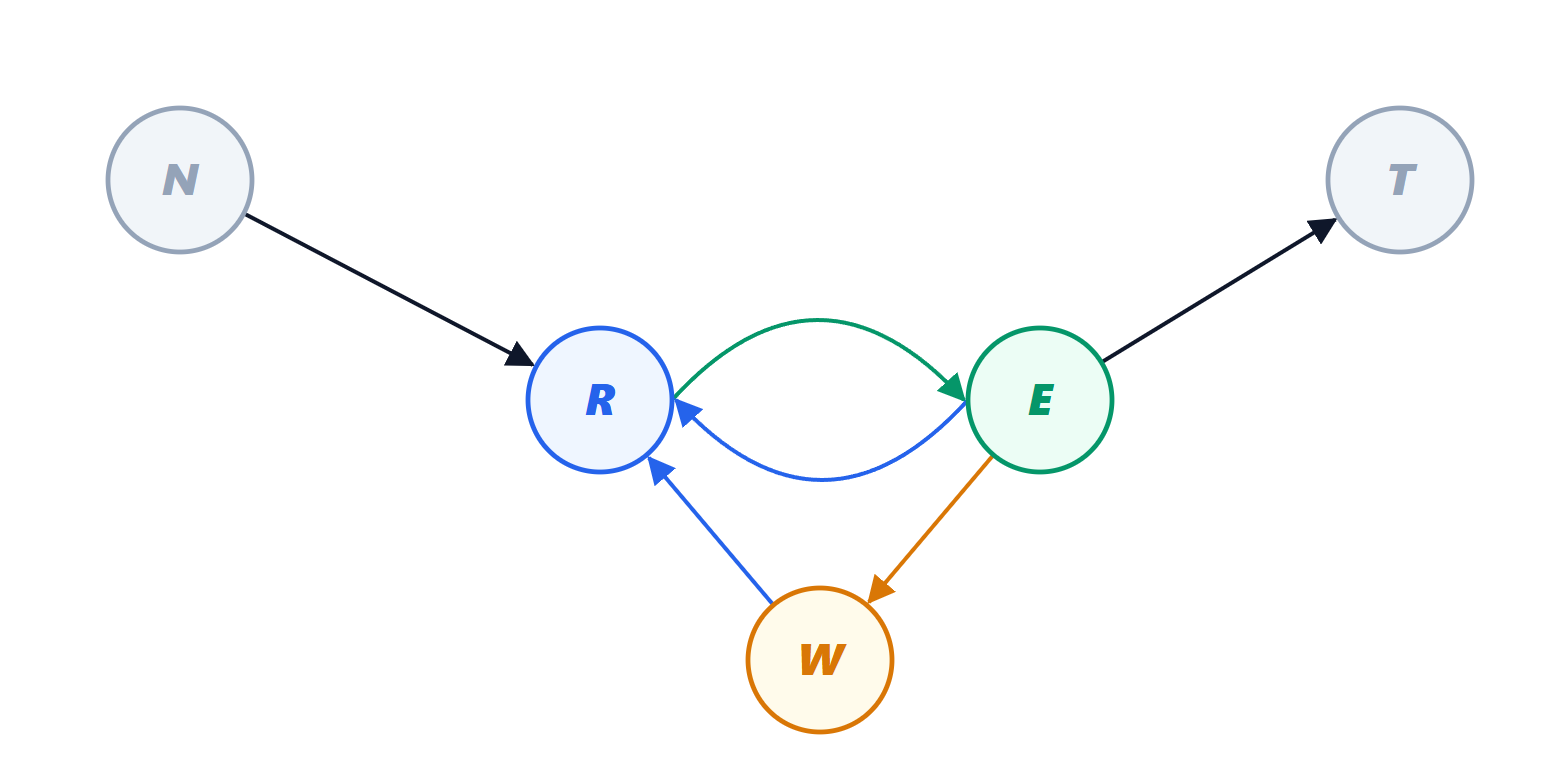
Su una CPU è in esecuzione un solo processo alla volta; gli altri pronti aspettano in coda, e quelli in attesa aspettano un evento (la fine di una lettura dal disco, un pacchetto dalla rete, un tasto). La scelta di chi eseguire è dello scheduler (lezione sulla pianificazione).
La commutazione di contesto
Per passare da un processo a un altro il kernel salva i registri del primo nel suo PCB, carica quelli del secondo e cambia lo spazio di indirizzamento (la tabella delle pagine, lezione sulla memoria virtuale). La commutazione richiede qualche microsecondo, ma il costo vero è indiretto: le cache e il TLB contengono dati del processo precedente e si riempiono di nuovo, lentamente. Uno scheduler che commuta troppo spesso spreca la macchina.
Creare processi in Unix
In Unix un processo nasce clonandone un altro con la chiamata fork: il figlio è una copia del padre (stessa memoria, stessi file aperti), e fork restituisce 0 nel figlio e il PID del figlio nel padre. Per eseguire un altro programma il figlio chiama exec, che sostituisce il suo codice. Il padre può attendere la fine del figlio con wait.
#include <stdio.h>
#include <unistd.h>
#include <sys/wait.h>

int main(void) {
    pid_t pid = fork();
    if (pid == 0) {                        /* figlio */
        execlp("ls", "ls", "-l", NULL);    /* diventa il programma ls */
        perror("exec");                    /* qui solo se exec fallisce */
        return 1;
    }
    waitpid(pid, NULL, 0);                 /* il padre aspetta il figlio */
    printf("figlio %d terminato\n", pid);
    return 0;
}
Copiare tutta la memoria sarebbe lento; i sistemi moderni usano la copia su scrittura (copy-on-write): padre e figlio condividono le pagine, marcate di sola lettura, e una pagina viene duplicata solo quando uno dei due la modifica.
Teorema. Un programma che esegue in sequenza  chiamate fork, senza controllarne il risultato, produce
 processi in tutto.
Dimostrazione. Per induzione su . Con  c’è il solo processo iniziale,
 . Supponiamo che dopo
 fork esistano
 processi; ciascuno prosegue dal punto in cui si trova ed esegue la fork successiva, creando un figlio. I processi diventano
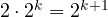 . ∎
Con  si ottengono 1024 processi: è il principio della “bomba a fork”, che si difende limitando il numero di processi per utente.
I thread
Un thread è un flusso di esecuzione dentro un processo: ha propri registri e stack, ma condivide con gli altri thread dello stesso processo memoria e file. Crearlo e commutare tra thread costa meno che tra processi, e la comunicazione è immediata attraverso la memoria comune. Il prezzo è che ogni accesso condiviso va sincronizzato (lezione sulla sincronizzazione), e un errore in un thread può corrompere tutto il processo. I thread servono per sfruttare più core (lezione sui sistemi multicore) e per non bloccare un programma interattivo mentre aspetta il disco o la rete.
La comunicazione tra processi
Processi separati comunicano attraverso il kernel:
- pipe: un canale di byte a senso unico tra due processi; la shell le usa per collegare i comandi, come in ls | grep txt, dove l’uscita del primo diventa l’ingresso del secondo;
- memoria condivisa: una zona mappata negli spazi di indirizzamento di più processi, velocissima ma da sincronizzare;
- code di messaggi e socket, che funzionano anche tra macchine diverse (lezione sull’architettura a strati di Reti di telecomunicazione);
- segnali: notifiche asincrone, come l’interruzione con Ctrl-C.
I filtri di Unix, piccoli programmi che leggono un flusso di testo e lo trasformano, come sed, grep e sort, si compongono con le pipe in catene potenti: è la filosofia “fai una cosa sola e falla bene”.