Architettura del calcolatore: von Neumann, memoria e compilazione
CPU, memoria, ingresso e uscita, ciclo fetch-decode-execute, gerarchia di memoria e cache, dal codice C all'eseguibile, architettura Harvard dei microcontrollori.
Prima di scrivere programmi conviene sapere che cosa succede dentro la macchina che li esegue. Dal microcontrollore di una lavatrice al server di un data center, quasi tutti i computer seguono lo stesso schema, proposto da von Neumann nel 1945: un processore, una memoria che contiene sia i dati sia le istruzioni, e dispositivi di ingresso e uscita, collegati da un bus. In questa lezione vediamo come è fatto, come esegue un programma e che cosa succede quando si compila un programma in C.
L’architettura di von Neumann
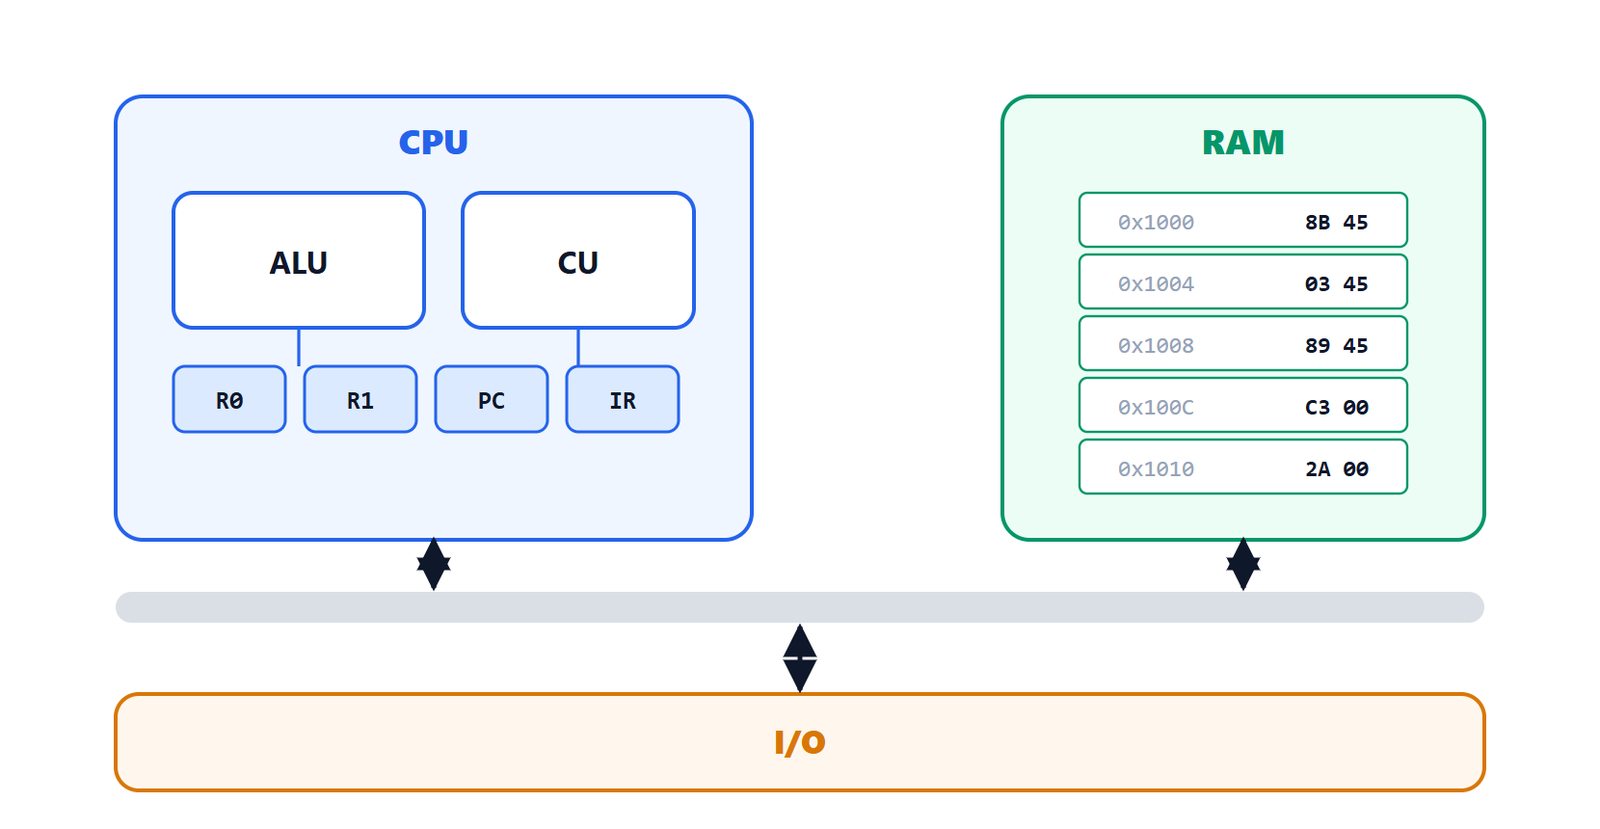
- CPU (unità centrale di elaborazione). L’ALU esegue le operazioni aritmetiche e logiche; l’unità di controllo legge le istruzioni e coordina il resto; i registri sono poche celle di memoria velocissime dentro il processore. Due registri speciali: il program counter (PC), che contiene l’indirizzo della prossima istruzione, e l’instruction register (IR), che contiene quella in esecuzione.
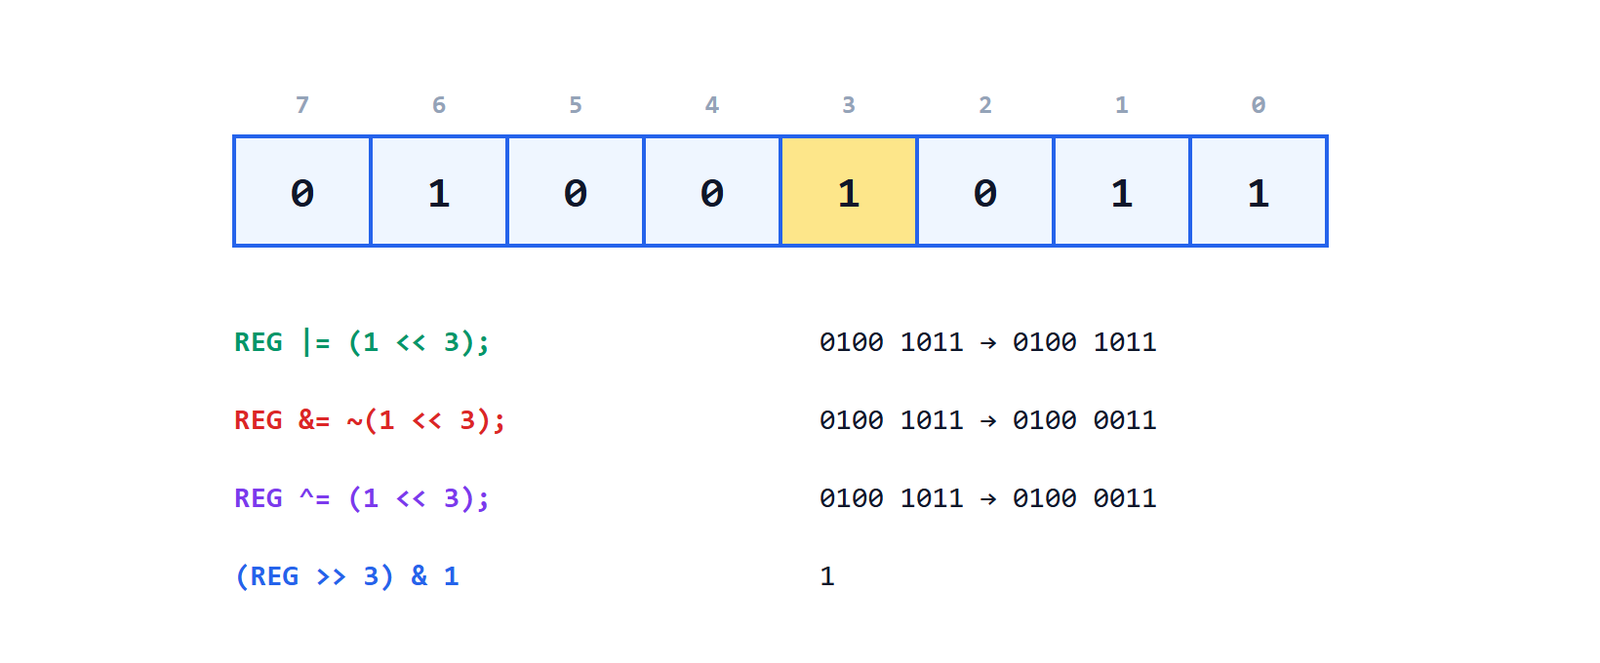
- Memoria centrale (RAM). Una lunga sequenza di celle, ciascuna con un indirizzo. Ogni cella contiene un byte (8 bit). È volatile: si cancella quando manca l’alimentazione.
- Ingresso e uscita. Tastiera, schermo, rete, disco, ma anche sensori e attuatori in un sistema embedded.
- Bus. I collegamenti tra le parti: indirizzi, dati e segnali di controllo.
Il ciclo fetch-decode-execute
Il processore ripete all’infinito tre passi, scanditi dal clock:
- fetch: legge dalla memoria l’istruzione all’indirizzo contenuto nel PC e incrementa il PC;
- decode: l’unità di controllo interpreta l’istruzione (che operazione, su quali registri o indirizzi);
- execute: l’ALU esegue l’operazione, e il risultato va in un registro o in memoria.
Un’istruzione di salto cambia il PC, ed è così che si realizzano le condizioni e i cicli. Un processore a 3 GHz esegue miliardi di questi cicli al secondo, e i processori moderni ne sovrappongono diversi (pipeline) ed eseguono più istruzioni insieme.
La gerarchia di memoria
La memoria veloce costa cara, quella capiente è lenta. Per questo ci sono più livelli:
| Livello | Dimensione tipica | Tempo di accesso |
|---|---|---|
| registri | qualche centinaio di byte | meno di 1 ns |
| cache L1, L2, L3 | da decine di kB a decine di MB | da 1 a 40 ns |
| RAM | gigabyte | circa 100 ns |
| SSD | terabyte | circa 100 µs |
| disco magnetico | terabyte | circa 10 ms |
Un accesso al disco magnetico è centomila volte più lento di uno alla RAM. La cache funziona perché i programmi tendono a riusare dati appena usati (località temporale) e dati vicini (località spaziale): scorrere un array in ordine è molto più veloce che saltare a caso nella memoria.
Dal codice sorgente al programma eseguibile
Il processore capisce solo il linguaggio macchina: sequenze di bit che codificano le istruzioni, diverse per ogni famiglia di processori (x86, ARM, RISC-V). Scrivere in linguaggio macchina, o nella sua forma leggibile, l’assembly, è possibile ma lungo. Per questo si usano linguaggi ad alto livello come il C, e un compilatore che li traduce.
Il percorso di un programma C, per esempio con gcc:
- preprocessore: espande le direttive
#includee#define; - compilatore: traduce il codice C in assembly e poi in codice oggetto (file .o);
- linker: collega i file oggetto tra loro e con le librerie (come quella che contiene printf) e produce l’eseguibile.
#include <stdio.h>

int main(void)
{
    int a = 3, b = 4;
    int c = a + b;          /* diventa poche istruzioni macchina: carica, somma, salva */
    printf("%d\n", c);
    return 0;
}
Con gcc -S si può vedere l’assembly generato: la somma diventa un’istruzione add tra due registri. Il C è vicino alla macchina: ogni costrutto ha una traduzione prevedibile, ed è per questo che è ancora il linguaggio dei sistemi operativi, dei driver e dei microcontrollori.
Compilatore e interprete. Linguaggi come Python sono invece interpretati: un programma, l’interprete, legge il codice ed esegue le istruzioni una per una. È più comodo, ma più lento, spesso di decine di volte.
Harvard e i microcontrollori
Molti microcontrollori, come gli AVR di Arduino e i PIC, usano l’architettura Harvard: memorie e bus separati per le istruzioni (Flash, non volatile) e per i dati (RAM). Il processore può leggere un’istruzione e un dato nello stesso ciclo. I processori ARM Cortex-M combinano le due idee: bus separati, ma un unico spazio di indirizzi in cui stanno Flash, RAM e i registri delle periferiche, che si leggono e scrivono come normali celle di memoria. È questo che permette al C di controllare direttamente l’hardware, come vedremo nell’ultima lezione del corso.