Esecuzione fuori ordine: Tomasulo, buffer di riordino e speculazione
Emissione, esecuzione e completamento, stazioni di prenotazione e bus comune, buffer di riordino ed eccezioni precise con dimostrazione, esecuzione speculativa e Spectre, disambiguazione della memoria.
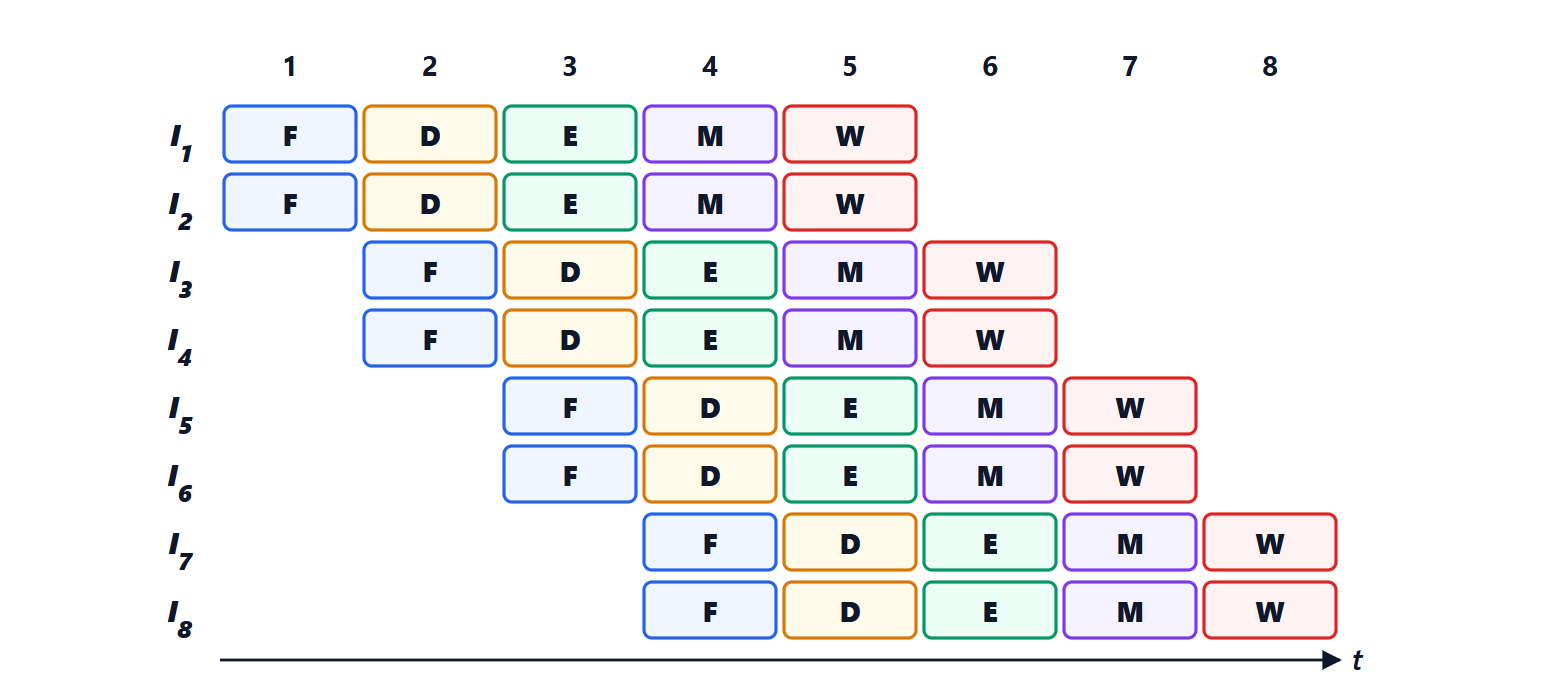
Una pipeline in ordine si blocca quando un’istruzione aspetta un dato, e con lei tutte quelle che seguono, anche se indipendenti. Un processore fuori ordine lascia passare avanti le istruzioni pronte, e riordina i risultati alla fine. È l’idea dell’algoritmo di Tomasulo (IBM 360/91, 1967), che con l’aggiunta del buffer di riordino è il cuore di tutti i processori ad alte prestazioni di oggi. In questa lezione vediamo le stazioni di prenotazione, il bus comune dei risultati, il buffer di riordino con la dimostrazione che garantisce eccezioni precise, l’esecuzione speculativa e la disambiguazione della memoria.
L’idea
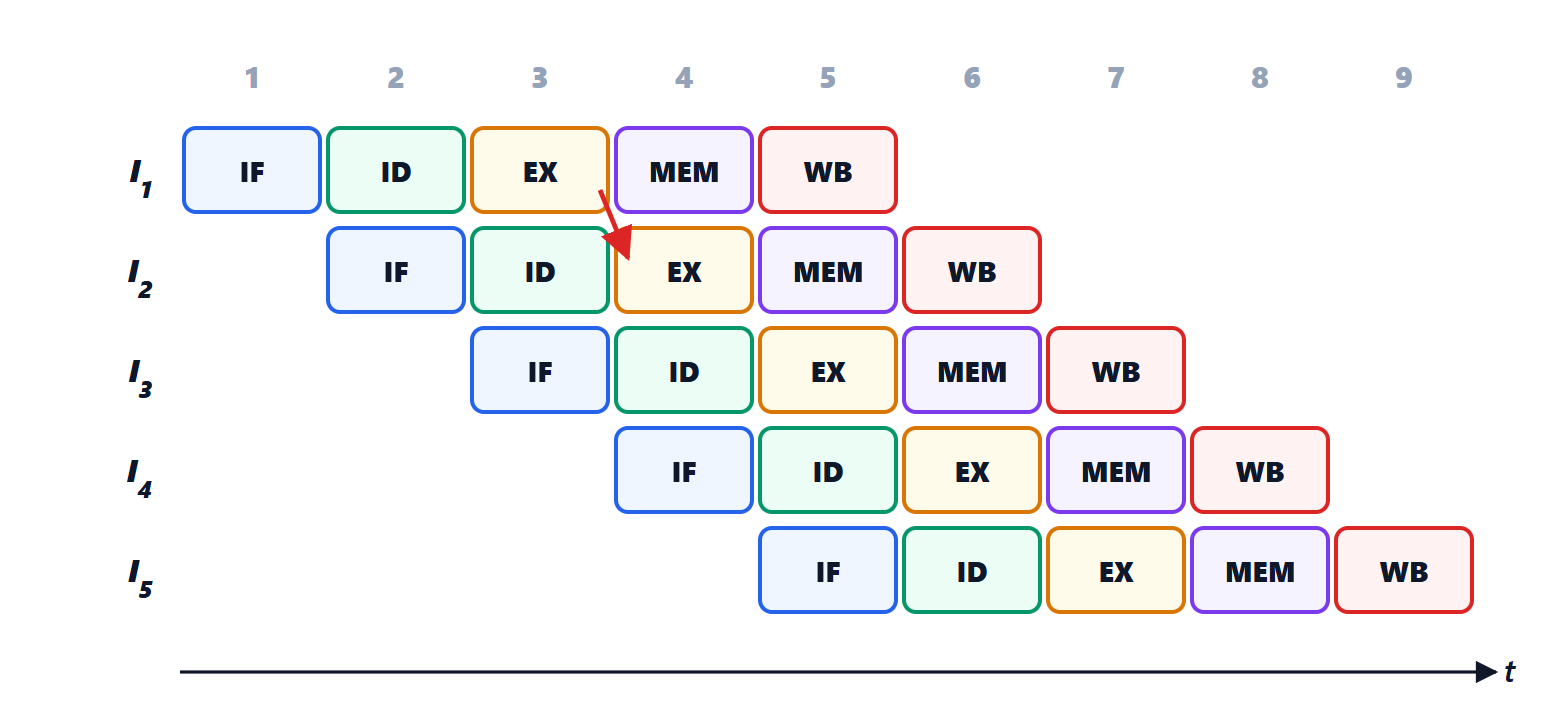
Un caricamento che manca la cache può costare centinaia di cicli. In una pipeline in ordine il processore resta fermo per tutto quel tempo. Eppure, dietro il caricamento, ci sono spesso decine di istruzioni che non c’entrano nulla con il dato atteso. L’esecuzione fuori ordine separa tre momenti che nella pipeline semplice coincidono:
- emissione (issue), in ordine: l’istruzione viene decodificata, i suoi registri rinominati, e viene messa in attesa;
- esecuzione, fuori ordine: parte appena i suoi operandi sono disponibili;
- completamento (commit), di nuovo in ordine: il risultato diventa definitivo, visibile all’architettura.
Stazioni di prenotazione e bus comune
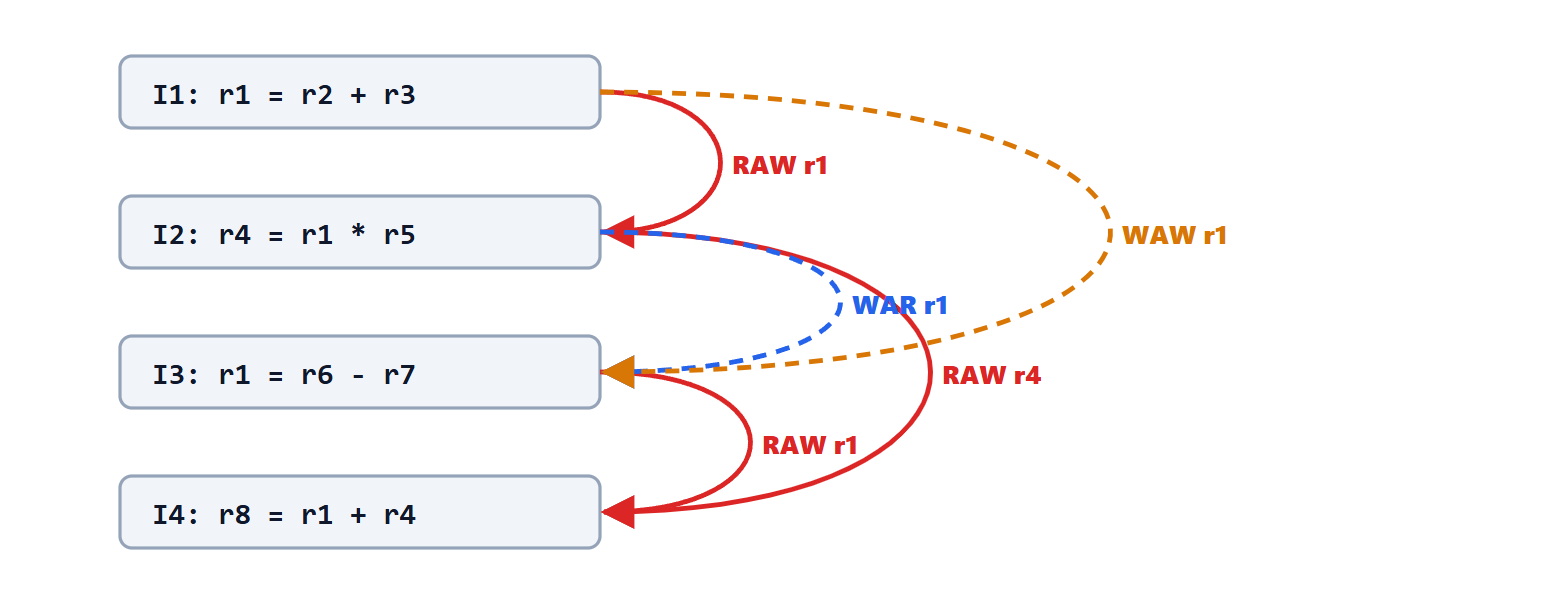
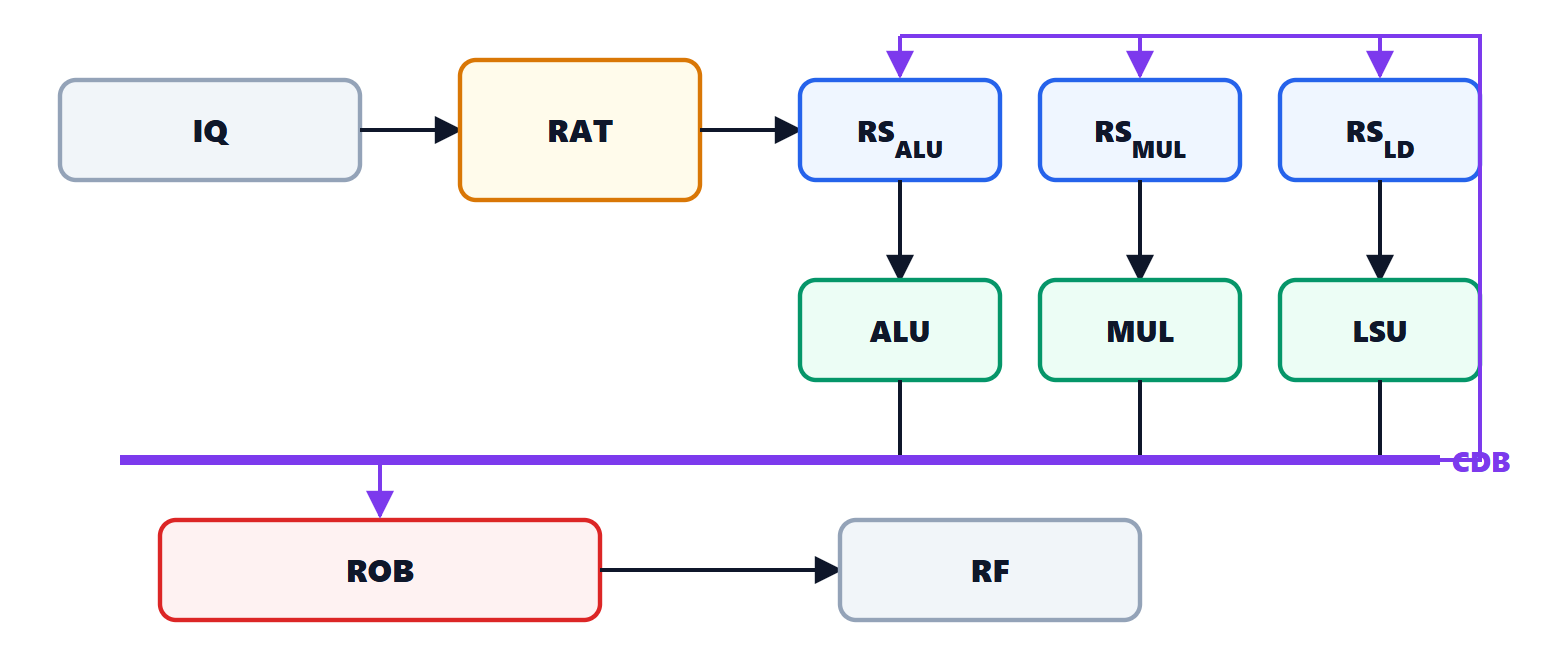
Ogni unità funzionale ha davanti un gruppo di stazioni di prenotazione: registri che contengono un’istruzione in attesa, con i suoi operandi. Per ogni operando la stazione contiene il valore, se è già disponibile, oppure l’etichetta dell’istruzione che lo produrrà. Le etichette sono in pratica i registri fisici della lezione precedente: la rinominazione avviene qui, e le dipendenze WAR e WAW spariscono.
Quando un’unità termina, mette il risultato e la sua etichetta sul bus comune dei risultati (CDB). Tutte le stazioni che aspettano quell’etichetta lo catturano nello stesso ciclo; un’istruzione con tutti gli operandi pronti viene inviata alla sua unità alla prima occasione, indipendentemente dall’ordine del programma. Le dipendenze vere sono rispettate per costruzione, perché nessuna istruzione parte senza i suoi operandi.
Il buffer di riordino
Nell’algoritmo originale i risultati scrivevano direttamente nei registri fuori ordine. Questo crea un problema: se un’istruzione provoca un’eccezione (una divisione per zero, un page fault), alcune istruzioni successive potrebbero aver già modificato lo stato, e il sistema operativo non saprebbe da dove ripartire. La soluzione è il buffer di riordino (ROB): una coda circolare in cui ogni istruzione occupa un posto, nell’ordine del programma, al momento dell’emissione. I risultati vengono scritti nel ROB; un’istruzione completa, cioè scrive nei registri architetturali o nella memoria, solo quando è in testa alla coda e ha finito.
Teorema. Con il completamento in ordine dal ROB, le eccezioni sono precise: quando si gestisce l’eccezione dell’istruzione  , lo stato architetturale contiene i risultati di tutte le istruzioni precedenti a e di nessuna successiva.
Dimostrazione. Lo stato architetturale (registri e memoria) cambia solo al completamento, e le istruzioni completano nell’ordine del programma, una dopo l’altra dalla testa del ROB. L’eccezione di viene registrata nel suo posto del ROB e gestita quando arriva in testa: in quel momento tutte le istruzioni precedenti hanno completato, perché erano davanti nella coda, e nessuna successiva ha completato, perché stanno dietro. Il processore scarta il contenuto del ROB da in poi e salta al gestore. ∎
L’esecuzione speculativa
Lo stesso meccanismo permette di eseguire istruzioni prima di sapere se vanno eseguite. Quando si incontra un salto condizionato, il processore prevede la direzione (lezione sulla predizione) e continua a emettere istruzioni lungo quella strada. Se la previsione era giusta, quelle istruzioni completano normalmente; se era sbagliata, quando il salto arriva in testa al ROB tutte le istruzioni successive vengono scartate e si riparte dall’indirizzo corretto. Nulla di quanto fatto per errore ha toccato lo stato architetturale.
Lo stato micro-architetturale invece sì: le istruzioni eseguite per errore possono aver caricato dati nelle cache. È il principio degli attacchi Spectre (2018), che deducono dati segreti misurando i tempi di accesso alla cache dopo un’esecuzione speculativa. Le contromisure (barriere, isolamento, modifiche ai compilatori) costano qualche punto percentuale di prestazioni.
La memoria
Le dipendenze attraverso la memoria sono le più insidiose: un caricamento può leggere l’indirizzo che una memorizzazione precedente sta per scrivere, ma l’indirizzo si conosce solo dopo averlo calcolato. Le memorizzazioni attendono il completamento in una coda delle memorizzazioni; un caricamento confronta il proprio indirizzo con quelli in coda e, se trova una scrittura allo stesso indirizzo, ne prende direttamente il valore (store-to-load forwarding). I processori moderni osano di più: eseguono il caricamento anche prima che gli indirizzi delle scritture precedenti siano noti, prevedendo che non ci sia conflitto, e se si sbagliano annullano e rieseguono.
Le dimensioni
Un processore ad alte prestazioni del 2025 ha un ROB da 500-600 posti, alcune centinaia di registri fisici, una decina di unità funzionali e può avere centinaia di istruzioni “in volo”. La finestra grande serve soprattutto a nascondere le attese della memoria: mentre un caricamento aspetta la DRAM, il processore trova lavoro utile molte istruzioni più avanti.