Parallelismo a livello di istruzione: dipendenze e rinominazione dei registri
Dipendenze vere, antidipendenze e dipendenze d'uscita, rinominazione dei registri con dimostrazione, equazione delle prestazioni con gli stalli, srotolamento dei cicli, limiti dell'ILP.
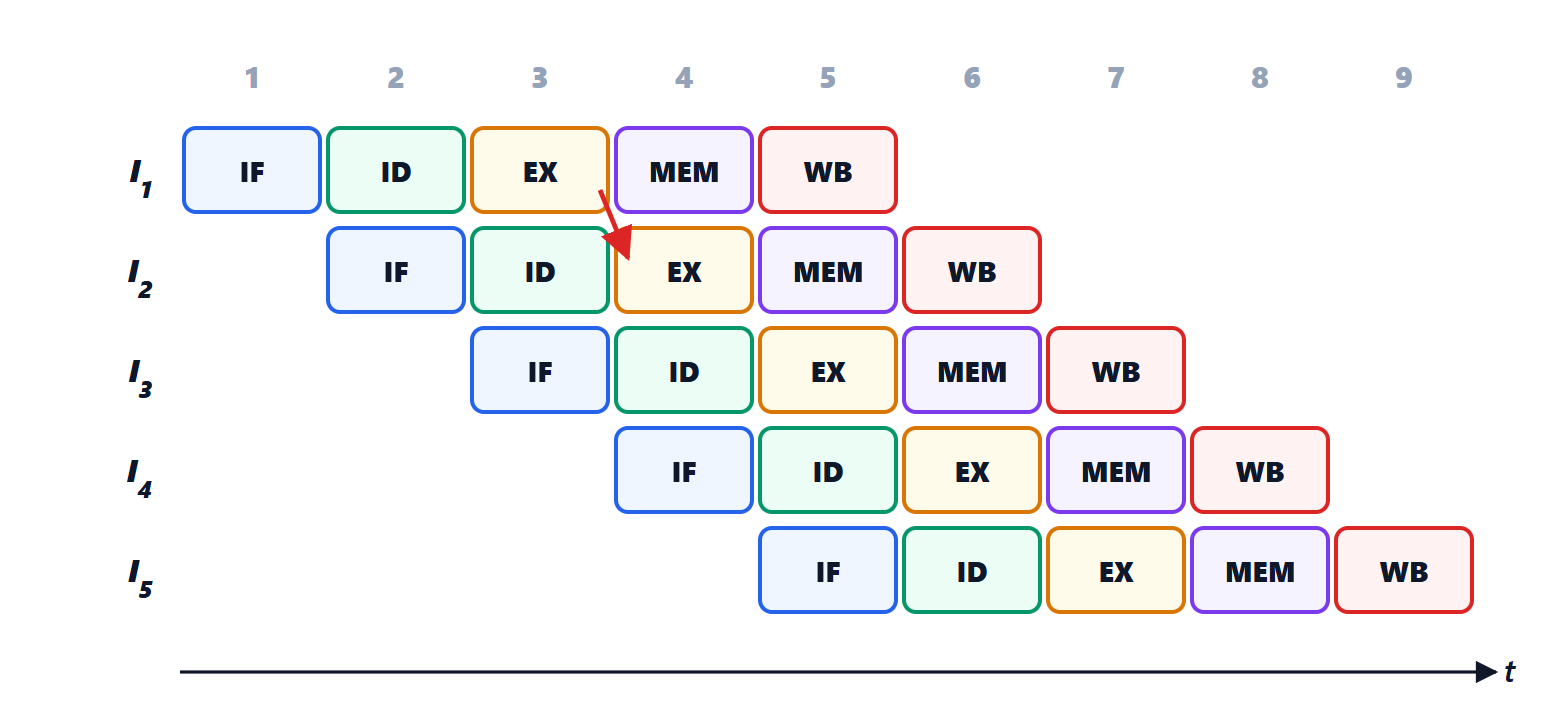
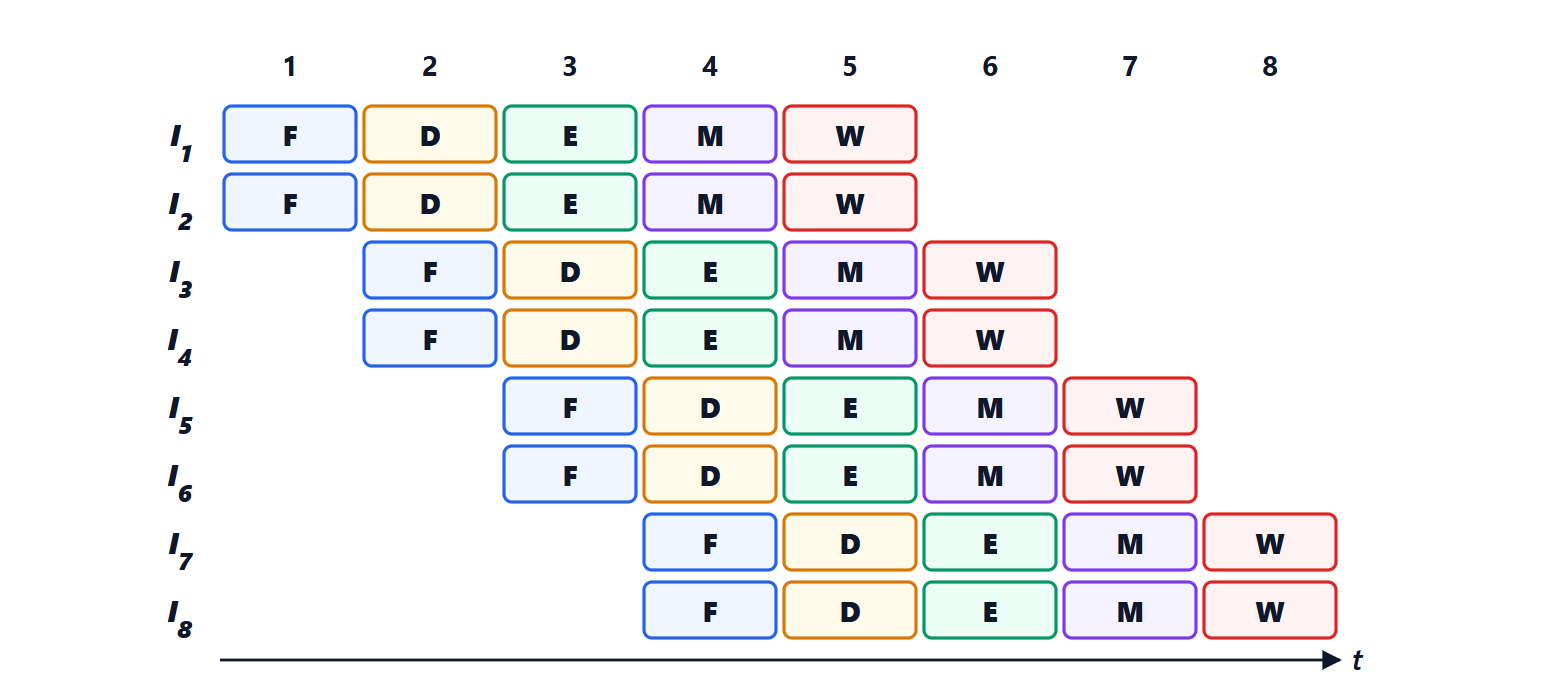
Il corso di Sistemi di elaborazione ha mostrato la pipeline a cinque stadi, che sovrappone l’esecuzione di istruzioni successive. Ma una pipeline semplice arriva al massimo a un’istruzione per ciclo, e si ferma ogni volta che un’istruzione aspetta il risultato di un’altra. Per andare oltre bisogna capire quali istruzioni possono davvero essere eseguite insieme. In questa lezione classifichiamo le dipendenze, dimostriamo che solo quelle vere limitano il parallelismo mentre le altre si eliminano rinominando i registri, scriviamo l’equazione delle prestazioni con gli stalli e vediamo lo srotolamento dei cicli.
Il parallelismo a livello di istruzione
Il parallelismo a livello di istruzione (ILP, instruction-level parallelism) è la possibilità di eseguire più istruzioni dello stesso programma sequenziale nello stesso momento. Il programmatore scrive una sequenza; il processore deve garantire che il risultato sia lo stesso che si otterrebbe eseguendola un’istruzione alla volta, ma è libero di cambiare l’ordine e di sovrapporre tutto ciò che non cambia il risultato.
Le dipendenze
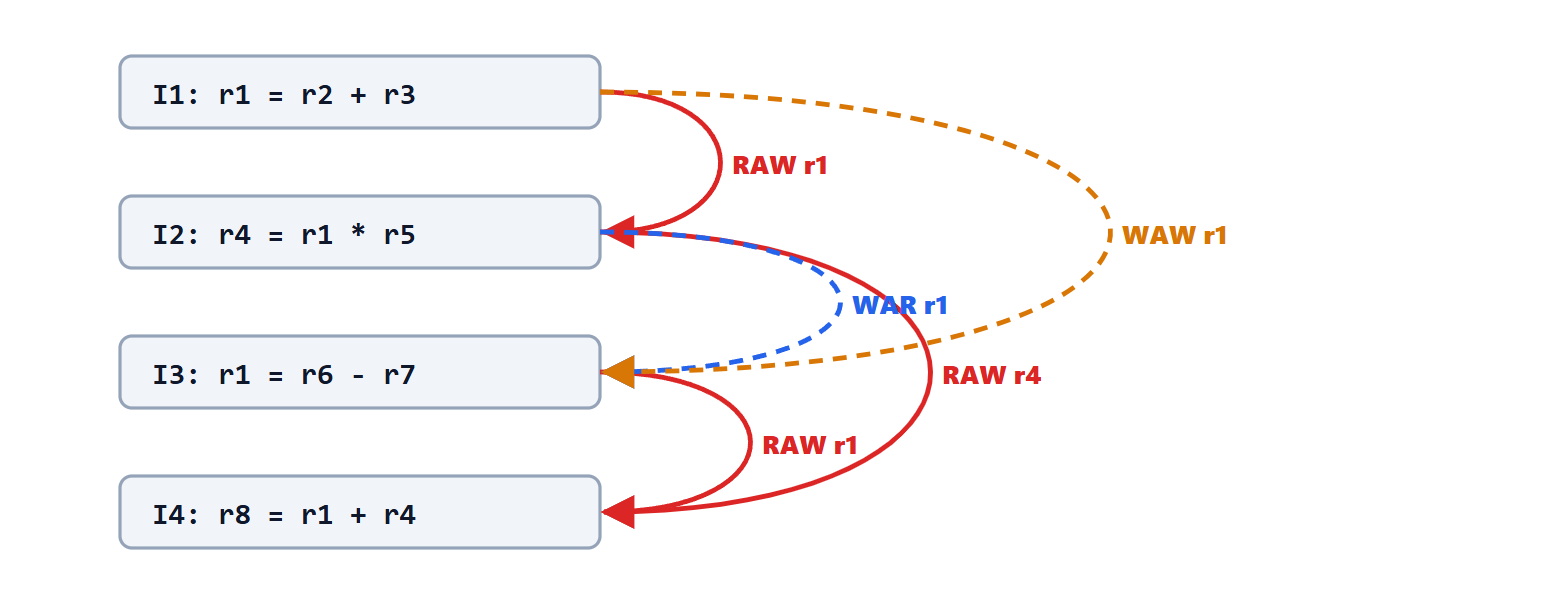
Tra due istruzioni  che precede
 nel programma ci sono tre tipi di dipendenza sui registri:
- dipendenza vera o di dato (RAW, read after write): legge un registro scritto da . Il valore deve passare dall’una all’altra: non può calcolare prima che abbia prodotto il risultato;
- antidipendenza (WAR, write after read): scrive un registro che legge. Se scrivesse per prima, leggerebbe il valore sbagliato;
- dipendenza d’uscita (WAW, write after write): entrambe scrivono lo stesso registro. Alla fine deve restare il valore di .
A queste si aggiungono le dipendenze di controllo, verso i salti condizionati, e quelle attraverso la memoria, più difficili da vedere perché gli indirizzi si conoscono solo durante l’esecuzione.
Dipendenze vere e dipendenze di nome
Le antidipendenze e le dipendenze d’uscita non trasportano dati: esistono solo perché due valori diversi usano lo stesso nome di registro. Nell’esempio della figura,  riusa
 per un valore che non ha nulla a che fare con quello di
 .
Teorema. Se ogni istruzione scrive il proprio risultato in un registro fisico nuovo, mai usato prima, e ogni lettura si riferisce al registro fisico dell’ultima scrittura precedente nel programma, le dipendenze WAR e WAW scompaiono e restano solo quelle RAW.
Dimostrazione. Una WAW richiede due scritture sullo stesso registro: con un registro fisico nuovo per ogni scrittura non ce ne sono più. Una WAR richiede che scriva un registro che legge; ma legge il registro fisico della scrittura precedente a , mentre scrive un registro nuovo, diverso da tutti quelli esistenti, quindi diverso da quello letto. Ogni lettura, infine, trova il valore della scrittura che la precede nel programma, cioè lo stesso valore dell’esecuzione sequenziale: il risultato non cambia. ∎
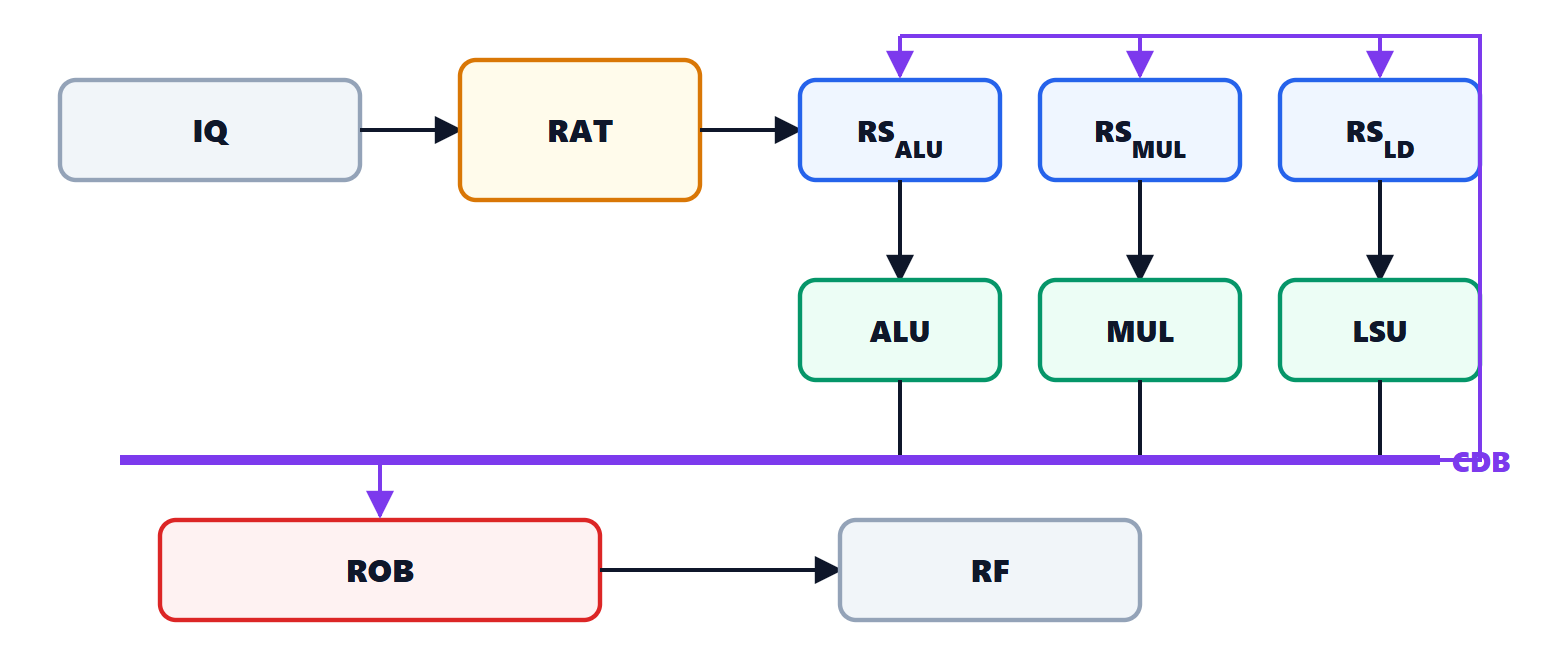
Questa è la rinominazione dei registri. Il processore ha molti più registri fisici (centinaia) di quelli architetturali visibili al programmatore (32 in RISC-V), e una tabella di rinominazione (RAT) che dice, per ogni registro architetturale, quale registro fisico contiene il valore più recente. Nell’esempio, dopo la rinominazione, e sono indipendenti e possono essere eseguite insieme: restano solo le frecce rosse.
L’equazione delle prestazioni con gli stalli
Il tempo di esecuzione è 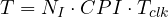 (lezione su von Neumann e le prestazioni). In una pipeline il CPI ideale è 1, e ogni fermo (stallo) lo aumenta:
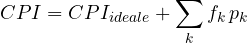
dove  è la frequenza (per istruzione) di un certo tipo di conflitto e
 il numero di cicli persi ogni volta. Per esempio, se il 25 % delle istruzioni sono caricamenti dalla memoria e metà di questi è seguita subito da un’istruzione che usa il dato, con un ciclo perso ogni volta, il contributo è
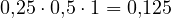 : il CPI passa da 1 a 1,125, e il processore è più lento del 12,5 %.
Lo srotolamento dei cicli
Il compilatore può aumentare l’ILP disponibile. Si consideri un ciclo che somma una costante a ogni elemento di un vettore: ogni iterazione carica, somma, memorizza, incrementa l’indice e salta. Le tre istruzioni utili dipendono l’una dall’altra, e in mezzo restano cicli vuoti in attesa dei risultati.
Srotolando il ciclo quattro volte, cioè scrivendo quattro iterazioni nel corpo con registri diversi, si ottengono quattro catene indipendenti. Il compilatore le intercala: mentre la prima somma aspetta il proprio caricamento, si eseguono i caricamenti delle altre tre. I cicli vuoti spariscono, e l’incremento dell’indice e il salto, eseguiti una volta ogni quattro elementi invece che a ogni elemento, pesano un quarto. Il prezzo è un codice più lungo e più registri occupati. I compilatori lo fanno automaticamente con le opzioni di ottimizzazione, e la stessa idea è alla base della vettorizzazione (lezione su SIMD e GPU).
Quanto ILP c’è davvero
Studi su processori ideali, con infinite unità e predizione perfetta, trovano nei programmi comuni decine di istruzioni eseguibili in parallelo. I processori reali, limitati da predizione, finestre e memoria, ne sfruttano da 2 a 5 per ciclo. Le prossime lezioni mostrano le tecniche che ci si avvicinano: l’esecuzione fuori ordine, la predizione dei salti, i processori superscalari.