Processori superscalari, VLIW e multithreading simultaneo
Emissione multipla e IPC, costo quadratico del controllo con dimostrazione, architetture VLIW e loro limiti, multithreading simultaneo, i muri dell'ILP, della memoria e della potenza, svolta multicore.
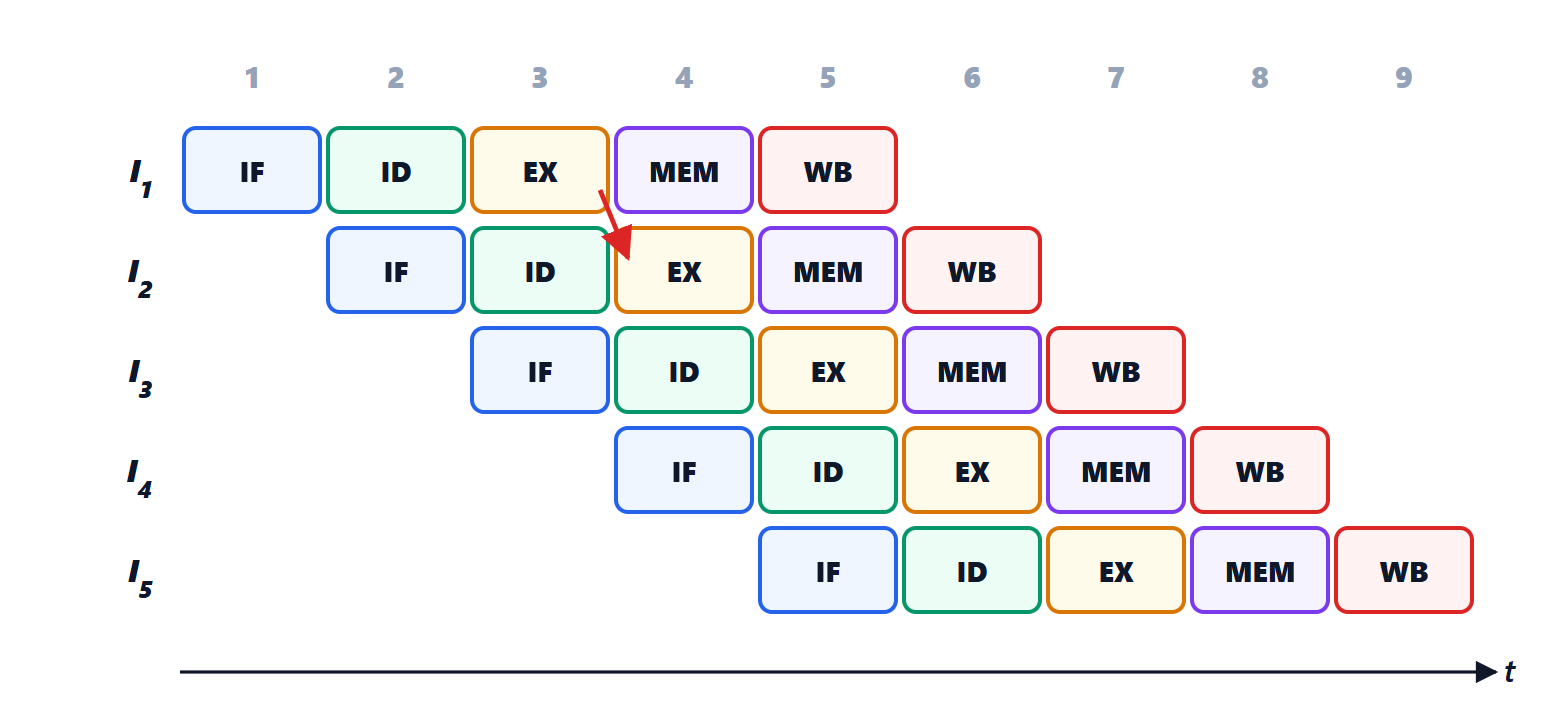
Una pipeline perfetta completa un’istruzione per ciclo. Per fare meglio bisogna prelevare, decodificare ed eseguire più istruzioni per ciclo: è il processore superscalare. In alternativa il parallelismo può essere deciso dal compilatore e scritto esplicitamente nelle istruzioni: è l’approccio VLIW. Oppure si possono riempire i posti vuoti con istruzioni di un altro programma: è il multithreading simultaneo. In questa lezione vediamo le tre strade, dimostriamo perché la complessità del controllo cresce con il quadrato della larghezza, e vediamo i limiti che hanno spinto l’industria verso i multicore.
Il processore superscalare
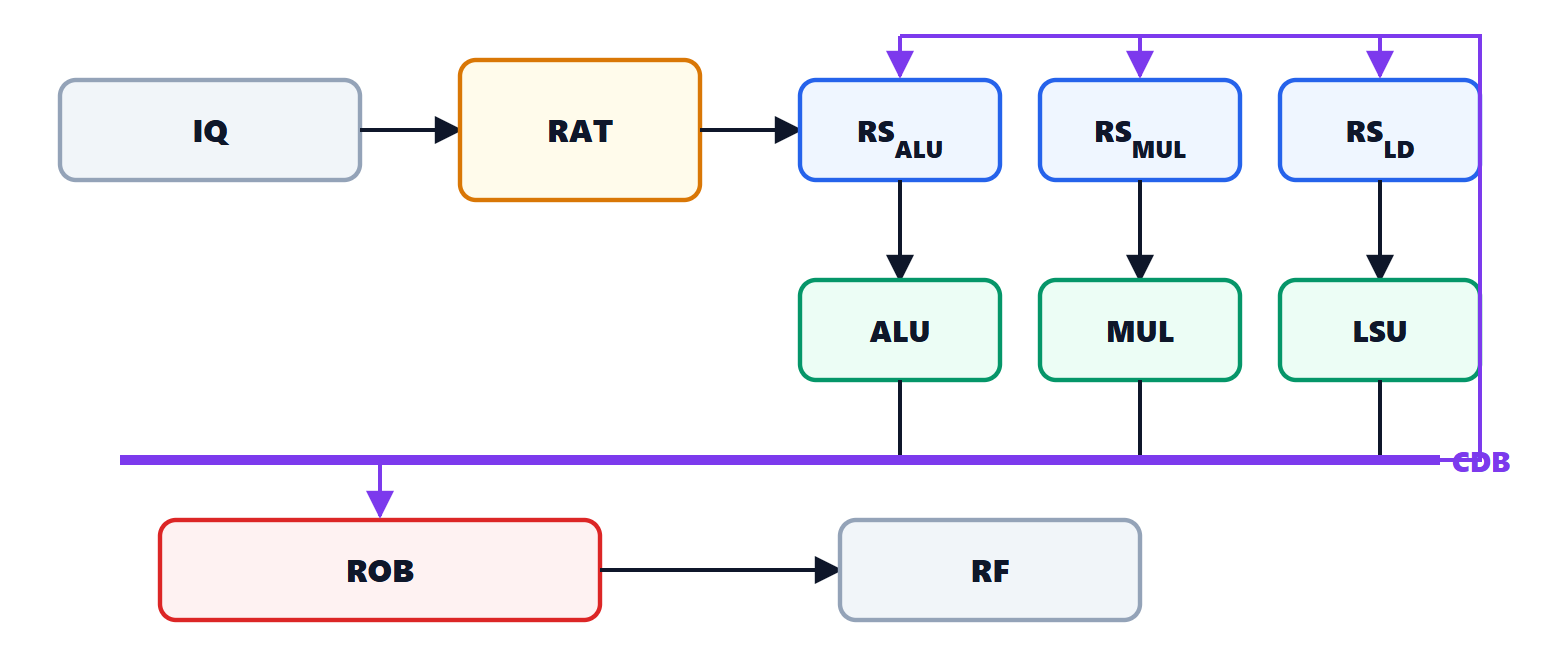
Un processore superscalare a  vie preleva e decodifica fino a istruzioni per ciclo, le rinomina e le invia alle unità funzionali, che sono più di una per tipo. Nel caso ideale completa istruzioni per ciclo: il CPI scende a
 , e si preferisce parlare del suo inverso, l’IPC (istruzioni per ciclo).
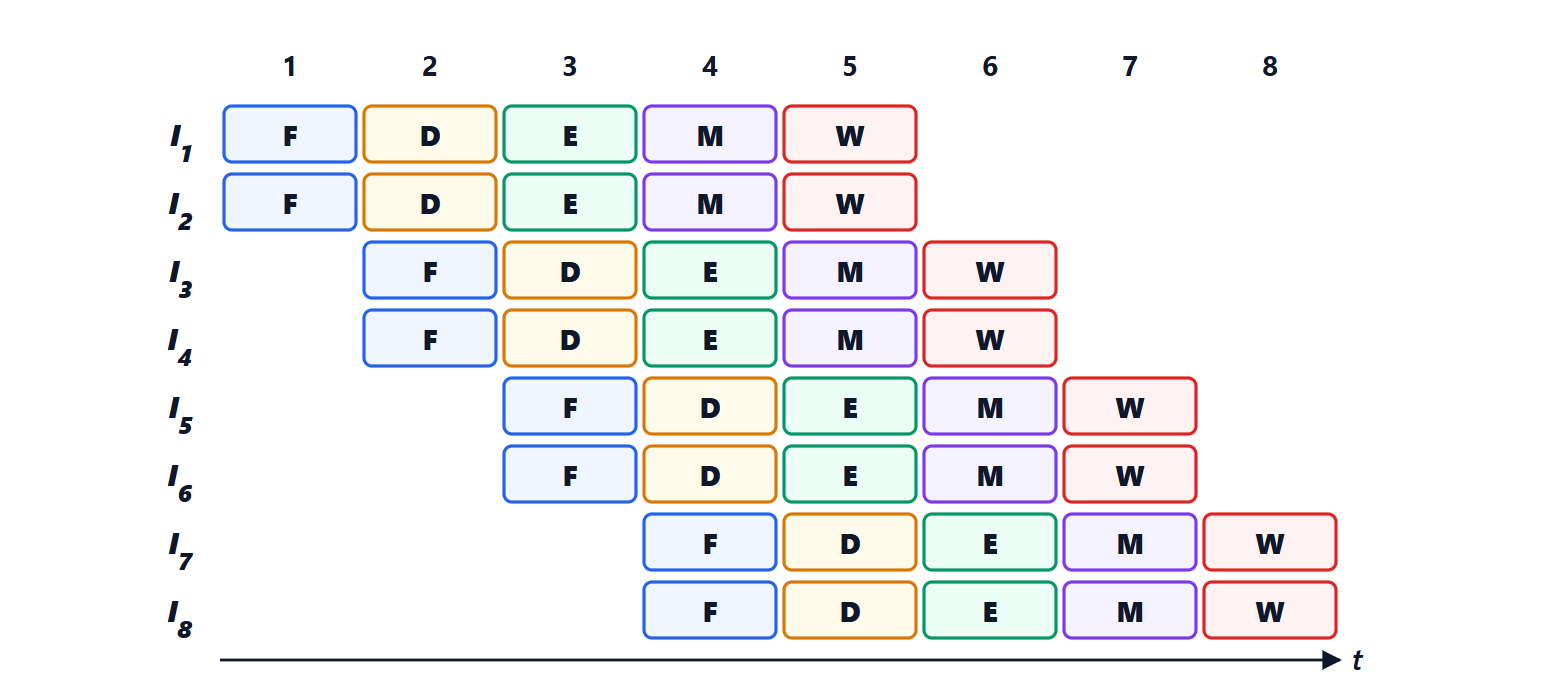
L’IPC reale è molto più basso di : le dipendenze vere, i salti previsti male e soprattutto le attese della memoria lasciano molti posti vuoti. Un processore a 6-8 vie raggiunge tipicamente un IPC tra 2 e 4 sui programmi comuni.
Il costo del controllo
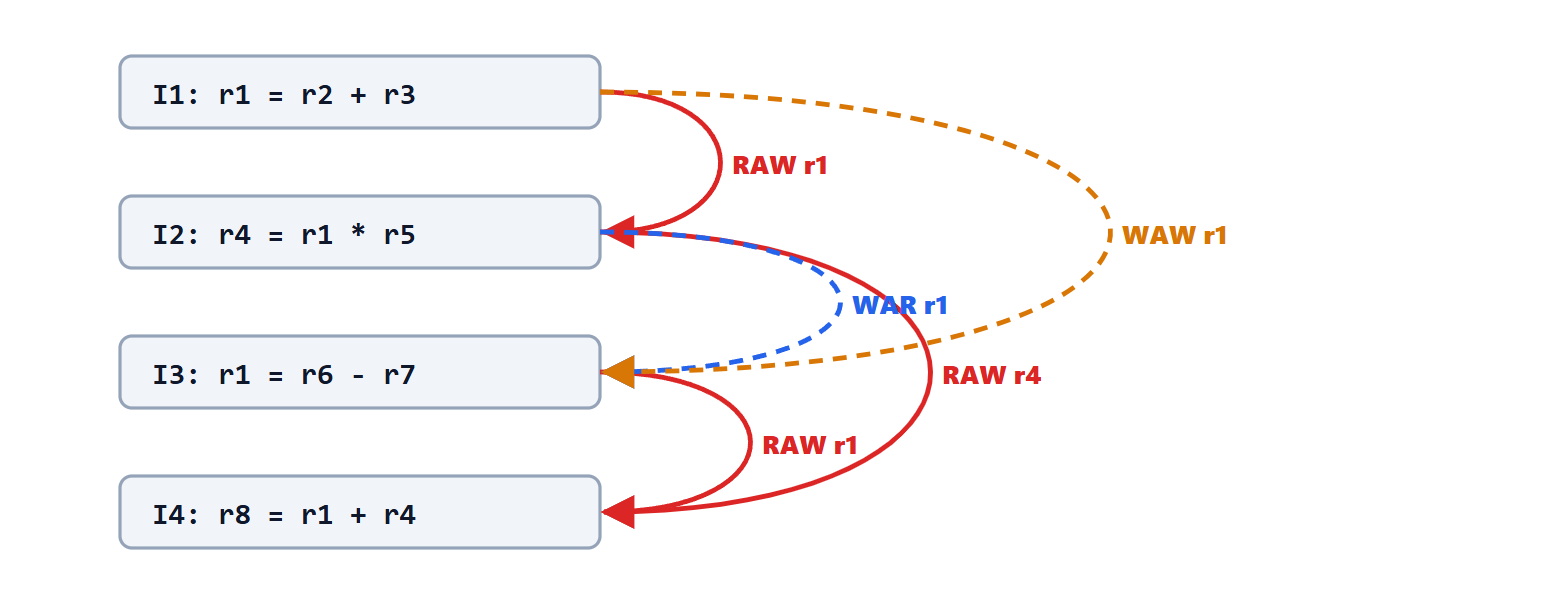
Emettere più istruzioni insieme richiede di controllare, nello stesso ciclo, le dipendenze tra le istruzioni del gruppo: se la seconda legge un registro scritto dalla prima, deve ricevere il registro fisico nuovo assegnato alla prima, non quello vecchio della tabella di rinominazione.
Teorema. Per rinominare in un ciclo un gruppo di istruzioni con due operandi sorgente ciascuna servono  confronti tra registri.
Dimostrazione. L’istruzione in posizione  del gruppo (da 1 a ) deve confrontare ciascuno dei suoi due registri sorgente con il registro di destinazione di ognuna delle
 istruzioni che la precedono nel gruppo. Il totale è
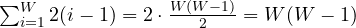 . ∎
Il numero di confronti cresce con il quadrato della larghezza, e lo stesso vale per le porte di lettura e scrittura del banco dei registri, per i collegamenti di inoltro tra le unità e per la logica che sceglie quali istruzioni pronte inviare. Il consumo e la difficoltà di chiudere il ciclo di clock crescono più che linearmente, mentre l’IPC cresce meno che linearmente. Per questo le larghezze si sono fermate tra 4 e 10.
VLIW: lasciare il lavoro al compilatore
Nell’architettura VLIW (very long instruction word) ogni istruzione è un pacchetto di operazioni che il compilatore garantisce indipendenti, una per ogni unità funzionale. Il processore non controlla nulla: esegue i pacchetti così come sono, con un hardware semplice e poco energivoro. Il compilatore deve trovare il parallelismo con lo srotolamento dei cicli e la programmazione delle istruzioni (lezione sulle dipendenze), riempiendo con operazioni nulle i posti che non riesce a usare.
Il VLIW ha avuto un grande successo nei DSP e negli acceleratori, dove il codice è fatto di cicli regolari e prevedibili. Nei processori generici, invece, si è scontrato con due problemi: il compilatore non conosce i ritardi della memoria, che cambiano a ogni esecuzione, e il codice compilato per una generazione non sfrutta la successiva con unità diverse. L’esempio più noto è l’Itanium di Intel e HP, ritirato nel 2021.
Il multithreading simultaneo
Anche il miglior superscalare lascia vuote molte delle sue caselle in ogni ciclo, perché un solo programma non ha abbastanza istruzioni indipendenti. Il multithreading simultaneo (SMT, commercializzato da Intel come Hyper-Threading) fa sembrare un core come due (o più) processori: ha due copie dello stato architetturale (registri, contatore di programma) e preleva istruzioni da entrambi i thread, mescolandole nella stessa finestra fuori ordine. Le istruzioni dei due thread non hanno dipendenze tra loro, e riempiono i posti lasciati liberi dall’altro, soprattutto quando uno dei due aspetta la memoria.
Il guadagno tipico è del 15-30 % di prestazioni complessive con pochi punti percentuali di area in più. Il prezzo è che i due thread si contendono cache, predittori e unità: ciascuno va più lento che da solo, e un thread può spiare l’altro misurando i tempi, motivo per cui alcuni sistemi lo disattivano per sicurezza.
I limiti e la svolta multicore
Fino ai primi anni Duemila le prestazioni dei processori crescevano di circa il 50 % all’anno grazie a frequenze più alte e a più ILP. Poi si sono scontrate con tre muri:
- il muro dell’ILP: oltre una certa larghezza l’IPC non cresce più;
- il muro della memoria: la DRAM è rimasta lenta, centinaia di cicli per un accesso;
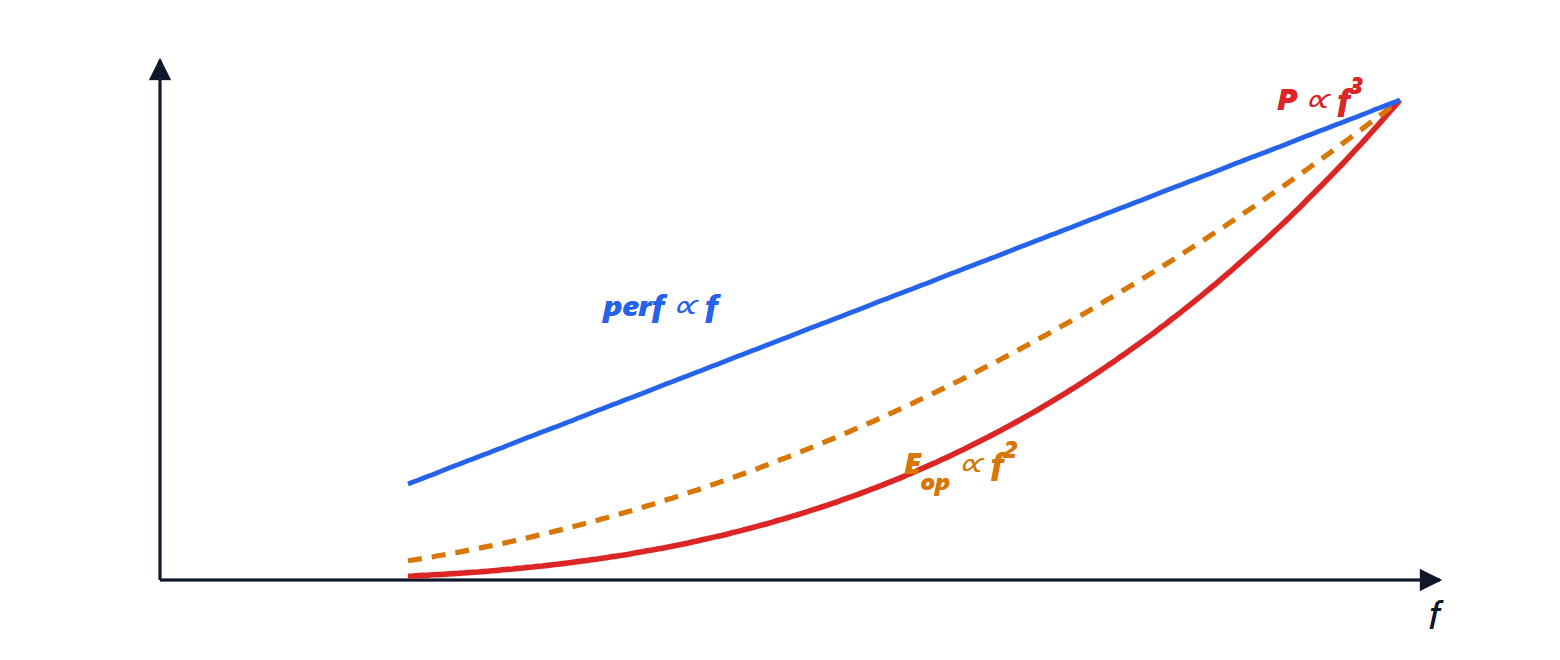
- il muro della potenza: aumentare la frequenza richiede di aumentare la tensione, e la potenza cresce circa con il cubo della frequenza (lezione sull’energia).
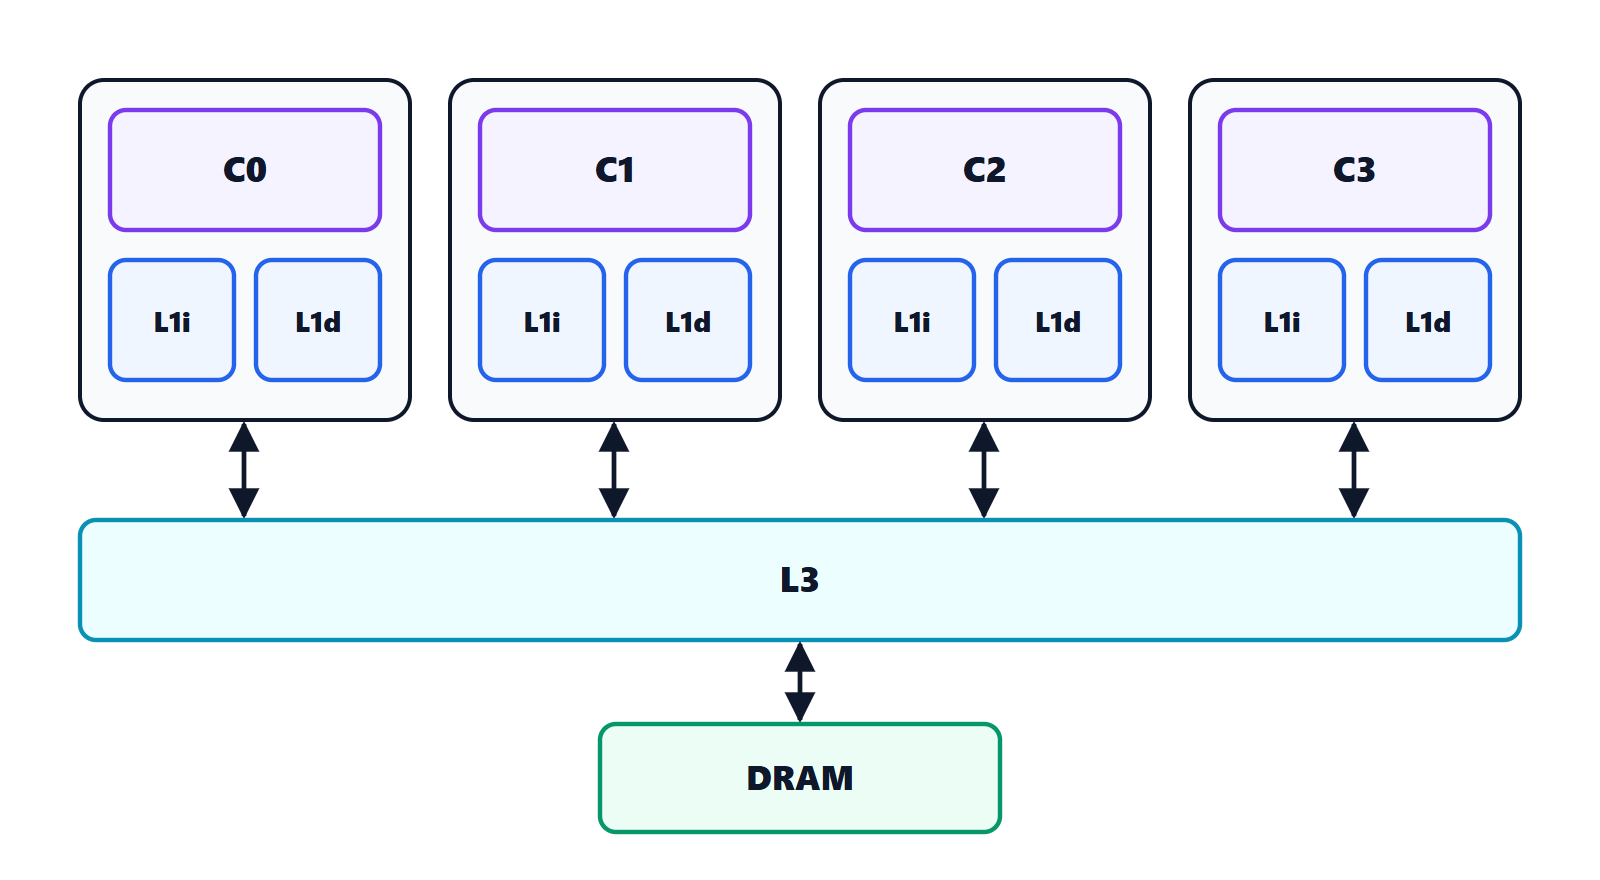
La risposta dell’industria è stata mettere più core sullo stesso chip: invece di un core sempre più grande e caldo, più core di dimensione ragionevole. Ma il parallelismo deve diventare esplicito, scritto dal programmatore con i thread, e la memoria condivisa porta i problemi di coerenza e consistenza della lezione dedicata.