Parallelismo: multicore, thread, sincronizzazione e coerenza delle cache
Processori multicore e thread, corsa critica con esempio, mutex e operazioni atomiche, stallo, coerenza MESI e falsa condivisione, SIMD, GPU, Amdahl e Gustafson.
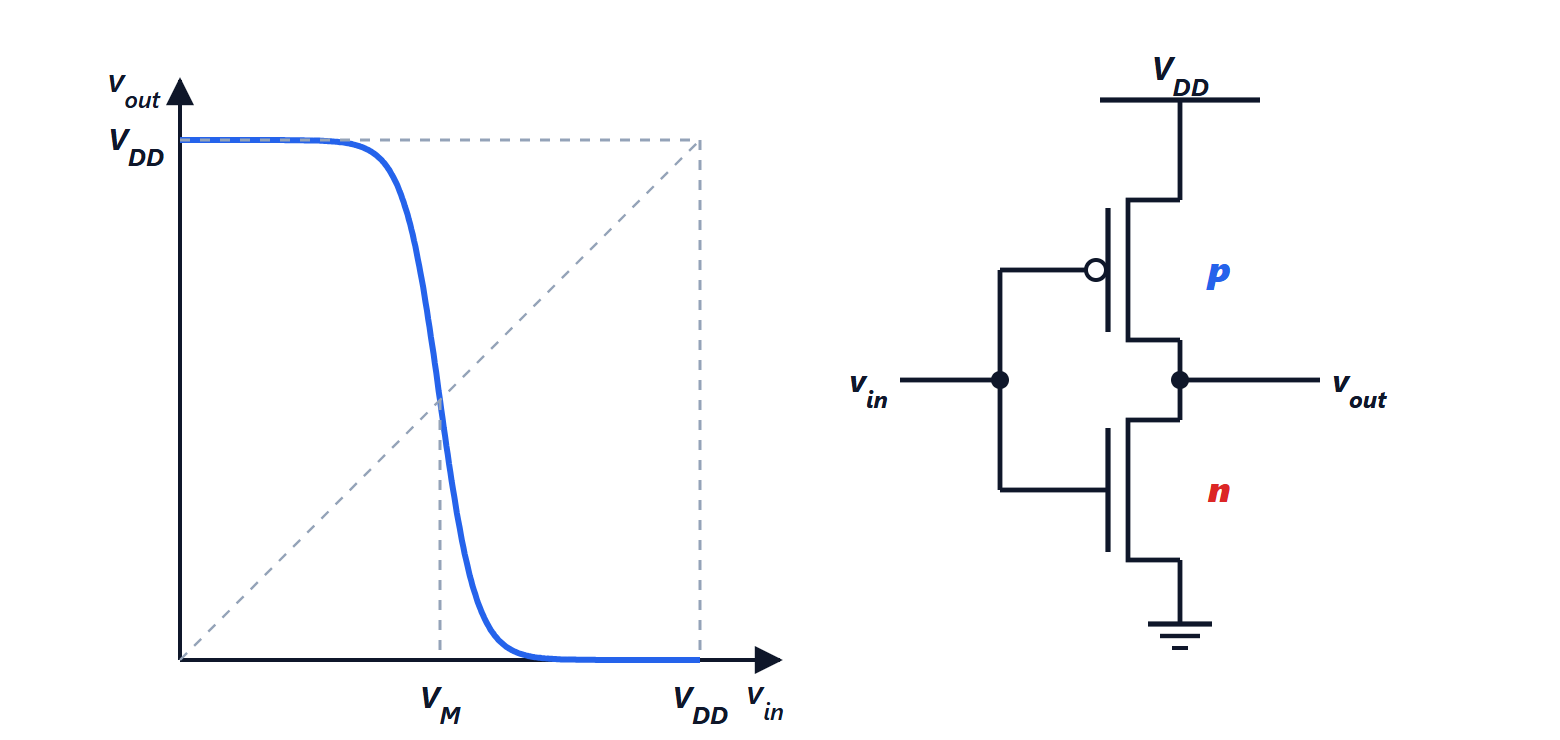
Fino ai primi anni Duemila i programmi diventavano più veloci da soli, a ogni nuova generazione di processori, grazie a frequenze più alte. Poi la frequenza si è fermata (lezione sulla logica CMOS di Dispositivi elettronici), e i transistor in più sono stati usati per mettere più processori, i core, sullo stesso chip. Da allora, per andare più veloci, i programmi devono essere scritti per lavorare in parallelo. In questa lezione vediamo i thread, il problema delle corse critiche, la sincronizzazione, la coerenza delle cache e le altre forme di parallelismo.
Processori multicore
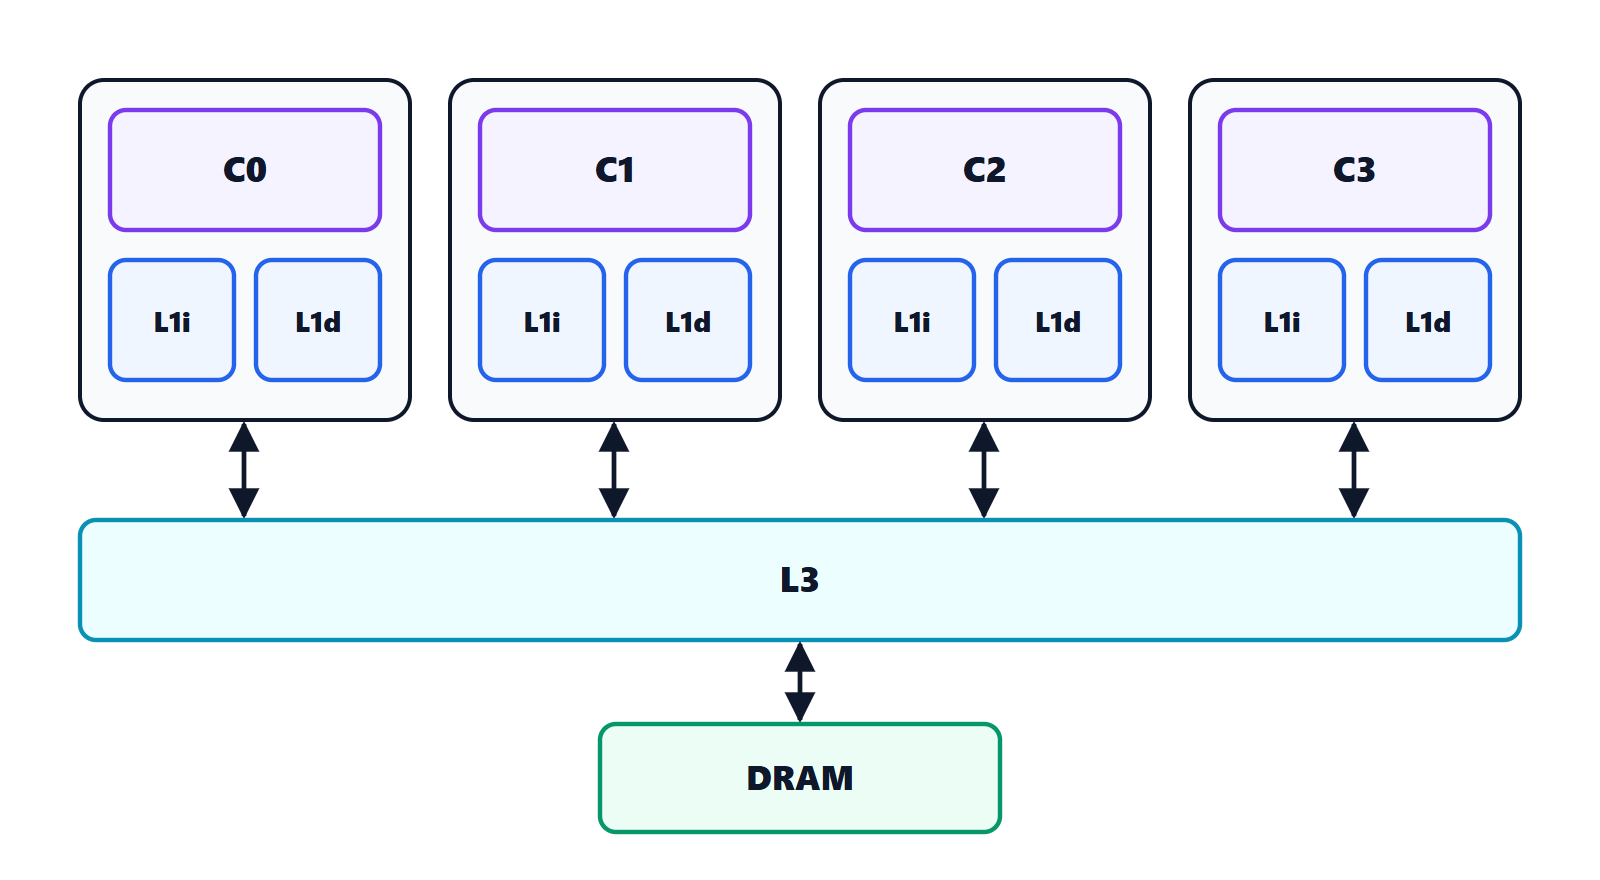
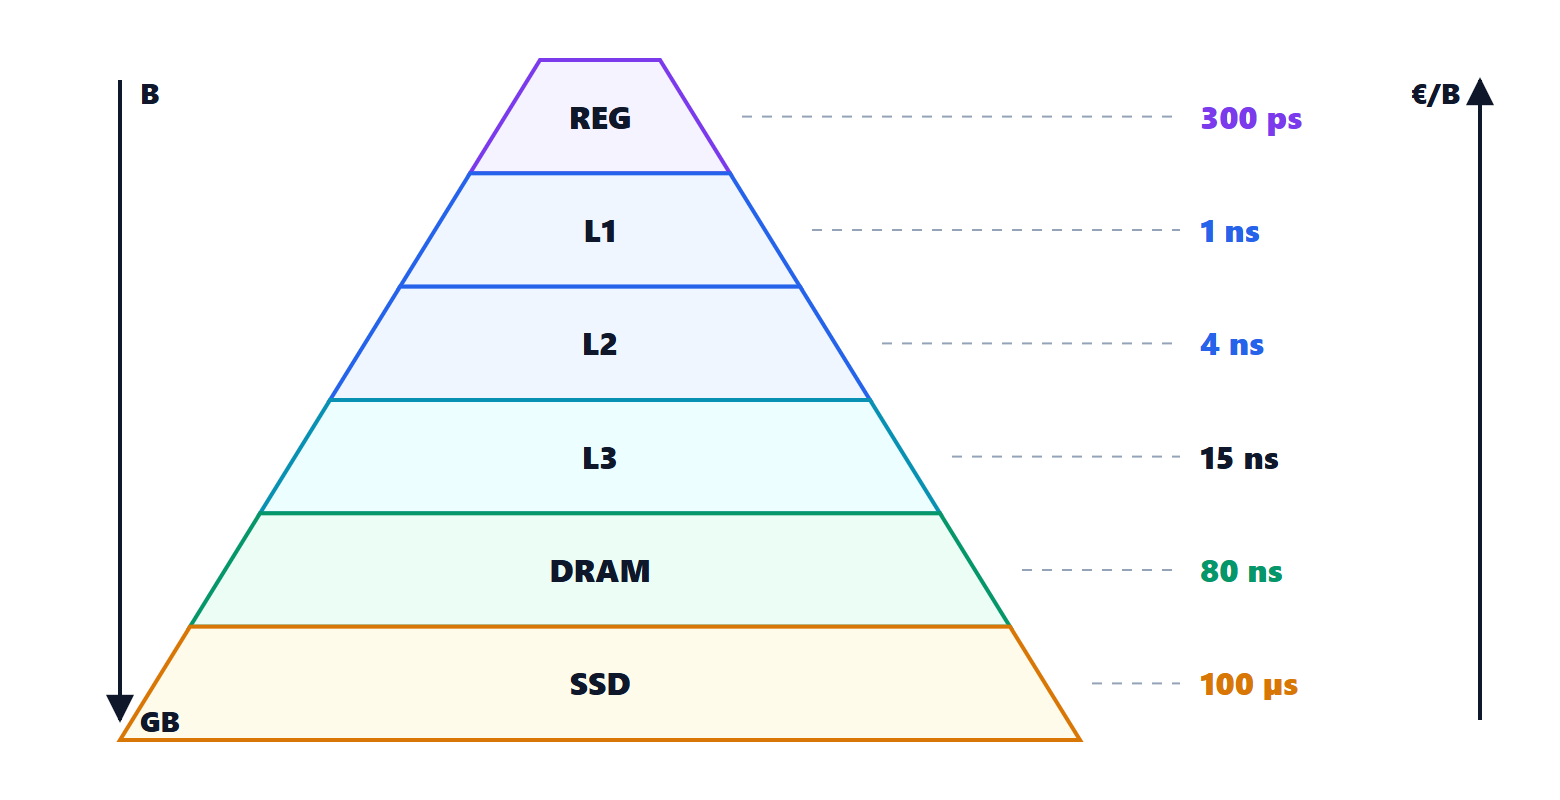
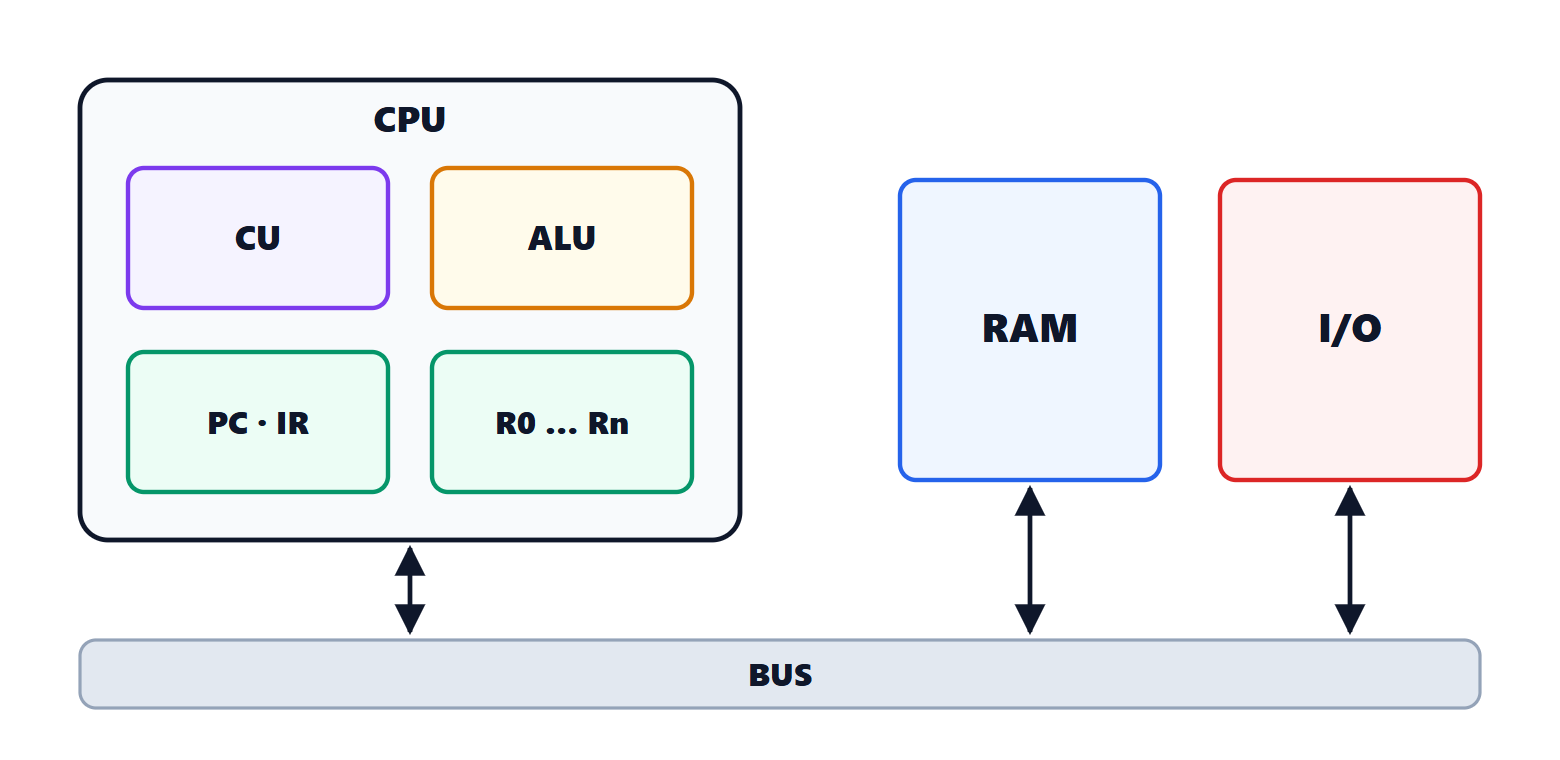
Ogni core è un processore completo, con la sua pipeline e le sue cache private; i core condividono la cache di ultimo livello e la memoria. Il sistema operativo assegna ai core i thread: flussi di esecuzione indipendenti, che possono appartenere a programmi diversi o allo stesso programma. I thread dello stesso programma condividono la memoria, e questo è insieme il loro pregio (si scambiano dati senza copiarli) e il loro pericolo.
La corsa critica
Due thread incrementano un milione di volte ciascuno lo stesso contatore:
int contatore = 0;

void *lavoro(void *arg) {
    for (int i = 0; i < 1000000; i++)
        contatore++;
    return NULL;
}
Il risultato atteso è 2 000 000, ma eseguendo il programma si ottengono valori più bassi e diversi a ogni esecuzione. Il motivo: contatore++ non è un’operazione unica, ma tre istruzioni (carica, somma, memorizza). Se i due thread caricano lo stesso valore, per esempio 41, prima che l’altro abbia memorizzato, entrambi scrivono 42: un incremento è perso. È una corsa critica (race condition): il risultato dipende dall’ordine casuale in cui i thread vengono eseguiti. Questi errori sono tra i più difficili da trovare, perché si presentano raramente e spariscono quando si prova a osservarli.
La sincronizzazione
- Mutua esclusione (mutex): un lucchetto che un solo thread alla volta può tenere. La parte di codice che accede ai dati condivisi, la sezione critica, viene racchiusa tra
lockeunlock:
pthread_mutex_t m = PTHREAD_MUTEX_INITIALIZER;

void *lavoro(void *arg) {
    for (int i = 0; i < 1000000; i++) {
        pthread_mutex_lock(&m);
        contatore++;
        pthread_mutex_unlock(&m);
    }
    return NULL;
}- Operazioni atomiche: l’hardware fornisce istruzioni che leggono, modificano e scrivono una variabile in modo indivisibile (in C,
atomic_fetch_add). Per un contatore sono molto più efficienti di un mutex.
La sincronizzazione ha un costo e introduce nuovi pericoli: lo stallo (deadlock), quando due thread aspettano ciascuno un lucchetto tenuto dall’altro, e la perdita di parallelismo, quando i thread passano più tempo ad aspettarsi che a lavorare. La soluzione migliore è spesso evitare di condividere: ogni thread somma nel suo contatore privato, e solo alla fine si sommano i risultati parziali.
La coerenza delle cache
Se due core hanno in cache una copia dello stesso dato e uno lo modifica, l’altro non deve continuare a leggere il valore vecchio. Un protocollo di coerenza come MESI tiene traccia dello stato di ogni linea in ogni cache (Modificata, Esclusiva, Condivisa, Invalida): prima di scrivere, un core invalida le copie degli altri. Il programmatore non lo vede, ma ne paga gli effetti:
- la falsa condivisione (false sharing): due thread scrivono variabili diverse che stanno nella stessa linea di 64 byte; la linea rimbalza di continuo tra le cache dei due core, e il programma rallenta molto pur non condividendo davvero nulla. Si evita distanziando i dati usati da thread diversi.
Le altre forme di parallelismo
- SIMD (single instruction, multiple data): istruzioni che operano su vettori di 4, 8 o 16 numeri insieme (SSE, AVX sui PC, NEON su ARM). I compilatori le usano automaticamente nei cicli semplici; sono il motivo per cui audio, video e reti neurali girano veloci anche sulla CPU.
- GPU: migliaia di unità semplici che eseguono lo stesso programma su dati diversi. Nate per la grafica, sono diventate il motore del calcolo scientifico e dell’intelligenza artificiale. Funzionano benissimo su problemi molto regolari e con tanti dati, male su codice pieno di condizioni.
- Parallelismo a livello di istruzione: quello sfruttato automaticamente dai processori superscalari e fuori ordine (lezione sulla pipeline).
Quanto si guadagna
Torna la legge di Amdahl: con il 95% del programma parallelizzabile, 16 core danno al massimo un’accelerazione di 9,1 e infiniti core di 20. In più, i thread devono sincronizzarsi e la memoria condivisa ha una banda limitata. La legge di Gustafson offre un punto di vista più ottimista: in pratica, con più core non si risolve più in fretta lo stesso problema, ma un problema più grande nello stesso tempo (una simulazione più fine, un’immagine con più pixel), e lì la parte parallela cresce e l’accelerazione si avvicina al numero di core.