La pipeline: stadi, conflitti, inoltro e predizione dei salti
I cinque stadi, accelerazione con dimostrazione, conflitti sui dati e inoltro, stallo dopo un caricamento, conflitti sul controllo e predizione, CPI con esempio, superscalari.
In una lavanderia con lavatrice, asciugatrice e stiro, non si aspetta che il primo bucato sia stirato prima di mettere in lavatrice il secondo: mentre il primo asciuga, il secondo lava. Ogni bucato impiega lo stesso tempo, ma ne esce uno ogni fase invece che uno ogni tre. È l’idea della pipeline: il percorso dei dati viene diviso in stadi, e ogni stadio lavora su un’istruzione diversa. In questa lezione vediamo la pipeline classica a cinque stadi, quanto fa guadagnare e i conflitti che la rallentano.
I cinque stadi
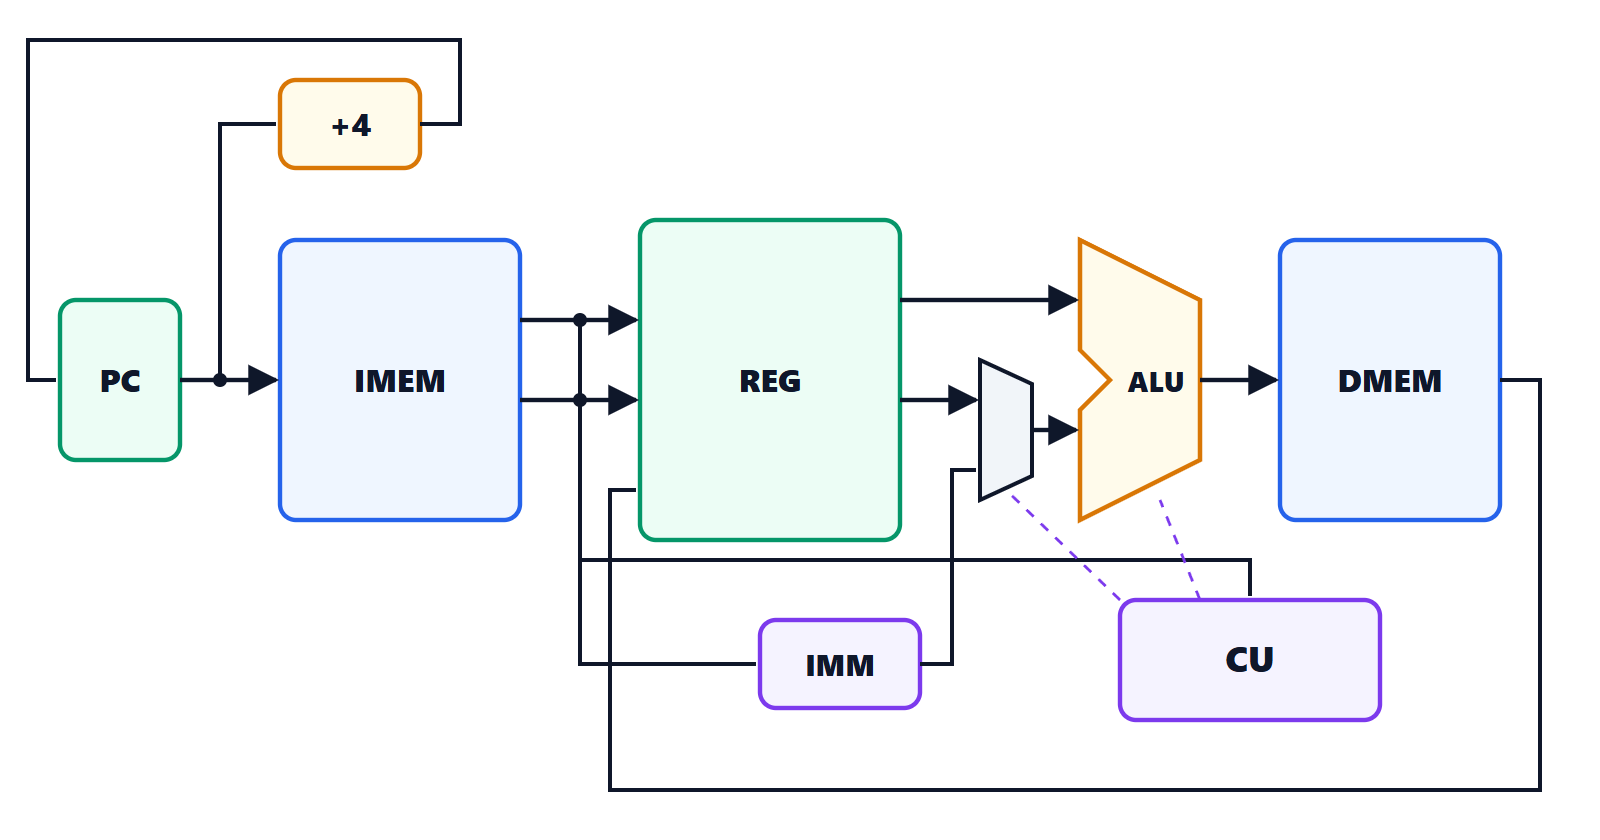
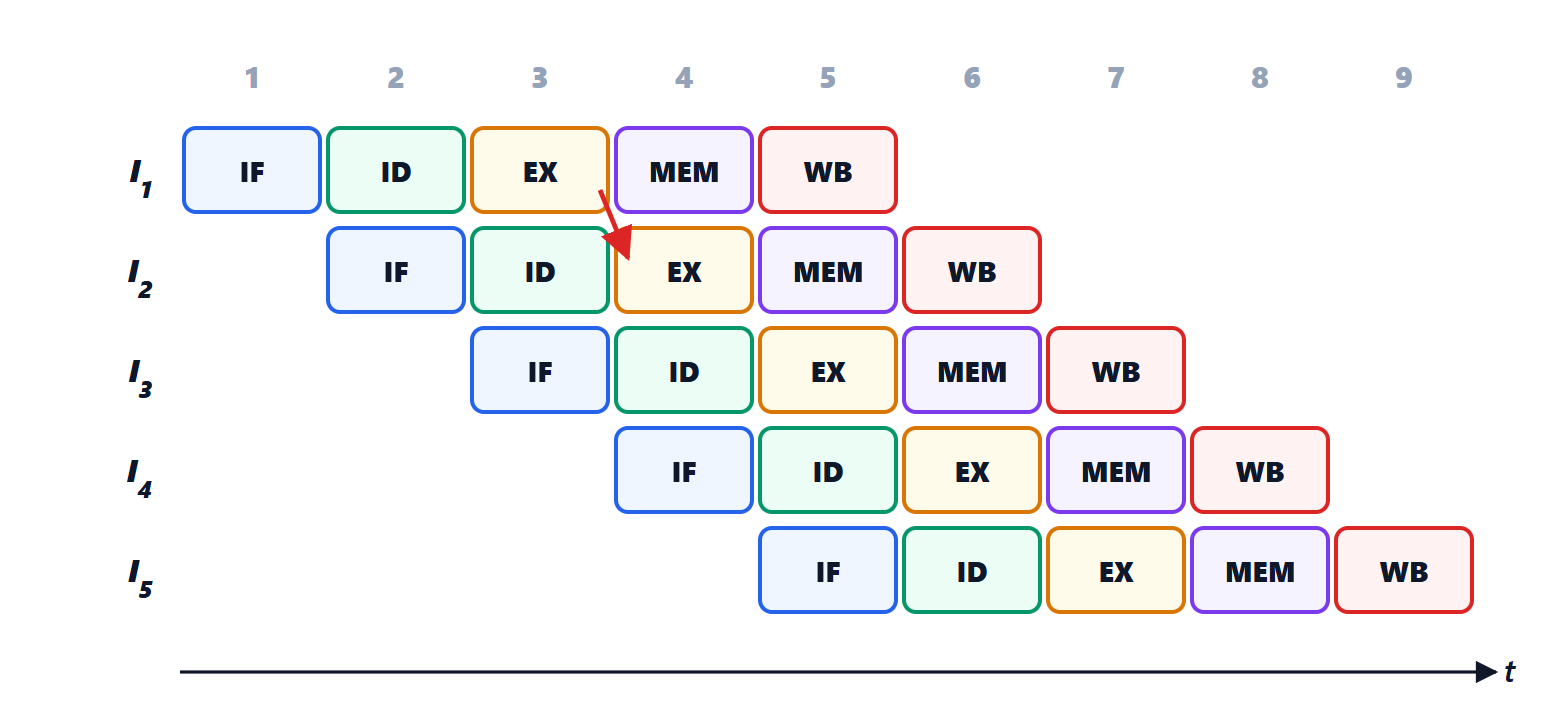
- IF (prelievo): legge l’istruzione e calcola PC + 4;
- ID (decodifica): decodifica e legge i registri;
- EX (esecuzione): l’ALU calcola il risultato o l’indirizzo;
- MEM (memoria): legge o scrive la memoria dei dati;
- WB (scrittura): scrive il risultato nel banco dei registri.
Tra uno stadio e l’altro ci sono dei registri di pipeline, che conservano i risultati intermedi e li passano allo stadio successivo al fronte del clock.
Il guadagno
Il periodo di clock è ora quello dello stadio più lento (circa 200 ps nell’esempio della lezione precedente, invece di 700).
Teorema. Con  stadi di durata uguale,
 istruzioni richiedono
 cicli, e l’accelerazione rispetto all’esecuzione senza pipeline è
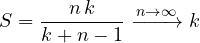
Dimostrazione. La prima istruzione esce dopo cicli; da lì ne esce una a ogni ciclo, quindi le altre  richiedono altri cicli. Senza pipeline ogni istruzione occupa cicli dello stesso periodo, cioè
 in tutto. ∎
Con 5 stadi e un milione di istruzioni l’accelerazione è praticamente 5. La pipeline non rende più veloce la singola istruzione (anzi, la rallenta un po’ per i registri aggiuntivi), ma aumenta il numero di istruzioni completate per unità di tempo.
In pratica gli stadi non sono perfettamente bilanciati, e soprattutto ci sono i conflitti (hazard), situazioni in cui un’istruzione non può procedere al ciclo successivo.
Conflitti sui dati
add  x5, x6, x7
sub  x8, x5, x9     # usa x5, che add non ha ancora scritto
add scrive x5 nello stadio WB, al quinto ciclo; sub lo legge nello stadio ID, al terzo. Senza correttivi leggerebbe il valore vecchio.
- Inoltro (forwarding): il risultato è già disponibile all’uscita dell’ALU alla fine del terzo ciclo; un multiplexer lo porta direttamente all’ingresso dell’ALU per l’istruzione successiva, scavalcando il banco dei registri. Risolve la maggior parte dei casi senza perdere cicli.
- Caricamento seguito da uso: con
lw x5, 0(x6)seguito da un’istruzione che usa x5, il dato arriva solo alla fine dello stadio MEM, troppo tardi per l’EX dell’istruzione successiva. Serve uno stallo di un ciclo (una “bolla” nella pipeline). Spesso il compilatore riordina le istruzioni per riempire quel posto con un’istruzione indipendente.
Conflitti sul controllo
Un salto condizionato si risolve solo nello stadio EX: nel frattempo la pipeline ha già prelevato le istruzioni successive, che potrebbero essere sbagliate. Se il salto viene preso, vanno scartate, e si perdono due cicli.
La soluzione è la predizione dei salti: il processore indovina se il salto verrà preso e preleva di conseguenza; se sbaglia, scarta il lavoro fatto. I predittori moderni ricordano il comportamento passato di ogni salto e indovinano oltre il 95% delle volte: un ciclo for salta all’indietro sempre, tranne all’ultima iterazione.
Esempio. In un programma il 20% delle istruzioni sono caricamenti, metà dei quali seguiti subito da un uso (1 ciclo di stallo); il 15% sono salti, predetti male nel 10% dei casi (2 cicli persi). Il CPI medio è
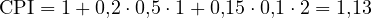
vicino al valore ideale 1.
Oltre la pipeline semplice
- Pipeline più profonde: più stadi più corti permettono frequenze più alte, ma aumentano il costo degli errori di predizione. I processori attuali hanno 10-20 stadi.
- Superscalari: più pipeline in parallelo, che avviano due, quattro o più istruzioni per ciclo (CPI minore di 1).
- Esecuzione fuori ordine: il processore guarda avanti decine di istruzioni ed esegue per prime quelle i cui operandi sono pronti, mentre le altre aspettano un dato dalla memoria; i risultati vengono poi resi visibili nell’ordine originale.
Tutto questo è invisibile al programmatore: il programma si comporta come se le istruzioni fossero eseguite una alla volta, nell’ordine scritto.