Transazioni: ACID, serializzabilità e bloccaggio a due fasi
Proprietà ACID, anomalie della concorrenza, grafo dei conflitti con dimostrazione, bloccaggio a due fasi dimostrato, stallo, livelli di isolamento e MVCC, registro e ripristino dopo un guasto.
Un bonifico toglie denaro da un conto e lo aggiunge a un altro: se il sistema si ferma a metà, o se due bonifici sullo stesso conto si intrecciano, il denaro può sparire o moltiplicarsi. Le transazioni sono il meccanismo con cui un DBMS garantisce che questo non accada, anche con migliaia di utenti contemporanei e con i guasti. In questa lezione vediamo le proprietà ACID, le anomalie della concorrenza, la serializzabilità e il grafo dei conflitti con la dimostrazione del teorema fondamentale, il bloccaggio a due fasi con la dimostrazione che garantisce la serializzabilità, lo stallo, i livelli di isolamento e il ripristino dopo un guasto.
Le proprietà ACID
Una transazione è una sequenza di operazioni trattata come un’unità, che termina con un COMMIT (conferma) o un ROLLBACK (annullamento). Deve garantire:
- atomicità: o tutte le operazioni hanno effetto, o nessuna;
- consistenza: partendo da uno stato che rispetta i vincoli, si arriva a uno stato che li rispetta;
- isolamento: ogni transazione si comporta come se fosse sola, senza vedere i risultati parziali delle altre;
- durabilità: una volta confermata, la transazione sopravvive a qualsiasi guasto successivo.
Le anomalie della concorrenza
Eseguire le transazioni una alla volta sarebbe corretto ma troppo lento. Intrecciandole liberamente nascono le anomalie:
- aggiornamento perso: due transazioni leggono lo stesso saldo di 100, ciascuna aggiunge 10 e scrive 110: il risultato dovrebbe essere 120;
- lettura sporca: una transazione legge un dato scritto da un’altra che poi viene annullata, cioè un valore mai esistito;
- lettura non ripetibile: leggendo due volte lo stesso dato si ottengono valori diversi, perché un’altra transazione l’ha modificato in mezzo;
- fantasmi: rieseguendo una query compaiono righe nuove inserite da altri.
La serializzabilità
Uno schedule è un intreccio delle operazioni di più transazioni. È seriale se le transazioni sono eseguite una dopo l’altra, ed è serializzabile se produce lo stesso effetto di uno schedule seriale. Due operazioni di transazioni diverse sono in conflitto se riguardano lo stesso dato e almeno una è una scrittura: il loro ordine conta. Uno schedule è serializzabile per conflitti se si può trasformare in uno seriale scambiando operazioni adiacenti non in conflitto.
Il grafo dei conflitti ha un nodo per ogni transazione e un arco  se un’operazione di
 precede un’operazione in conflitto di
 .
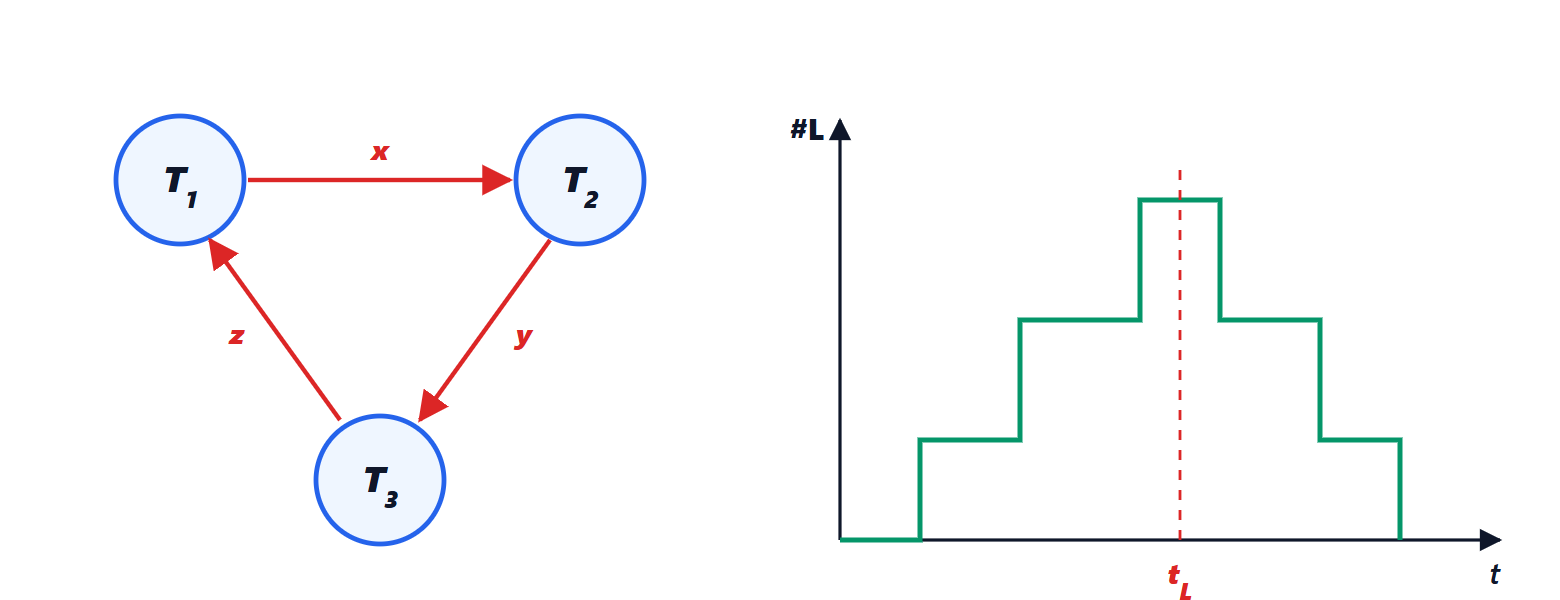
Teorema. Uno schedule è serializzabile per conflitti se e solo se il suo grafo dei conflitti è aciclico.
Dimostrazione. *Se c’è un ciclo* 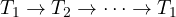 , in qualsiasi schedule seriale equivalente (che deve conservare l’ordine di ogni coppia di operazioni in conflitto)
 dovrebbe precedere
 , precedere
 , e così via fino a che precede sé stessa: impossibile. *Se il grafo è aciclico*, ammette un ordinamento topologico: un ordine delle transazioni in cui ogni arco va da una transazione a una successiva. Lo schedule seriale in quell’ordine conserva l’ordine di tutte le coppie in conflitto, perché ogni conflitto è un arco e gli archi rispettano l’ordine; le operazioni non in conflitto si possono riordinare liberamente. Quindi lo schedule è equivalente a quello seriale. ∎
Il bloccaggio a due fasi
I DBMS non costruiscono il grafo a posteriori: usano un protocollo che garantisce la serializzabilità per costruzione. Ogni transazione deve ottenere un blocco su un dato prima di usarlo: condiviso per leggere (più transazioni possono leggere insieme), esclusivo per scrivere. Il protocollo di bloccaggio a due fasi (2PL) impone che ogni transazione acquisisca tutti i blocchi di cui ha bisogno prima di rilasciarne qualcuno: c’è una fase di crescita e una di rilascio, separate dal punto di blocco.
Teorema. Ogni schedule prodotto da transazioni che rispettano il bloccaggio a due fasi è serializzabile per conflitti.
Dimostrazione. Se nel grafo c’è un arco , esiste un dato  su cui un’operazione di precede un’operazione in conflitto di . Le due operazioni richiedono blocchi incompatibili su , quindi ha ottenuto il blocco dopo che l’ha rilasciato. rilascia solo dopo il proprio punto di blocco, e acquisisce solo prima del proprio: quindi il punto di blocco di precede quello di . Un ciclo nel grafo richiederebbe che il punto di blocco di preceda sé stesso. Il grafo è aciclico, e per il teorema precedente lo schedule è serializzabile. ∎
Nella versione stretta, usata in pratica, i blocchi esclusivi si tengono fino al COMMIT: così nessuno legge dati di transazioni che potrebbero essere annullate, ed è evitata la lettura sporca.
Lo stallo
Con i blocchi può accadere che aspetti un dato bloccato da e un dato bloccato da : uno stallo (deadlock). Il DBMS lo rileva cercando cicli nel grafo delle attese e lo risolve annullando una delle transazioni, che l’applicazione dovrà ripetere. Per questo un’applicazione ben scritta riprova le transazioni annullate per stallo, e accede ai dati sempre nello stesso ordine per renderli rari.
I livelli di isolamento
La serializzabilità ha un costo in attese. SQL prevede quattro livelli di isolamento, che permettono via via meno anomalie: *read uncommitted*, *read committed* (il predefinito in molti sistemi, che evita le letture sporche), *repeatable read* e *serializable*. Molti DBMS moderni usano il controllo multiversione (MVCC): le scritture creano nuove versioni dei dati, e ogni transazione legge un’istantanea coerente presa all’inizio, così le letture non bloccano mai le scritture e viceversa.
Il ripristino
Per atomicità e durabilità il DBMS scrive ogni modifica in un registro (log) su memoria stabile prima di applicarla ai dati (write-ahead logging): con il valore vecchio e quello nuovo. Dopo un guasto, al riavvio legge il registro: rifà (redo) le modifiche delle transazioni confermate che potrebbero non essere arrivate ai dati, e disfa (undo) quelle delle transazioni non confermate. Periodicamente scrive un punto di controllo (checkpoint) per non dover rileggere il registro dall’inizio. Il COMMIT di una transazione è completo quando il suo record è sul registro, anche se i dati veri e propri sono ancora in memoria: è ciò che rende possibile una conferma veloce e sicura.