Pipeline : étages, aléas, anticipation et prédiction de branchement
Les cinq étages, accélération avec démonstration, aléas de données et anticipation (forwarding), blocage chargement-utilisation, aléas de contrôle et prédiction, CPI avec un exemple, processeurs superscalaires.
https://www.electronics-engineering.com/fr/pipeline-aleas-anticipation-prediction-de-branchement/
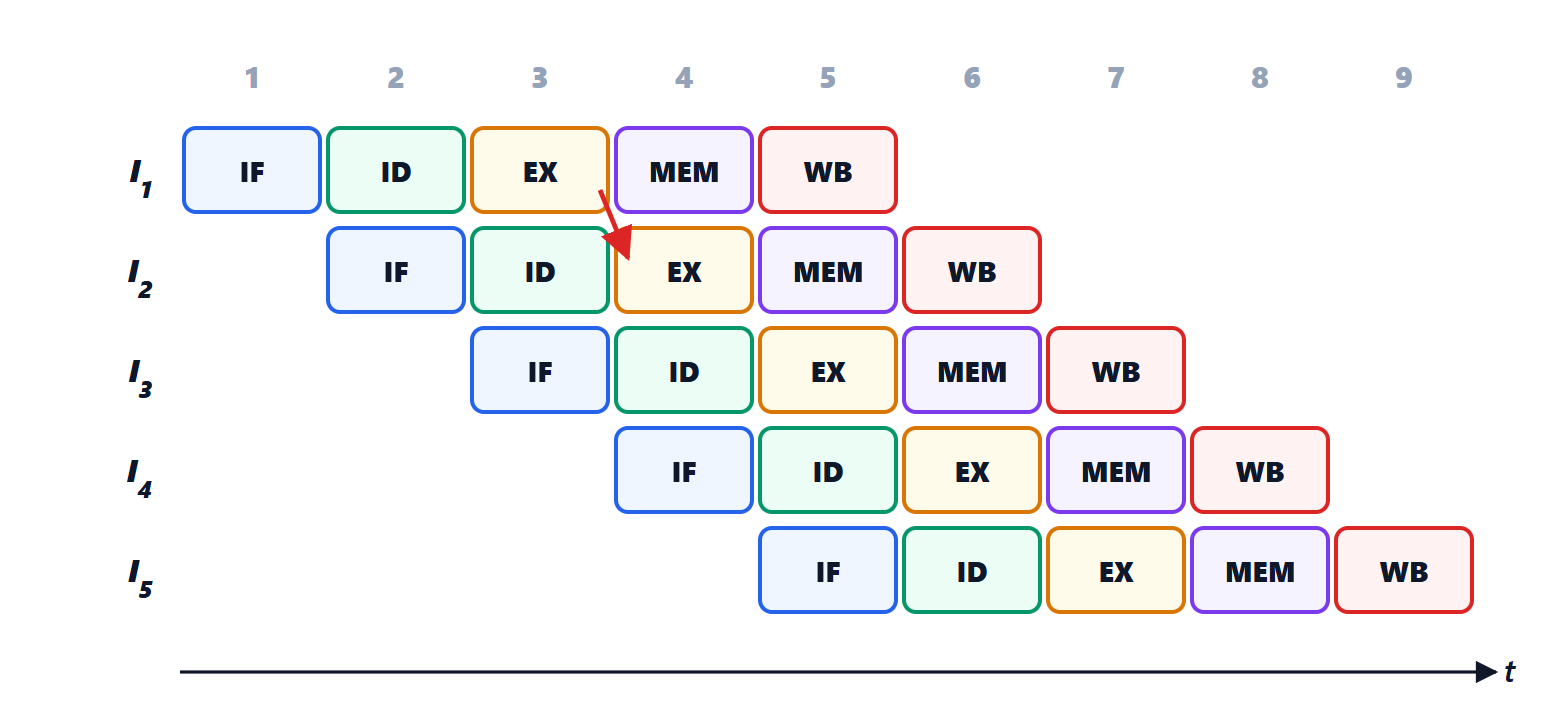
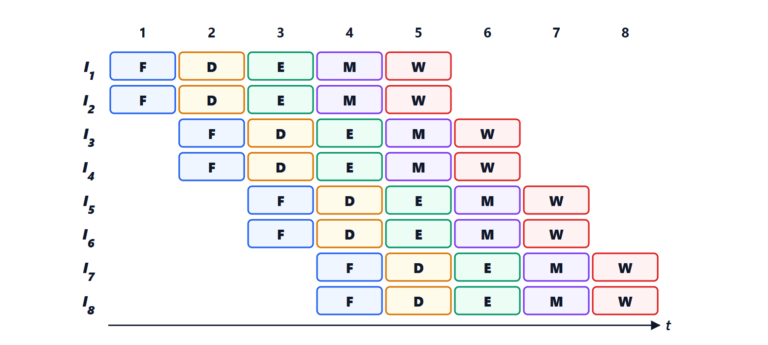
Dans une laverie avec un lave-linge, un sèche-linge et un fer à repasser, on n’attend pas que la première charge soit repassée pour mettre la seconde dans le lave-linge : pendant que la première sèche, la seconde se lave. Chaque charge prend le même temps, mais il en sort une à chaque étape au lieu d’une toutes les trois. C’est l’idée du pipeline : le chemin de données est divisé en étages, et chaque étage travaille sur une instruction différente. Dans cette leçon, nous regardons le pipeline classique à cinq étages, ce qu’il fait gagner et les aléas qui le ralentissent.
Les cinq étages
- IF (lecture) : lit l’instruction et calcule PC + 4 ;
- ID (décodage) : décode et lit les registres ;
- EX (exécution) : l’ALU calcule le résultat ou l’adresse ;
- MEM (mémoire) : lit ou écrit la mémoire de données ;
- WB (écriture) : écrit le résultat dans le banc de registres.
Entre un étage et le suivant, il y a des registres de pipeline, qui conservent les résultats intermédiaires et les transmettent à l’étage suivant sur le front d’horloge.
Le gain
La période d’horloge est maintenant celle de l’étage le plus lent (environ 200 ps dans l’exemple de la leçon précédente, au lieu de 700).
Théorème. Avec  étages de durée égale,
 instructions prennent
 cycles, et l’accélération par rapport à l’exécution sans pipeline est
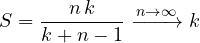
Démonstration. La première instruction sort après cycles ; à partir de là, une sort à chaque cycle, donc les  autres prennent cycles de plus. Sans pipeline, chaque instruction prend cycles de la même période, soit
 au total. ∎
Avec 5 étages et un million d’instructions, l’accélération est pratiquement de 5. Le pipeline ne rend pas une instruction isolée plus rapide (il la ralentit même légèrement à cause des registres supplémentaires), mais il augmente le nombre d’instructions terminées par unité de temps.
En pratique, les étages ne sont pas parfaitement équilibrés et, surtout, il y a des aléas (hazards), des situations dans lesquelles une instruction ne peut pas passer au cycle suivant.
Aléas de données
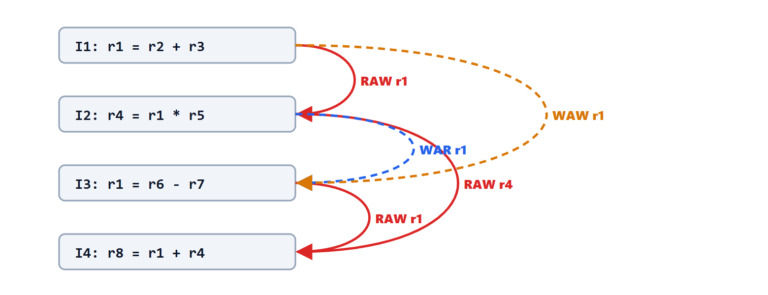
add  x5, x6, x7
sub  x8, x5, x9     # uses x5, which add has not written yet
add écrit x5 à l’étage WB, au cinquième cycle ; sub le lit à l’étage ID, au troisième. Sans contre-mesures, il lirait l’ancienne valeur.
- Anticipation (forwarding) : le résultat est déjà disponible à la sortie de l’ALU à la fin du troisième cycle ; un multiplexeur le porte directement à l’entrée de l’ALU pour l’instruction suivante, en contournant le banc de registres. Elle résout la plupart des cas sans perdre de cycles.
- Chargement suivi d’une utilisation : avec
lw x5, 0(x6)suivi d’une instruction qui utilise x5, la donnée n’arrive qu’à la fin de l’étage MEM, trop tard pour l’EX de l’instruction suivante. Il faut un blocage (stall) d’un cycle (une « bulle » dans le pipeline). Le compilateur réordonne souvent les instructions pour remplir cette place avec une instruction indépendante.
Aléas de contrôle
Un branchement conditionnel n’est résolu qu’à l’étage EX : entre-temps, le pipeline a déjà lu les instructions suivantes, qui peuvent être les mauvaises. Si le branchement est pris, elles doivent être jetées, et deux cycles sont perdus.
La solution est la prédiction de branchement : le processeur devine si le branchement sera pris et lit en conséquence ; s’il se trompe, il jette le travail fait. Les prédicteurs modernes mémorisent le comportement passé de chaque branchement et devinent juste plus de 95 % du temps : une boucle for revient toujours en arrière, sauf à la dernière itération.
Exemple. Dans un programme, 20 % des instructions sont des chargements, dont la moitié est immédiatement suivie d’une utilisation (1 cycle de blocage) ; 15 % sont des branchements, mal prédits 10 % du temps (2 cycles perdus). Le CPI moyen est
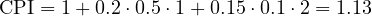
proche de la valeur idéale de 1.
Au-delà du pipeline simple
- Pipelines plus profonds : davantage d’étages, plus courts, permettent des fréquences plus élevées, mais augmentent le coût des mauvaises prédictions. Les processeurs actuels ont de 10 à 20 étages.
- Superscalaire : plusieurs pipelines en parallèle, qui lancent deux, quatre instructions ou plus par cycle (CPI inférieur à 1).
- Exécution dans le désordre : le processeur regarde en avance des dizaines d’instructions et exécute d’abord celles dont les opérandes sont prêts, pendant que les autres attendent des données de la mémoire ; les résultats sont ensuite rendus visibles dans l’ordre d’origine.
Tout cela est invisible pour le programmeur : le programme se comporte comme si les instructions étaient exécutées une à une, dans l’ordre écrit.

Benvenuti nella pagina su «La pipeline: stadi, conflitti, inoltro e predizione dei salti». L'ho scritta pensando a chi studia ingegneria elettronica: se un passaggio non vi torna, un esercizio vi dà un risultato diverso o volete altro materiale sull'argomento, chiedete pure nei commenti e vi risponderò. Un voto con le stelle qui sopra mi aiuta a capire quali pagine migliorare.Welcome to the page on “Pipelining: stages, hazards, forwarding and branch prediction”. I wrote it for engineering students: if a step does not add up, an exercise gives you a different result or you would like more material on the topic, just ask in the comments and I will reply. A star rating above helps me understand which pages to improve.