Exécution dans le désordre : Tomasulo, tampon de réordonnancement et spéculation
Émission, exécution et validation, stations de réservation et bus de données commun, tampon de réordonnancement et exceptions précises avec démonstration, exécution spéculative et Spectre, désambiguïsation de la mémoire.
https://www.electronics-engineering.com/fr/execution-dans-le-desordre-tomasulo-tampon-de-reordonnancement/
Un pipeline dans l’ordre s’arrête quand une instruction attend des données, et avec elle toutes les suivantes, même indépendantes. Un processeur dans le désordre laisse passer devant les instructions prêtes, et réordonne les résultats à la fin. C’est l’idée de l’algorithme de Tomasulo (IBM 360/91, 1967), qui, avec l’ajout du tampon de réordonnancement, est le cœur de tout processeur haute performance actuel. Dans cette leçon, nous regardons les stations de réservation, le bus de données commun, le tampon de réordonnancement avec la démonstration qu’il garantit des exceptions précises, l’exécution spéculative et la désambiguïsation de la mémoire.
L’idée
Un chargement qui manque le cache peut coûter des centaines de cycles. Dans un pipeline dans l’ordre, le processeur reste inactif pendant tout ce temps. Pourtant, derrière le chargement, il y a souvent des dizaines d’instructions qui n’ont rien à voir avec la donnée attendue. L’exécution dans le désordre sépare trois moments qui coïncident dans le pipeline simple :
- l’émission, dans l’ordre : l’instruction est décodée, ses registres renommés, et elle est mise en attente ;
- l’exécution, dans le désordre : elle démarre dès que ses opérandes sont disponibles ;
- la validation (commit), de nouveau dans l’ordre : le résultat devient définitif, visible pour l’architecture.
Stations de réservation et bus de données commun
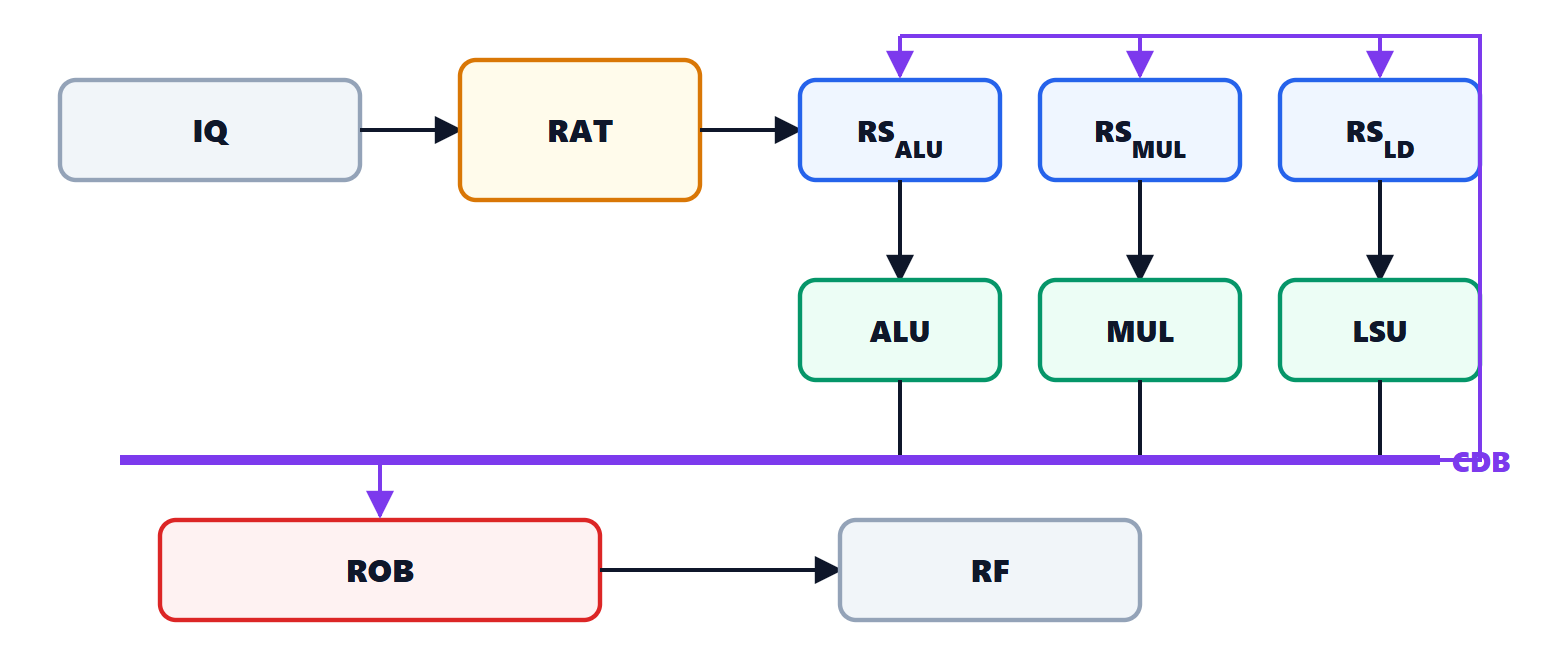
Chaque unité fonctionnelle a devant elle un groupe de stations de réservation : des registres qui contiennent une instruction en attente, avec ses opérandes. Pour chaque opérande, la station contient la valeur, si elle est déjà disponible, ou l’étiquette de l’instruction qui la produira. Les étiquettes sont en pratique les registres physiques de la leçon précédente : le renommage se fait ici, et les dépendances WAR et WAW disparaissent.
Quand une unité termine, elle met le résultat et son étiquette sur le bus de données commun (CDB). Toutes les stations qui attendent cette étiquette la capturent dans le même cycle ; une instruction dont tous les opérandes sont prêts est envoyée à son unité à la première occasion, sans égard pour l’ordre du programme. Les vraies dépendances sont respectées par construction, parce qu’aucune instruction ne démarre sans ses opérandes.
Le tampon de réordonnancement
Dans l’algorithme original, les résultats écrivaient directement dans les registres, dans le désordre. Cela crée un problème : si une instruction provoque une exception (une division par zéro, un défaut de page), certaines instructions suivantes pourraient avoir déjà modifié l’état, et le système d’exploitation ne saurait pas où reprendre. La solution est le tampon de réordonnancement (ROB) : une file circulaire où chaque instruction prend une place, dans l’ordre du programme, à l’émission. Les résultats s’écrivent dans le ROB ; une instruction est validée (commit), c’est-à-dire qu’elle écrit dans les registres architecturaux ou en mémoire, seulement quand elle est en tête de file et terminée.
Théorème. Avec une validation dans l’ordre depuis le ROB, les exceptions sont précises : quand l’exception de l’instruction  est traitée, l’état architectural contient les résultats de toutes les instructions qui précèdent et d’aucune de celles qui suivent.
Démonstration. L’état architectural (registres et mémoire) ne change qu’à la validation, et les instructions sont validées dans l’ordre du programme, l’une après l’autre depuis la tête du ROB. L’exception de est enregistrée dans sa place du ROB et traitée quand arrive en tête : à ce moment toutes les instructions précédentes ont été validées, parce qu’elles étaient devant dans la file, et aucune des suivantes ne l’a été, parce qu’elles sont derrière. Le processeur jette le contenu du ROB à partir de et saute au gestionnaire. ∎
L’exécution spéculative
Le même mécanisme permet d’exécuter des instructions avant de savoir si elles doivent l’être. Quand on rencontre un branchement conditionnel, le processeur prédit sa direction (leçon sur la prédiction) et continue d’émettre des instructions sur ce chemin. Si la prédiction était juste, ces instructions sont validées normalement ; si elle était fausse, quand le branchement arrive en tête du ROB, toutes les instructions suivantes sont jetées et l’exécution repart de la bonne adresse. Rien de ce qui a été fait par erreur n’a touché l’état architectural.
L’état micro-architectural, lui, a été touché : les instructions exécutées par erreur peuvent avoir chargé des données dans les caches. C’est le principe des attaques Spectre (2018), qui déduisent des données secrètes en mesurant les temps d’accès au cache après une exécution spéculative. Les contre-mesures (barrières, isolation, modifications des compilateurs) coûtent quelques pour cent de performance.
La mémoire
Les dépendances à travers la mémoire sont les plus délicates : un chargement peut lire l’adresse qu’une écriture précédente est sur le point d’écrire, mais l’adresse n’est connue qu’après avoir été calculée. Les écritures attendent la validation dans une file d’écritures ; un chargement compare son adresse à celles de la file et, s’il trouve une écriture à la même adresse, en prend directement la valeur (store-to-load forwarding). Les processeurs modernes osent plus : ils exécutent le chargement même avant de connaître les adresses des écritures précédentes, en prédisant qu’il n’y a pas de conflit, et s’ils se trompent, ils annulent et ré-exécutent.
Les tailles
Un processeur haute performance de 2025 a un ROB de 500-600 entrées, quelques centaines de registres physiques, une dizaine d’unités fonctionnelles et peut avoir des centaines d’instructions « en vol ». La grande fenêtre sert surtout à cacher la latence de la mémoire : pendant qu’un chargement attend la DRAM, le processeur trouve du travail utile plusieurs instructions plus loin.



Benvenuti nella pagina su «Esecuzione fuori ordine: Tomasulo, buffer di riordino e speculazione». L'ho scritta pensando a chi studia ingegneria elettronica: se un passaggio non vi torna, un esercizio vi dà un risultato diverso o volete altro materiale sull'argomento, chiedete pure nei commenti e vi risponderò. Un voto con le stelle qui sopra mi aiuta a capire quali pagine migliorare.Welcome to the page on “Out-of-order execution: Tomasulo, the reorder buffer and speculation”. I wrote it for engineering students: if a step does not add up, an exercise gives you a different result or you would like more material on the topic, just ask in the comments and I will reply. A star rating above helps me understand which pages to improve.