SIMD, GPU et modèle roofline
Extensions vectorielles des processeurs, modèle SIMT des GPU, divergence et accès coalescés, intensité arithmétique, modèle roofline avec démonstration, exemples du produit scalaire et du produit matriciel.
https://www.electronics-engineering.com/fr/simd-gpu-simt-modele-roofline/
De nombreux programmes passent presque tout leur temps à répéter la même opération sur de grandes quantités de données : filtrer des images, multiplier des matrices, entraîner des réseaux de neurones, simuler la physique. Pour ce type de travail, une architecture différente est avantageuse : une seule instruction qui agit sur beaucoup de données à la fois. Dans cette leçon, nous regardons les extensions vectorielles SIMD des processeurs, le modèle d’exécution des GPU avec ses contraintes, et le modèle roofline, qui, avec une démonstration de deux lignes, dit si un programme est limité par le calcul ou par la mémoire.
Le SIMD dans les processeurs
Dans la classification de Flynn, SIMD (single instruction, multiple data) désigne une seule instruction appliquée à plusieurs données. Les processeurs modernes ont des registres vectoriels de 128, 256 ou 512 bits : un registre de 256 bits contient huit nombres à virgule flottante de 32 bits, et une seule instruction les additionne deux à deux à ceux d’un autre registre. Les familles principales sont SSE et AVX sur x86, NEON et SVE sur ARM, l’extension V sur RISC-V.
SVE et RISC-V V sont indépendants de la longueur vectorielle : le programme demande au processeur combien d’éléments il peut traiter à la fois et s’adapte, si bien que le même code tourne sur des processeurs aux registres de longueurs différentes. Les compilateurs vectorisent automatiquement les boucles simples, à condition qu’il n’y ait pas de dépendances entre itérations et que les données soient contiguës en mémoire.
Le modèle des GPU
Un GPU pousse l’idée à l’extrême. Il contient des dizaines de multiprocesseurs de flux (SM), chacun avec des dizaines d’unités de calcul simples, des milliers en tout. Le programmeur écrit une fonction (le kernel) pour un seul élément et la lance sur des millions d’éléments ; le matériel regroupe les threads par ensembles de 32 (warps) qui exécutent la même instruction au même moment, chacun sur ses propres données. C’est le modèle SIMT (single instruction, multiple threads).
Deux règles décident des performances :
- la divergence : si, dans un warp, certains threads prennent une branche d’un
ifet d’autres l’autre, les deux branches sont exécutées l’une après l’autre, avec la moitié des threads inactifs. Le code pour GPU doit éviter les branches qui dépendent des données de l’élément ; - les accès coalescés : si les 32 threads d’un warp lisent 32 adresses consécutives, la mémoire les sert par un seul transfert large ; s’ils lisent des adresses dispersées, il faut 32 transferts.
Les GPU ne cachent pas la latence de la mémoire avec d’énormes caches et l’exécution dans le désordre, mais avec le nombre : chaque SM garde en vie des dizaines de warps et, quand l’un attend la mémoire, passe à un autre en un cycle. Il faut donc beaucoup de parallélisme, des dizaines de milliers de threads actifs.
Le modèle roofline
À quelle vitesse un programme peut-il tourner sur une machine donnée ? Deux limites comptent : la performance de calcul de crête  (opérations par seconde) et la bande passante mémoire
 (octets par seconde). Le lien entre les deux est donné par l’intensité arithmétique du programme, le rapport entre les opérations effectuées et les octets transférés depuis la mémoire :
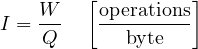
Théorème (roofline). La performance atteignable est bornée par
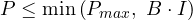
Démonstration. Le programme effectue  opérations et transfère
 octets en un temps
 . Les opérations ne peuvent pas s’exécuter plus vite que la crête, donc
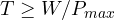 ; les octets ne peuvent pas être transférés plus vite que la bande passante, donc
 . La performance est
 , et des deux inégalités on tire
 et
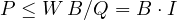 . ∎
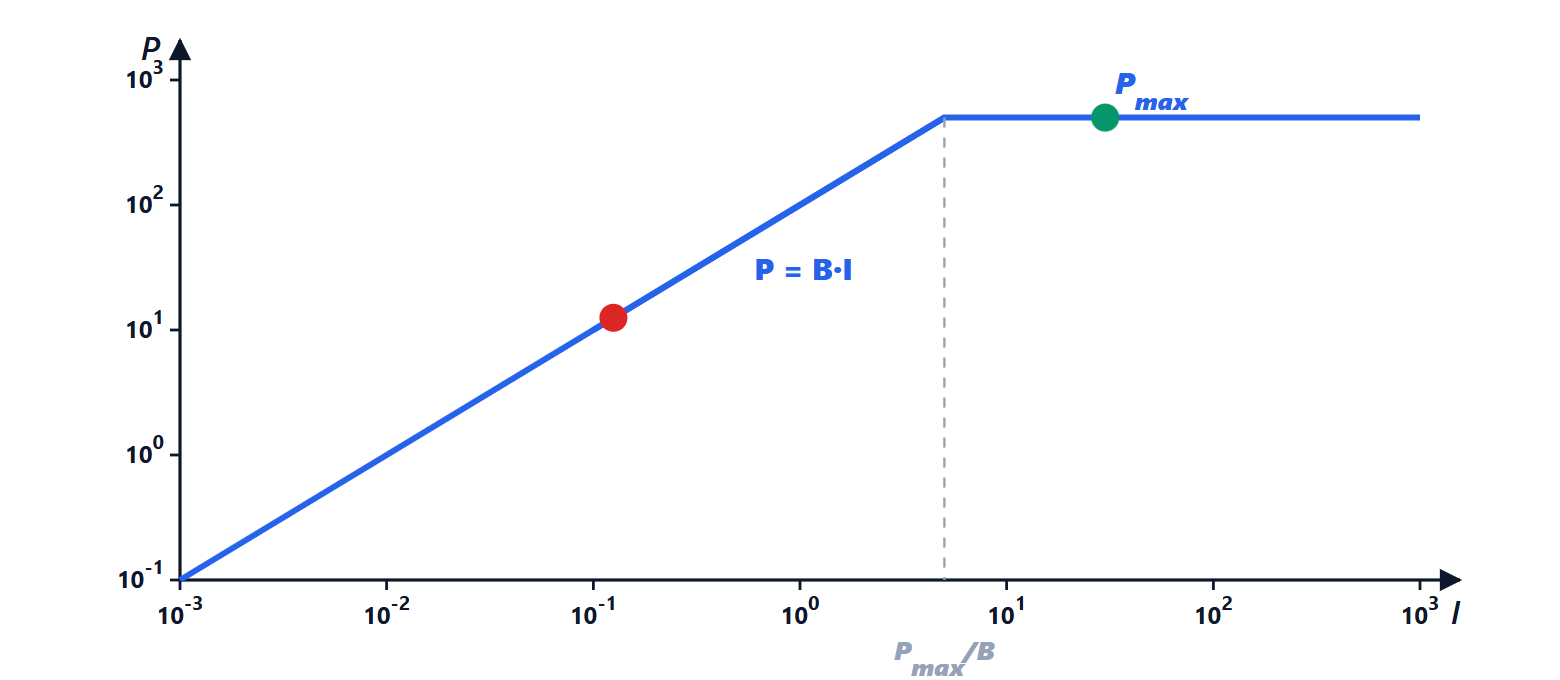
En échelle logarithmique, le graphique a la forme d’un toit : une pente à gauche et un sommet plat à droite, qui se rejoignent au point de crête 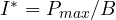 . Un programme d’intensité inférieure à
 est limité par la mémoire : améliorer le calcul ne sert à rien, il faut réduire les transferts. Un programme d’intensité supérieure est limité par le calcul.
Exemples. Une machine avec 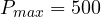 GFLOP/s et
 Go/s a son point de crête à 5 opérations par octet.
- Le produit scalaire de deux vecteurs de 64 bits effectue 2 opérations (une multiplication et une addition) tous les 16 octets lus :
 . La performance ne peut pas dépasser
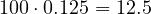 GFLOP/s, soit 2,5 % de la crête, quelle que soit l’optimisation du code.
- Le produit matriciel par blocs (leçon sur les caches) effectue
 opérations en transférant environ
 nombres : l’intensité croît avec le côté du bloc
 , et avec des blocs assez grands le programme devient limité par le calcul. C’est pourquoi la multiplication de matrices est l’opération sur laquelle les GPU et les accélérateurs d’IA atteignent les performances annoncées.
Le modèle s’étend à plusieurs toits (avec et sans unités vectorielles, avec les données en cache ou en DRAM) et guide l’optimisation : d’abord mesurer où se situe le programme, puis décider s’il faut travailler sur la localité des données ou sur le calcul.



Ciao, sono l'autore di «SIMD, GPU e il modello roofline». Domande, dubbi, segnalazioni di errori o richieste di approfondimento sono benvenuti: scriveteli qui sotto e vi rispondo io. Potete anche votare la pagina con le stelle all'inizio dell'articolo.Hi, I am the author of “SIMD, GPUs and the roofline model”. Questions, doubts, error reports and requests for more detail are all welcome: write them below and I will answer. You can also rate the page with the stars at the top of the article.