Processeurs superscalaires, VLIW et multithreading simultané
Émission multiple et IPC, coût quadratique du contrôle avec démonstration, architectures VLIW et leurs limites, multithreading simultané, murs de l'ILP, de la mémoire et de la puissance, virage vers le multicœur.
https://www.electronics-engineering.com/fr/superscalaire-vliw-multithreading-simultane/
Un pipeline parfait termine une instruction par cycle. Pour faire mieux, il faut chercher, décoder et exécuter plusieurs instructions par cycle : c’est le processeur superscalaire. Sinon, le parallélisme peut être décidé par le compilateur et écrit explicitement dans les instructions : c’est l’approche VLIW. Ou encore, on peut remplir les emplacements vides avec des instructions d’un autre programme : le multithreading simultané. Dans cette leçon, nous regardons les trois voies, nous démontrons pourquoi la complexité du contrôle croît avec le carré de la largeur, et nous voyons les limites qui ont poussé l’industrie vers le multicœur.
Le processeur superscalaire
Un processeur superscalaire à  voies cherche et décode jusqu’à instructions par cycle, les renomme et les envoie aux unités fonctionnelles, dont il y a plus d’une par type. Dans le cas idéal, il termine instructions par cycle : le CPI tombe à
 , et l’on préfère parler de son inverse, l’IPC (instructions par cycle).
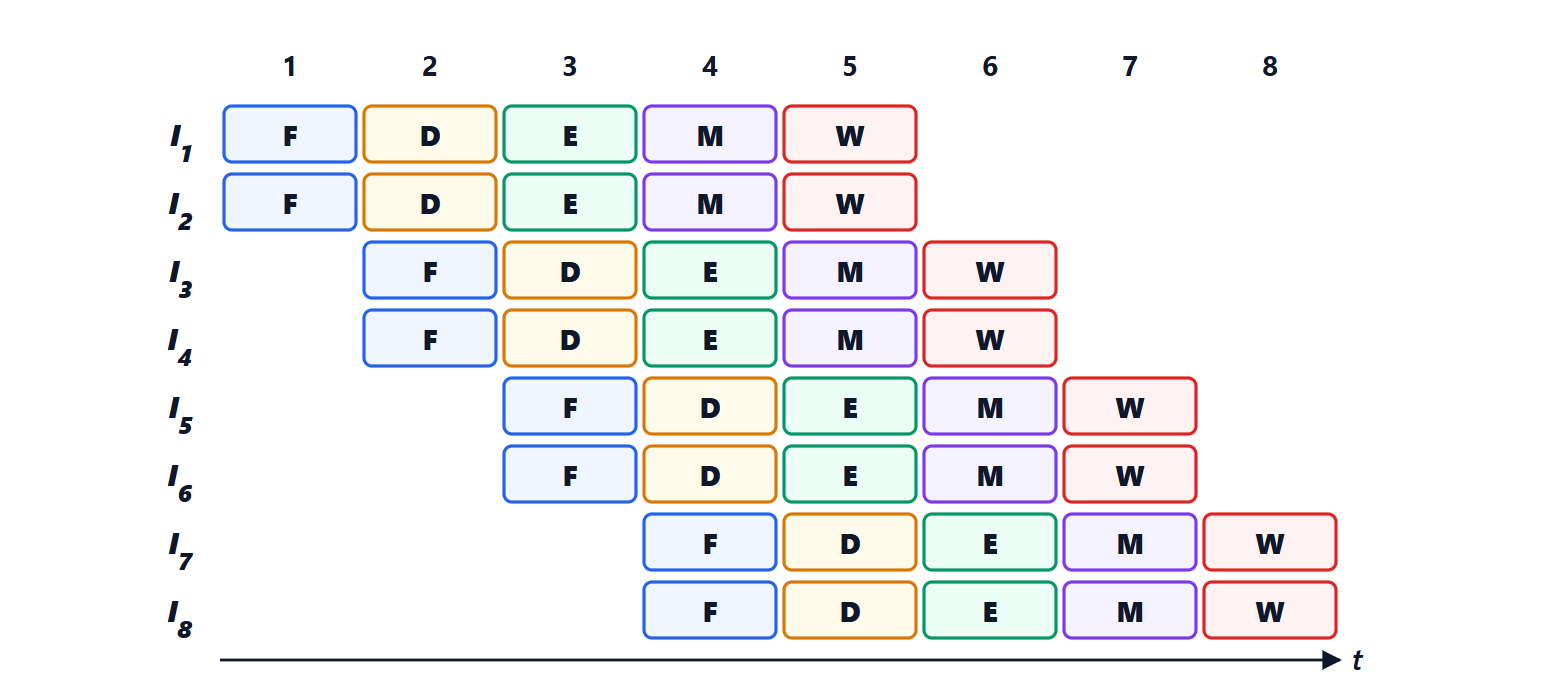
L’IPC réel est bien inférieur à : les vraies dépendances, les branchements mal prédits et surtout les attentes de la mémoire laissent beaucoup d’emplacements vides. Un processeur à 6-8 voies atteint typiquement un IPC entre 2 et 4 sur des programmes courants.
Le coût du contrôle
Émettre plusieurs instructions ensemble exige de vérifier, dans le même cycle, les dépendances entre les instructions du groupe : si la deuxième lit un registre écrit par la première, elle doit recevoir le nouveau registre physique attribué à la première, non l’ancien de la table de renommage.
Théorème. Renommer en un cycle un groupe de instructions à deux opérandes source chacune exige  comparaisons de registres.
Démonstration. L’instruction en position  du groupe (de 1 à ) doit comparer chacun de ses deux registres source avec le registre destination de chacune des
 instructions qui la précèdent dans le groupe. Le total est
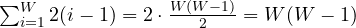 . ∎
Le nombre de comparaisons croît avec le carré de la largeur, de même que les ports de lecture et d’écriture du fichier de registres, les chemins de propagation entre unités et la logique qui choisit quelles instructions prêtes envoyer. La puissance et la difficulté de respecter le cycle d’horloge croissent plus que linéairement, alors que l’IPC croît moins que linéairement. C’est pourquoi les largeurs se sont arrêtées entre 4 et 10.
VLIW : laisser le travail au compilateur
Dans l’architecture VLIW (very long instruction word), chaque instruction est un paquet d’opérations que le compilateur garantit indépendantes, une pour chaque unité fonctionnelle. Le processeur ne vérifie rien : il exécute les paquets tels quels, avec un matériel simple et peu gourmand. Le compilateur doit trouver le parallélisme par le déroulage de boucles et l’ordonnancement des instructions (leçon sur les dépendances), en remplissant de no-op les emplacements qu’il ne peut pas utiliser.
Le VLIW a eu beaucoup de succès dans les DSP et les accélérateurs, où le code est fait de boucles régulières et prévisibles. Dans les processeurs généralistes, en revanche, il s’est heurté à deux problèmes : le compilateur ne connaît pas les latences de la mémoire, qui changent à chaque exécution, et le code compilé pour une génération n’exploite pas la suivante, qui a des unités différentes. L’exemple le plus connu est l’Itanium d’Intel et HP, abandonné en 2021.
Le multithreading simultané
Même le meilleur superscalaire laisse vides beaucoup de ses emplacements à chaque cycle, parce qu’un seul programme n’a pas assez d’instructions indépendantes. Le multithreading simultané (SMT, commercialisé par Intel sous le nom d’Hyper-Threading) fait paraître un cœur comme deux (ou plus) processeurs : il a deux copies de l’état architectural (registres, compteur de programme) et cherche des instructions dans les deux threads, en les mélangeant dans la même fenêtre d’exécution dans le désordre. Les instructions des deux threads n’ont pas de dépendances entre elles et remplissent les emplacements laissés libres par l’autre, surtout quand l’un des deux attend la mémoire.
Le gain typique est de 15-30 % de débit global pour quelques pour cent de surface en plus. Le prix est que les deux threads se disputent les caches, les prédicteurs et les unités : chacun va plus lentement que seul, et un thread peut espionner l’autre en mesurant les temps, c’est pourquoi certains systèmes le désactivent par sécurité.
Les limites et le virage vers le multicœur
Jusqu’au début des années 2000, les performances des processeurs croissaient d’environ 50 % par an grâce à des fréquences plus élevées et à plus d’ILP. Puis elles ont buté sur trois murs :
- le mur de l’ILP : au-delà d’une certaine largeur, l’IPC ne croît plus ;
- le mur de la mémoire : la DRAM est restée lente, des centaines de cycles par accès ;
- le mur de la puissance : augmenter la fréquence exige d’augmenter la tension, et la puissance croît à peu près comme le cube de la fréquence (leçon sur l’énergie).
La réponse de l’industrie a été de mettre plusieurs cœurs sur la même puce : au lieu d’un cœur toujours plus grand et plus chaud, plusieurs cœurs de taille raisonnable. Mais le parallélisme doit devenir explicite, écrit par le programmeur avec des threads, et la mémoire partagée apporte les problèmes de cohérence et de consistance de la leçon qui leur est consacrée.




Ciao, sono l'autore di «Processori superscalari, VLIW e multithreading simultaneo». Domande, dubbi, segnalazioni di errori o richieste di approfondimento sono benvenuti: scriveteli qui sotto e vi rispondo io. Potete anche votare la pagina con le stelle all'inizio dell'articolo.Hi, I am the author of “Superscalar processors, VLIW and simultaneous multithreading”. Questions, doubts, error reports and requests for more detail are all welcome: write them below and I will answer. You can also rate the page with the stars at the top of the article.