Parallélisme au niveau des instructions : dépendances et renommage des registres
Dépendances vraies, anti et de sortie, renommage des registres avec démonstration, équation des performances avec arrêts, déroulage de boucles, limites de l'ILP.
https://www.electronics-engineering.com/fr/parallelisme-instructions-dependances-renommage-registres/
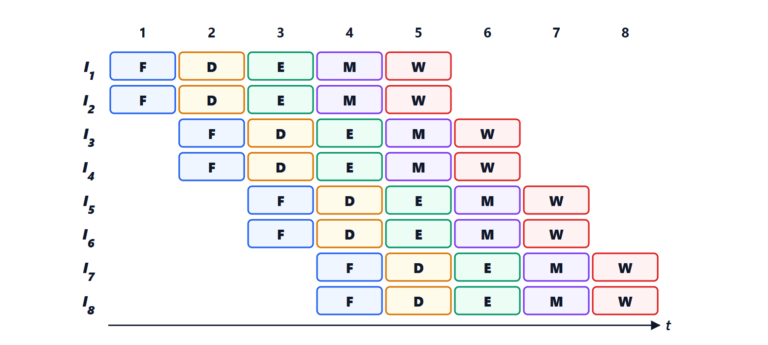
Le cours de Systèmes d’élaboration a montré le pipeline à cinq étages, qui recouvre l’exécution d’instructions successives. Mais un pipeline simple atteint au plus une instruction par cycle, et s’arrête chaque fois qu’une instruction attend le résultat d’une autre. Pour aller plus loin, il faut comprendre quelles instructions peuvent vraiment être exécutées ensemble. Dans cette leçon, nous classons les dépendances, nous démontrons que seules les vraies limitent le parallélisme alors que les autres sont éliminées par le renommage des registres, nous écrivons l’équation des performances avec arrêts et nous regardons le déroulage de boucles.
Le parallélisme au niveau des instructions
Le parallélisme au niveau des instructions (ILP) est la possibilité d’exécuter en même temps plusieurs instructions d’un même programme séquentiel. Le programmeur écrit une suite ; le processeur doit garantir que le résultat est le même que celui d’une exécution une instruction à la fois, mais il est libre de changer l’ordre et de recouvrir tout ce qui ne change pas le résultat.
Les dépendances
Entre deux instructions,  précédant
 dans le programme, il y a trois types de dépendance de registres :
- la dépendance vraie ou de données (RAW, read after write) : lit un registre écrit par . La valeur doit passer de l’une à l’autre : ne peut pas calculer avant que ait produit son résultat ;
- l’anti-dépendance (WAR, write after read) : écrit un registre que lit. Si écrivait la première, lirait la mauvaise valeur ;
- la dépendance de sortie (WAW, write after write) : les deux écrivent le même registre. À la fin, la valeur de doit rester.
S’y ajoutent les dépendances de contrôle, sur les branchements conditionnels, et les dépendances à travers la mémoire, plus difficiles à voir parce que les adresses ne sont connues que pendant l’exécution.
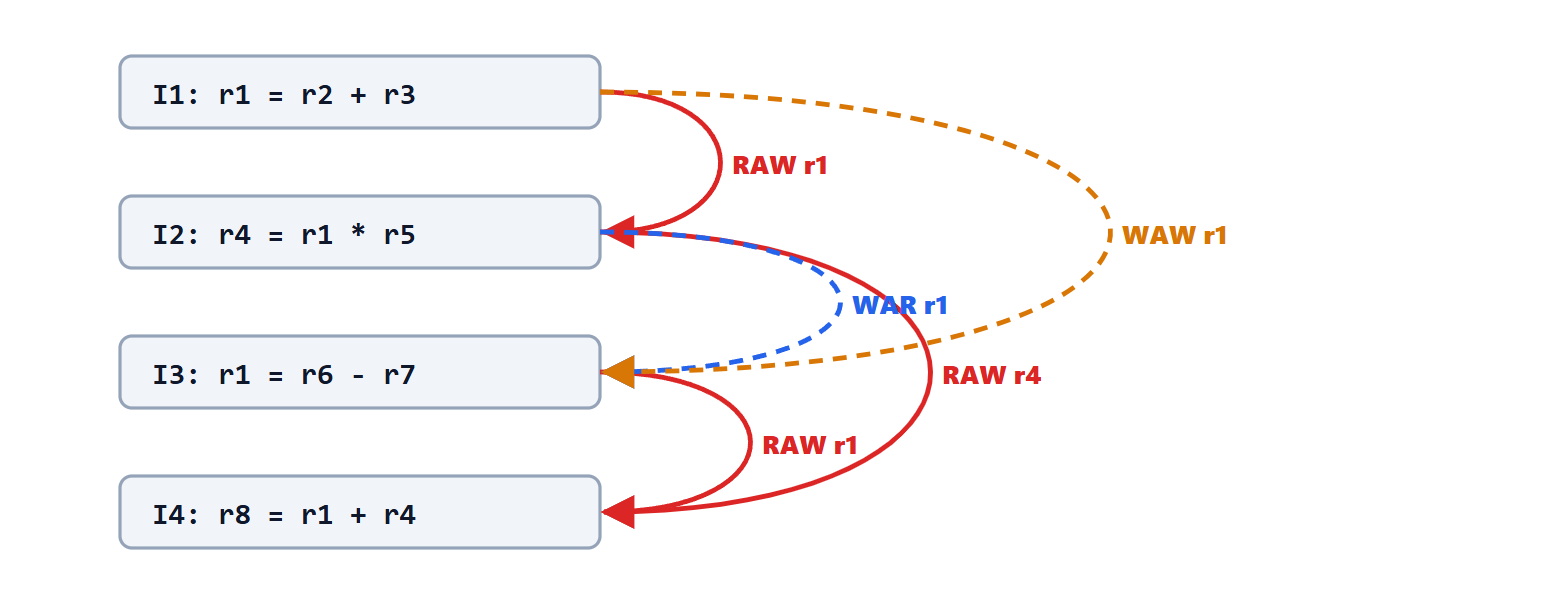
Dépendances vraies et dépendances de nom
Les anti-dépendances et les dépendances de sortie ne transportent aucune donnée : elles existent seulement parce que deux valeurs différentes utilisent le même nom de registre. Dans l’exemple de la figure,  réutilise
 pour une valeur qui n’a rien à voir avec celle de
 .
Théorème. Si chaque instruction écrit son résultat dans un nouveau registre physique, jamais utilisé auparavant, et si chaque lecture se réfère au registre physique de la dernière écriture précédente dans le programme, les dépendances WAR et WAW disparaissent et il ne reste que les RAW.
Démonstration. Une WAW demande deux écritures dans le même registre : avec un nouveau registre physique pour chaque écriture, il n’y en a aucune. Une WAR demande que écrive un registre que lit ; mais lit le registre physique de l’écriture qui précède , tandis que écrit un nouveau registre, différent de tous les existants, donc différent de celui qui est lu. Enfin, chaque lecture trouve la valeur de l’écriture qui la précède dans le programme, c’est-à-dire la même valeur que dans l’exécution séquentielle : le résultat ne change pas. ∎
C’est le renommage des registres. Le processeur a beaucoup plus de registres physiques (des centaines) que de registres architecturaux visibles pour le programmeur (32 en RISC-V), et une table d’alias des registres (RAT) qui dit, pour chaque registre architectural, quel registre physique contient la valeur la plus récente. Dans l’exemple, après renommage, et sont indépendantes et peuvent être exécutées ensemble : il ne reste que les flèches rouges.
L’équation des performances avec arrêts
Le temps d’exécution est 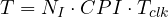 (leçon sur von Neumann et les performances). Dans un pipeline, le CPI idéal est 1, et chaque arrêt l’augmente :
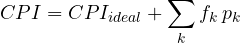
où  est la fréquence (par instruction) d’un certain type d’aléa et
 le nombre de cycles perdus chaque fois. Par exemple, si 25 % des instructions sont des chargements depuis la mémoire et que la moitié d’entre eux sont immédiatement suivis d’une instruction qui utilise la donnée, avec un cycle perdu chaque fois, la contribution est
 : le CPI passe de 1 à 1,125, et le processeur est 12,5 % plus lent.
Le déroulage de boucles
Le compilateur peut augmenter l’ILP disponible. Considérons une boucle qui ajoute une constante à chaque élément d’un tableau : chaque itération charge, additionne, écrit, incrémente l’indice et branche. Les trois instructions utiles dépendent les unes des autres, et il reste entre elles des cycles vides, à attendre des résultats.
En déroulant la boucle quatre fois, c’est-à-dire en écrivant quatre itérations dans le corps avec des registres différents, on obtient quatre chaînes indépendantes. Le compilateur les entrelace : pendant que la première addition attend son chargement, on exécute les chargements des trois autres. Les cycles vides disparaissent, et l’incrément de l’indice et le branchement, exécutés une fois tous les quatre éléments au lieu de chaque élément, pèsent quatre fois moins. Le prix est un code plus long et plus de registres utilisés. Les compilateurs le font automatiquement avec les options d’optimisation, et la même idée est à la base de la vectorisation (leçon sur le SIMD et les GPU).
Combien d’ILP y a-t-il vraiment
Les études sur des processeurs idéaux, à unités infinies et prédiction parfaite, trouvent des dizaines d’instructions exécutables en parallèle dans les programmes courants. Les processeurs réels, limités par la prédiction, les fenêtres et la mémoire, en exploitent de 2 à 5 par cycle. Les leçons suivantes montrent les techniques qui s’en approchent : l’exécution dans le désordre, la prédiction des branchements, les processeurs superscalaires.




Ciao, sono l'autore di «Parallelismo a livello di istruzione: dipendenze e rinominazione dei registri». Domande, dubbi, segnalazioni di errori o richieste di approfondimento sono benvenuti: scriveteli qui sotto e vi rispondo io. Potete anche votare la pagina con le stelle all'inizio dell'articolo.Hi, I am the author of “Instruction-level parallelism: dependences and register renaming”. Questions, doubts, error reports and requests for more detail are all welcome: write them below and I will answer. You can also rate the page with the stars at the top of the article.