Filtres adaptatifs : Wiener, LMS et annulation du bruit et de l'écho
Équations normales et principe d'orthogonalité démontrés, l'algorithme LMS comme descente de gradient, condition de convergence démontrée, LMS normalisé, annulation du bruit et de l'écho, égalisation.
https://www.electronics-engineering.com/fr/filtres-adaptatifs-wiener-lms-annulation-d-echo/
Les filtres vus jusqu’ici ont des coefficients fixes, calculés une fois pour toutes à partir des spécifications. Mais souvent le signal et la perturbation changent au cours du temps, ou ne sont pas connus à l’avance : l’écho d’une conversation téléphonique dépend de la pièce, le canal d’un modem change avec la ligne, le bruit d’un moteur avec son régime. Un filtre adaptatif met à jour lui-même ses coefficients à chaque échantillon pour minimiser une erreur. Dans cette leçon, nous déduisons le filtre de Wiener avec le principe d’orthogonalité, l’algorithme LMS comme descente de gradient avec la démonstration de la condition de convergence, la version normalisée et les applications.
Le problème
Un filtre RIF de coefficients 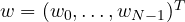 reçoit le vecteur des
 derniers échantillons d’entrée
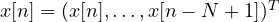 et produit
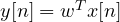 . Il y a un signal désiré
 , et l’erreur est
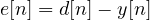 . On cherche les coefficients qui minimisent l’erreur quadratique moyenne
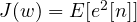 .
Le filtre de Wiener
En développant le carré, avec la matrice d’autocorrélation de l’entrée 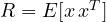 et le vecteur d’intercorrélation
 :
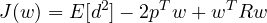
C’est une fonction quadratique des coefficients, un « bol » à un seul minimum.
Théorème. Les coefficients optimaux satisfont les équations normales  , et à l’optimum l’erreur est non corrélée avec chaque échantillon d’entrée :
 .
Démonstration. Le gradient de  par rapport à
 est
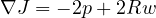 . Le minimum d’une fonction quadratique convexe (
 est semi-définie positive) est là où le gradient s’annule,
 . De plus
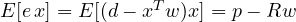 , qui est nul en
 . ∎
Le second résultat est le principe d’orthogonalité : l’erreur optimale ne contient plus rien qui soit prévisible à partir de l’entrée. Le filtre de Wiener exige cependant de connaître et  et de résoudre un système linéaire, et si les statistiques changent, il faut recommencer.
L’algorithme LMS
L’idée de Widrow et Hoff (1960) est de descendre le gradient pas à pas, en utilisant à la place du vrai gradient, qui demanderait des moyennes statistiques, son estimation instantanée. En remplaçant et par  et
 , le gradient estimé est
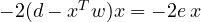 , et le pas de descente devient
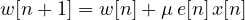
avec le pas d’adaptation  (le facteur 2 est absorbé dans ). Chaque coefficient est corrigé proportionnellement à l’erreur et à l’échantillon d’entrée qu’il multiplie. Le coût est d’environ
 multiplications par échantillon : le même ordre que le filtre.
La convergence
Théorème. Avec des entrées stationnaires, indépendantes d’un pas à l’autre, les coefficients du LMS convergent en moyenne vers la solution de Wiener si et seulement si

où  est la plus grande valeur propre de .
Démonstration. Soit 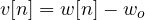 l’écart à l’optimum. En prenant la moyenne de la mise à jour, avec l’hypothèse d’indépendance
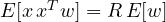 , on obtient
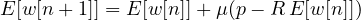 , c’est-à-dire, en utilisant
 ,
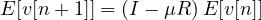
est symétrique,  avec
 orthogonale ; dans les coordonnées
 , les composantes évoluent séparément comme
 . Elles tendent vers zéro si et seulement si
 pour tout
 , c’est-à-dire
 ; la condition la plus restrictive est celle de la plus grande valeur propre. ∎
En pratique, on utilise l’estimation 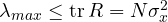 , facile à mesurer :
 . La vitesse de convergence, en revanche, est fixée par la plus petite valeur propre : si les valeurs propres sont très différentes (une entrée très colorée), le LMS converge lentement selon certaines directions. Un grand converge vite mais laisse les coefficients « trembler » autour de l’optimum (le désajustement, une erreur excédentaire) ; un petit est précis mais lent à suivre les changements.
Le LMS normalisé
Si la puissance de l’entrée varie, un fixe devient trop grand ou trop petit. Le NLMS divise le pas par l’énergie courante des échantillons :
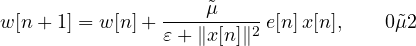
avec un petit  pour éviter la division par zéro. C’est la version utilisée presque toujours, par exemple dans les annuleurs d’écho. Des algorithmes plus coûteux comme le RLS (moindres carrés récursifs) convergent beaucoup plus vite au prix de
 opérations par échantillon, et le filtre de Kalman en est la généralisation aux systèmes décrits dans l’espace d’état.
Les applications
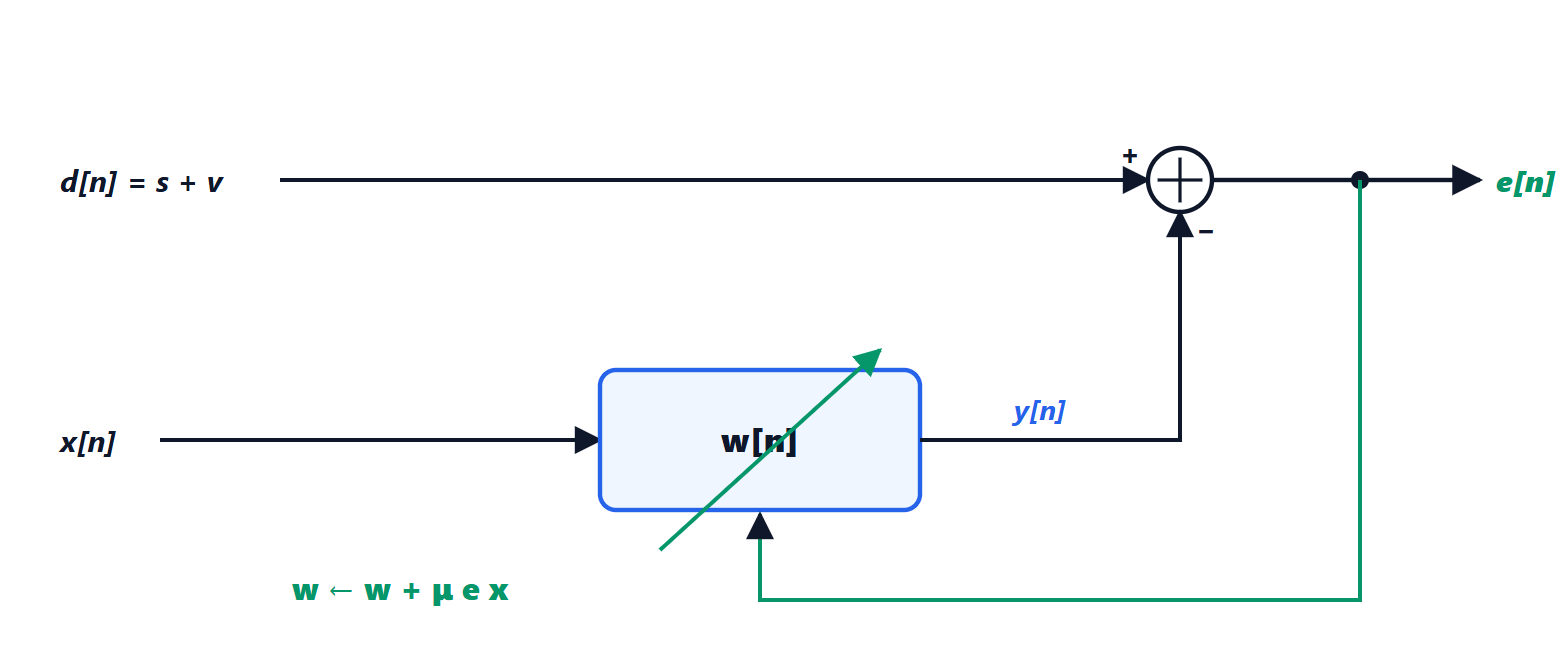
- Annulation du bruit. Un microphone capte la voix plus le bruit, un second ne capte que le bruit (la référence). Le filtre apprend la transformation entre les deux bruits et la soustrait : par le principe d’orthogonalité, l’erreur minimale est exactement la voix, qui n’est pas corrélée avec la référence. Les casques à réduction de bruit active utilisent une variante de ce principe.
- Annulation d’écho. Dans les téléphones mains libres et les appels vidéo, le haut-parleur revient dans le microphone. Le filtre, avec la voix distante comme référence, estime le trajet de l’écho dans la pièce (des centaines de millisecondes, des milliers de coefficients) et le retire.
- Égalisation. Dans un modem ou un récepteur radio, le filtre compense la distorsion du canal en apprenant à partir d’une séquence connue, puis continue à suivre en utilisant les décisions du récepteur.
- Identification. Placé en parallèle avec un système inconnu, avec la même entrée, le filtre converge vers sa réponse impulsionnelle : on l’utilise pour mesurer des acoustiques, des canaux et des processus.


Sono l'autore di questa pagina su «Filtri adattativi: Wiener, LMS e cancellazione di rumore ed eco». Se qualcosa non è chiaro, se vi serve un esempio in più o volete approfondire un punto, scrivetelo qui sotto nei commenti: rispondo personalmente. Se la pagina vi è stata utile, lasciate un voto con le stelle in cima all'articolo.I am the author of this page on “Adaptive filters: Wiener, LMS and noise and echo cancellation”. If something is unclear, if you need another example or want to go deeper into a point, write it in the comments below: I answer personally. If the page was useful, leave a star rating at the top of the article.