Hiérarchies de caches : AMAT multiniveau, préchargement et découpage en blocs
Temps d'accès moyen multiniveau avec démonstration, taux locaux et globaux, caches inclusifs et exclusifs, écriture différée, caches non bloquants et préchargement, découpage en blocs démontré.
https://www.electronics-engineering.com/fr/hierarchies-de-caches-amat-multiniveau-blocs/
Un processeur moderne peut exécuter une instruction en un tiers de nanoseconde, alors qu’un accès à la DRAM en prend une centaine. Entre les deux se trouve une hiérarchie de caches à plusieurs niveaux, et les performances dépendent de son efficacité plus que de toute autre chose. Le cours de Systèmes d’élaboration a présenté le cache, la localité et le temps d’accès moyen. Dans cette leçon, nous regardons les hiérarchies à plusieurs niveaux avec la démonstration de la formule du temps d’accès moyen, les taux de défaut locaux et globaux, les politiques d’écriture, les caches non bloquants et le préchargement, et la technique du découpage en blocs avec la démonstration du trafic économisé.
La hiérarchie à plusieurs niveaux
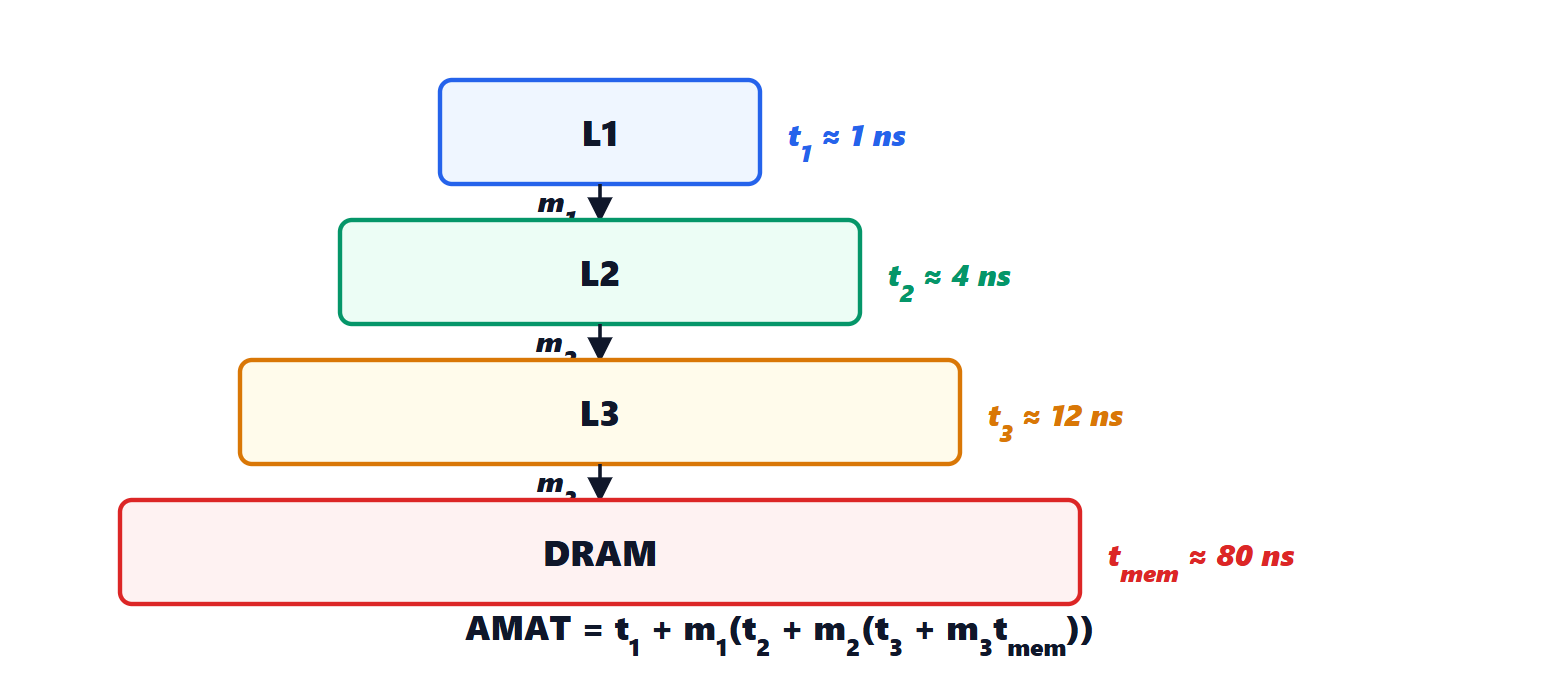
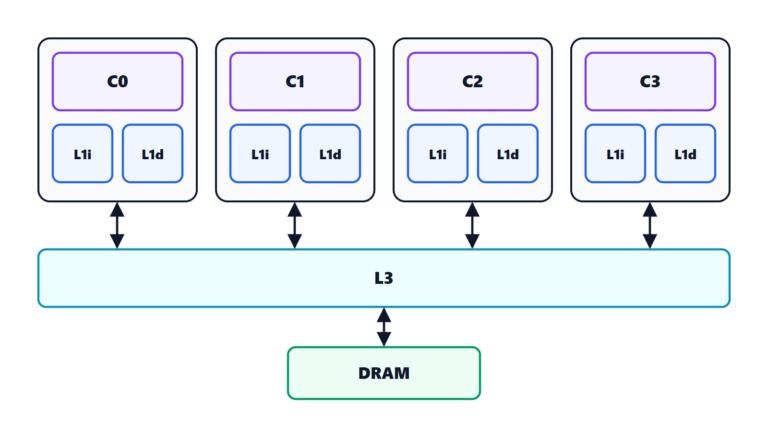
Un processeur typique a un cache de niveau un (L1) de 32-64 Ko pour les données et un pour les instructions, accessibles en 4-5 cycles ; un L2 privé par cœur de 1-2 Mo, en une quinzaine de cycles ; un L3 partagé entre les cœurs de plusieurs dizaines de mégaoctets, en 40-60 cycles ; puis la DRAM.
Théorème. Avec des temps d’accès  et des taux de défaut locaux
 (la fraction des accès arrivant au niveau
 qui n’y trouvent pas la donnée), le temps d’accès moyen à la mémoire d’une hiérarchie à trois niveaux est
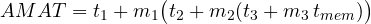
Démonstration. Chaque accès passe  en L1. Avec la probabilité
 , il ne trouve pas la donnée et continue : à partir de là, le temps attendu est le temps d’accès moyen de la hiérarchie qui commence en L2, c’est-à-dire
 plus, avec la probabilité
 , le temps moyen de la hiérarchie qui commence en L3, et ainsi de suite jusqu’à la mémoire, où la donnée est toujours présente. En appliquant la même règle à chaque niveau, on obtient l’expression emboîtée. ∎
Exemple. Avec  ns,
 ,
 ns,
 ,
 ns,
 ,
 ns :
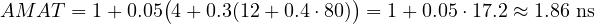
Le temps moyen est proche de celui de L1, bien que la DRAM soit 80 fois plus lente.
Taux locaux et globaux
Le taux local d’un niveau paraît souvent élevé : 30-40 % pour un L2 ou un L3. Ce n’est pas un défaut : seuls les accès que L1 a déjà manqués, c’est-à-dire les difficiles, arrivent à ces niveaux. Ce qui compte est le taux global, la fraction de tous les accès du processeur qui arrivent à la mémoire :  , dans l’exemple
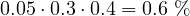 . Pour comparer deux L2, il faut regarder combien d’accès globaux ils économisent.
Les caches sont dits inclusifs si chaque donnée d’un niveau est aussi dans le niveau inférieur (cela simplifie la cohérence), exclusifs si une donnée n’est que dans un seul niveau (cela exploite mieux la capacité totale).
Les écritures
Un cache à écriture immédiate (write-through) écrit chaque modification aussi dans le niveau inférieur : simple et toujours cohérent, mais il génère beaucoup de trafic, atténué par un tampon d’écriture qui met les écritures en file. Un cache à écriture différée (write-back) n’écrit en mémoire que quand le bloc modifié est évincé, en le marquant d’un bit « sale » (dirty) : beaucoup moins de trafic, parce qu’une donnée modifiée cent fois n’est écrite qu’une fois. Presque tous les caches des processeurs sont à écriture différée ; la cohérence entre les cœurs devient alors le problème de la leçon dédiée.
Aux trois causes classiques de défauts (obligatoires, de capacité, de conflit), les multicœurs en ajoutent une quatrième : les défauts de cohérence, quand un autre cœur a invalidé le bloc.
Caches non bloquants et préchargement
Un processeur à exécution dans le désordre ne s’arrête pas à un défaut : il continue avec des instructions indépendantes, et peut générer d’autres accès. Les caches non bloquants gèrent plusieurs défauts à la fois, en les suivant dans des registres dédiés (MSHR) : les attentes se chevauchent et le temps perdu sur chacune diminue. Le parallélisme au niveau de la mémoire compte autant que le parallélisme au niveau des instructions.
Le préchargement (prefetching) amène des données dans le cache avant qu’elles ne soient nécessaires. Les préchargeurs matériels reconnaissent les accès à pas constant (un tableau lu séquentiellement, une colonne d’une matrice) et demandent à l’avance les blocs suivants. Les compilateurs peuvent insérer des instructions explicites de préchargement. Cela marche si c’est opportun (la donnée arrive à temps) et précis (il n’évince pas des données utiles pour des données inutiles).
Écrire du code adapté aux caches
Le programmeur peut beaucoup. Le produit de deux matrices  sous la forme classique à trois boucles lit l’une des deux matrices par colonnes : si
 est grand, chaque élément lu est dans un bloc différent, et le nombre de défauts est de l’ordre de
 .
Le découpage en blocs (blocking ou tiling) divise les matrices en sous-matrices  assez petites pour tenir ensemble dans le cache (
 éléments, moins que la capacité) et calcule le produit bloc par bloc.
Théorème. Avec le découpage en blocs, le nombre d’éléments transférés depuis la mémoire est de l’ordre de  , au lieu de .
Démonstration. Le produit se décompose en  produits de blocs : pour chaque bloc du résultat on additionne
 produits, et il y a
 blocs de résultat. Chaque produit de blocs charge un bloc de chaque matrice,
 éléments, puis travaille dans le cache, en effectuant
 multiplications sans autre transfert. Le total est
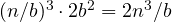 , plus les
 éléments du résultat. ∎
Le trafic est réduit d’un facteur proportionnel à  : avec un L1 de 32 Ko et des nombres de 8 octets,
 , un ordre de grandeur de moins. Les bibliothèques d’algèbre linéaire optimisées appliquent le découpage en blocs à plusieurs niveaux, un par cache, et s’approchent de la performance de crête du processeur. C’est le même principe que l’intensité arithmétique du modèle roofline (leçon sur le SIMD et les GPU).



Benvenuti nella pagina su «Gerarchie di cache: tempo medio multilivello, prefetching e blocking». L'ho scritta pensando a chi studia ingegneria elettronica: se un passaggio non vi torna, un esercizio vi dà un risultato diverso o volete altro materiale sull'argomento, chiedete pure nei commenti e vi risponderò. Un voto con le stelle qui sopra mi aiuta a capire quali pagine migliorare.Welcome to the page on “Cache hierarchies: multilevel AMAT, prefetching and blocking”. I wrote it for engineering students: if a step does not add up, an exercise gives you a different result or you would like more material on the topic, just ask in the comments and I will reply. A star rating above helps me understand which pages to improve.