Mémoire cache : hiérarchie, localité et temps d'accès moyen
La hiérarchie mémoire, la localité, le cache à correspondance directe avec découpage de l'adresse, l'AMAT avec exemples, l'associativité, les politiques d'écriture, l'ordre des boucles.
https://www.electronics-engineering.com/fr/memoire-cache-hierarchie-localite-temps-d-acces-moyen/
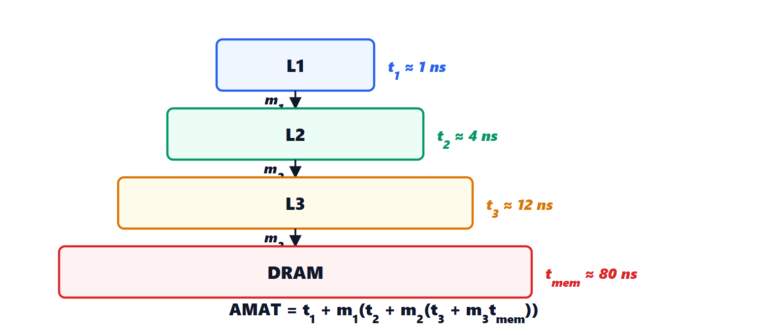
Un processeur moderne exécute une instruction en moins d’une nanoseconde, mais lire une valeur dans la mémoire principale (DRAM) prend environ 80 ns : sans contre-mesures, il passerait presque tout son temps à attendre. La solution est une hiérarchie mémoire : des mémoires petites et très rapides près du processeur, grandes et lentes plus loin. Elle fonctionne grâce à une propriété des programmes, la localité. Dans cette leçon, nous voyons comment est construit un cache, comment on calcule le temps d’accès moyen et comment la manière d’écrire le code change son efficacité.
La hiérarchie
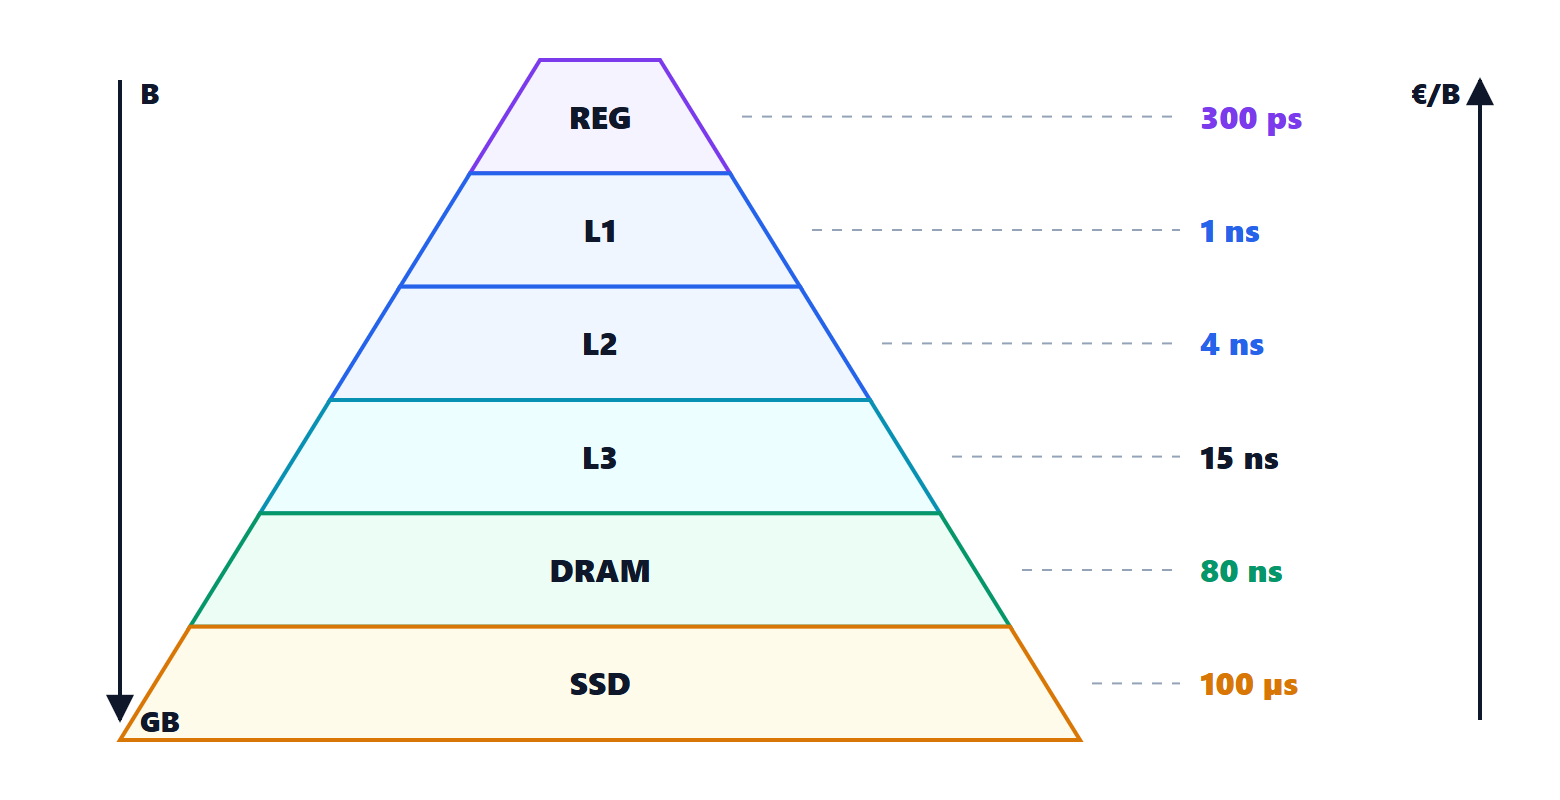
Les mémoires rapides (SRAM, dans les caches) sont chères par bit et occupent beaucoup de surface ; les grandes (DRAM, flash) sont bon marché mais lentes. Chaque niveau contient une copie des parties les plus récemment utilisées du niveau inférieur.
La localité
- Localité temporelle : un élément utilisé récemment sera probablement réutilisé bientôt (les variables d’une boucle, les instructions de la boucle elle-même).
- Localité spatiale : si un élément est utilisé, ses voisins le seront probablement aussi (les éléments suivants d’un tableau, les instructions suivantes).
Pour exploiter cette dernière, le cache ne copie pas des octets isolés mais des blocs (ou lignes) de 64 octets : lire le premier élément d’un tableau amène aussi les suivants dans le cache.
Le cache à correspondance directe
Chaque bloc de mémoire ne peut vivre que dans une seule ligne du cache, choisie par une partie de l’adresse. L’adresse est découpée en trois champs.
Exemple. Un cache de 32 Kio avec des blocs de 64 octets et des adresses de 32 bits : il y a 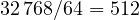 lignes.
- déplacement (offset, 6 bits, car
 ) : quel octet dans le bloc ;
- index (9 bits, car
 ) : quelle ligne du cache ;
- étiquette (tag, les
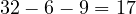 bits restants) : lequel des nombreux blocs qui correspondent à cette ligne est présent.
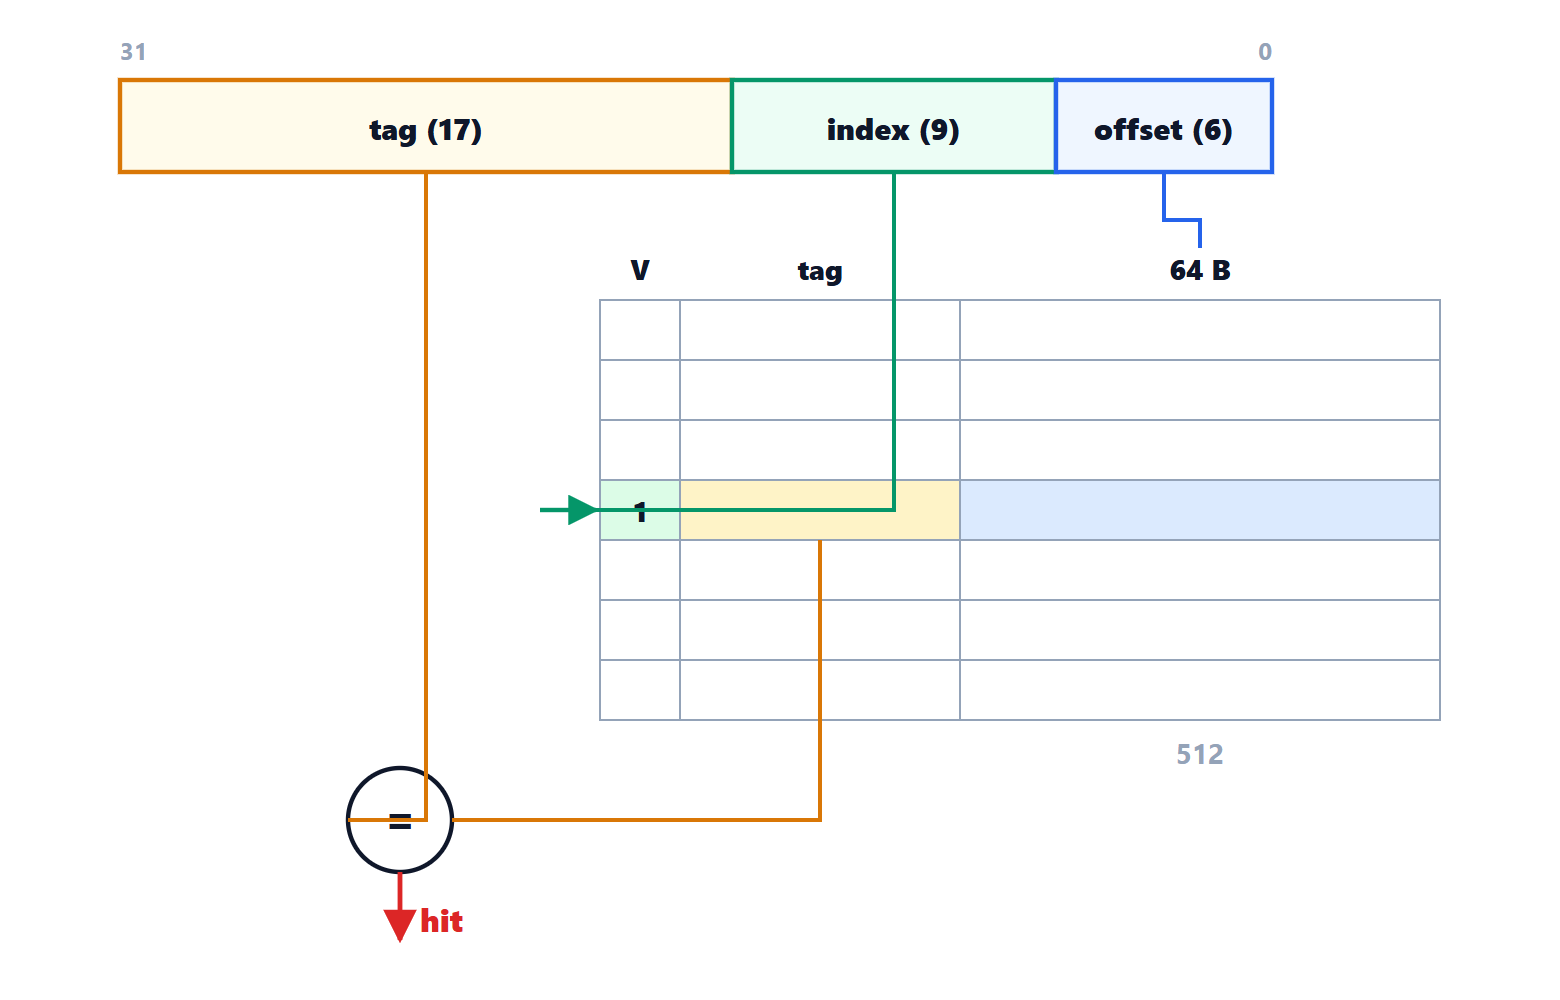
Chaque ligne contient le bloc, l’étiquette et un bit de validité. À l’accès, l’index choisit la ligne et l’étiquette est comparée : si elle coïncide (et que la ligne est valide), c’est un succès (hit), sinon un défaut (miss) : le bloc est lu dans le niveau inférieur et remplace celui qui était présent.
Temps d’accès moyen à la mémoire
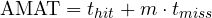
où  est le taux de défauts et
 le temps pour aller chercher le bloc.
Exemple. Un cache à 1 cycle, 5 % de défauts, 100 cycles pour atteindre la DRAM : AMAT = 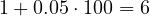 cycles. En ajoutant un cache de second niveau de 10 cycles qui trouve 80 % des blocs manqués au premier niveau : AMAT =
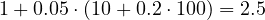 cycles. Le second niveau plus que divise par deux le temps moyen.
Même des taux de défauts qui semblent petits pèsent lourd : passer de 2 % à 4 % de défauts, avec une pénalité de 100 cycles, fait passer l’AMAT de 3 à 5 cycles.
Associativité et types de défauts
Dans un cache à correspondance directe, deux blocs utilisés en alternance qui correspondent à la même ligne s’évincent sans cesse. Les caches associatifs par ensembles à  voies permettent à chaque bloc de vivre dans lignes différentes (un ensemble), en comparant étiquettes en parallèle, et quand l’ensemble est plein ils remplacent le bloc le moins récemment utilisé (LRU). Les caches de premier niveau ont typiquement 8 voies.
Les défauts se classent en « trois C » : obligatoires (le premier accès à un bloc), de capacité (les données utilisées ne tiennent pas toutes), de conflit (des blocs en compétition pour le même ensemble).
Écritures. Avec une politique d’écriture simultanée (write-through), chaque écriture va aussi au niveau inférieur ; avec une écriture différée (write-back), seul le cache est écrit, et le bloc modifié (marqué par un bit « sale », dirty) est recopié en mémoire quand il est remplacé. Cette dernière réduit beaucoup le trafic vers la mémoire et c’est celle qu’utilisent les caches des processeurs.
Le code compte
En C, les matrices sont stockées par lignes : les éléments d’une ligne sont contigus.
/* fast: walks memory in order */
for (i = 0; i < N; i++)
    for (j = 0; j < N; j++)
        s += a[i][j];

/* slow: jumps N elements on every access */
for (j = 0; j < N; j++)
    for (i = 0; i < N; i++)
        s += a[i][j];
Les deux versions font exactement les mêmes calculs, mais avec une grande matrice la seconde peut être plusieurs fois plus lente : chaque accès tombe dans un bloc différent, et quand on revient à la même ligne, son bloc a déjà été remplacé. Organiser les données et les boucles pour exploiter la localité est l’une des optimisations les plus efficaces de toutes, et la base des bibliothèques numériques rapides (qui travaillent sur des blocs qui tiennent dans le cache).

Benvenuti nella pagina su «Memoria cache: gerarchia, località e tempo medio di accesso». L'ho scritta pensando a chi studia ingegneria elettronica: se un passaggio non vi torna, un esercizio vi dà un risultato diverso o volete altro materiale sull'argomento, chiedete pure nei commenti e vi risponderò. Un voto con le stelle qui sopra mi aiuta a capire quali pagine migliorare.Welcome to the page on “Cache memory: hierarchy, locality and average access time”. I wrote it for engineering students: if a step does not add up, an exercise gives you a different result or you would like more material on the topic, just ask in the comments and I will reply. A star rating above helps me understand which pages to improve.