Cohérence des caches et cohérence de la mémoire
Le protocole MESI et l'espionnage du bus, protocoles à répertoire, faux partage, cohérence séquentielle avec démonstration, tampons d'écriture et modèle TSO, barrières et opérations atomiques.
https://www.electronics-engineering.com/fr/coherence-des-caches-mesi-coherence-memoire/
Dans un processeur multicœur, chaque cœur a ses propres caches, mais la mémoire est partagée : quand un cœur modifie une donnée, les autres doivent voir la nouvelle valeur et non une ancienne copie restée dans leurs caches. Il faut distinguer deux questions : la cohérence des caches (coherence), qui concerne une seule adresse, et la cohérence mémoire (consistency), qui concerne l’ordre dans lequel les opérations sur des adresses différentes deviennent visibles. Dans cette leçon, nous regardons le protocole MESI, les protocoles à répertoire, le faux partage, le modèle de cohérence séquentielle avec la démonstration d’une de ses propriétés, et pourquoi les processeurs réels la violent.
Le problème de la cohérence
Le cœur 0 lit la variable  , qui finit dans son cache ; le cœur 1 la lit et la modifie dans le sien. Si le cœur 0 relit dans son cache, il obtient l’ancienne valeur. Un système est cohérent si, pour chaque adresse, tous les cœurs voient les écritures dans le même ordre et si une lecture renvoie toujours la dernière valeur écrite selon cet ordre. Le cours de Systèmes d’élaboration a présenté le problème ; ici nous voyons comment le matériel le résout.
Le protocole MESI
Dans les systèmes à peu de cœurs, les caches sont reliés à un support commun que tous observent (snooping, espionnage du bus) : chaque cache « écoute » les requêtes des autres. Chaque bloc d’un cache est dans l’un de quatre états :
- M (modified) : seul ce cache a le bloc, et il diffère de la mémoire ;
- E (exclusive) : seul ce cache a le bloc, égal à la mémoire ;
- S (shared) : le bloc peut être dans plusieurs caches, tous égaux à la mémoire ;
- I (invalid) : le bloc n’est pas valide.
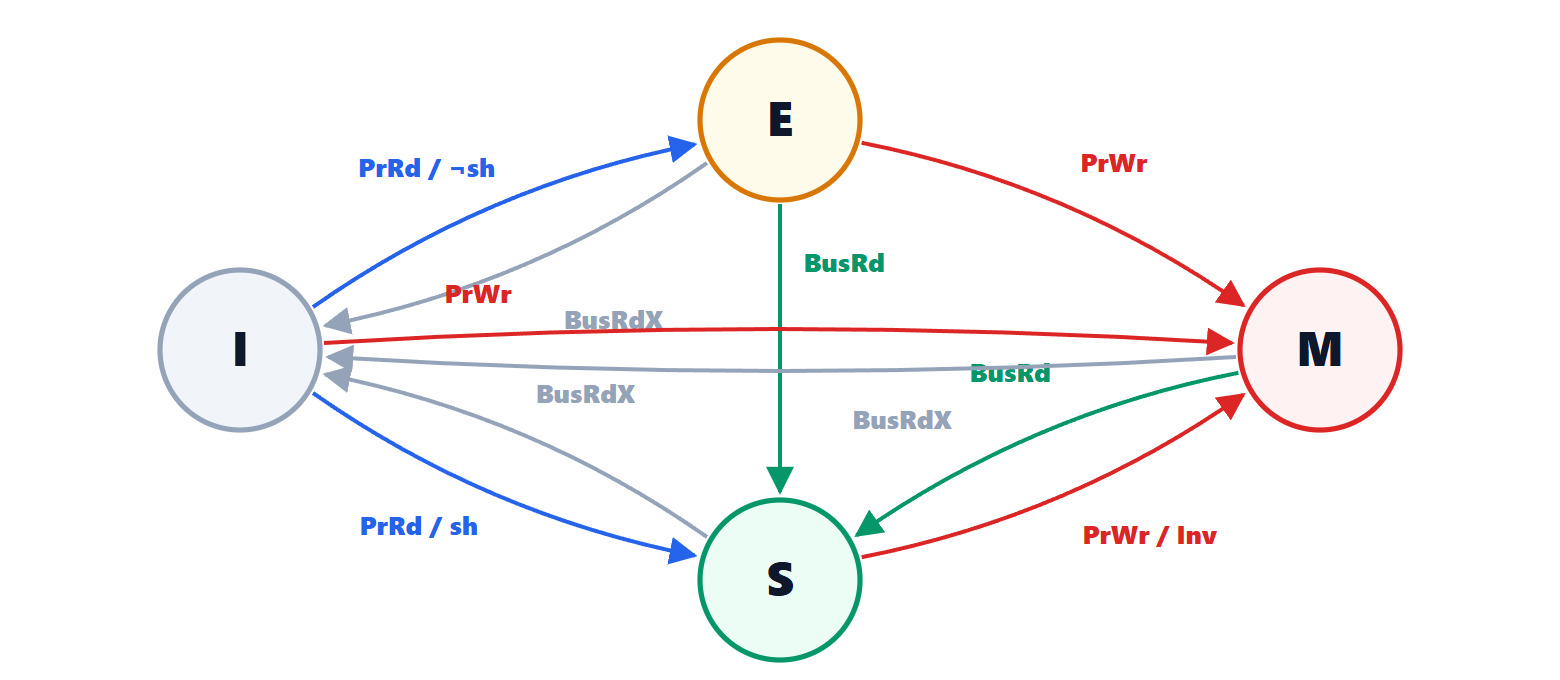
La règle fondamentale est un seul écrivain ou plusieurs lecteurs. Pour écrire un bloc, un cache doit l’avoir à l’état M ou E : s’il l’a à l’état S, il envoie d’abord une requête d’invalidation, et toutes les autres copies passent à I. Quand un autre cache demande à lire un bloc qui est en M, le propriétaire fournit la donnée à jour et passe à S. L’état E est une optimisation importante : une donnée lue par un seul cœur, cas très fréquent, peut ensuite être écrite sans aucun message sur le bus, en passant directement à M.
Les protocoles à répertoire
L’espionnage exige que chaque requête atteigne chaque cache : avec  cœurs, chaque défaut de cache génère
 consultations, et avec des dizaines de cœurs le support commun devient le goulot d’étranglement. Les grands systèmes utilisent un répertoire : pour chaque bloc de mémoire, un enregistrement dit quels caches en ont une copie et dans quel état. Les requêtes vont au répertoire, qui n’envoie les invalidations qu’aux caches concernés. Le trafic ne croît plus avec le nombre de cœurs mais avec le nombre de copies réelles, au prix de la mémoire occupée par le répertoire et d’un saut supplémentaire.
Le faux partage
La cohérence travaille sur des blocs, typiquement de 64 octets, non sur des variables. Si deux cœurs modifient deux variables différentes situées dans le même bloc, par exemple deux compteurs adjacents d’un tableau, chaque écriture de l’un invalide la copie de l’autre, et le bloc fait des allers-retours entre les deux caches, même si les deux cœurs ne partagent aucune donnée. C’est le faux partage (false sharing) : un programme parallèle correct peut tourner plus lentement que le séquentiel. On le résout en espaçant d’au moins un bloc les données utilisées par des threads différents.
La cohérence séquentielle
La cohérence des caches ne suffit pas. Considérons deux threads, avec  au départ :
- thread 1 :
 ; puis

- thread 2 :
 ; puis

Le modèle le plus intuitif est la cohérence séquentielle (Lamport, 1979) : le résultat doit être celui d’un entrelacement des opérations de tous les threads dans un ordre unique, dans lequel chaque thread garde son propre ordre de programme.
Théorème. Sous la cohérence séquentielle, le résultat  est impossible.
Démonstration. Considérons la dernière des quatre opérations dans l’ordre global. Ce ne peut pas être une écriture, parce que dans chaque thread l’écriture précède la lecture. Si c’est , alors a eu lieu avant, et  . Si c’est , alors a eu lieu avant, et
 . Dans tous les cas, au moins l’un des deux vaut 1. ∎
Pourquoi les processeurs la violent
Pourtant, sur un processeur x86, le résultat s’observe réellement. La raison est le tampon d’écriture : pour ne pas s’arrêter, chaque cœur met son écriture dans un tampon et poursuit aussitôt avec la lecture, qui va au cache. Les deux lectures peuvent avoir lieu alors que les deux écritures sont encore dans les tampons, invisibles pour l’autre cœur : les deux lisent 0. Le modèle x86, appelé TSO (total store order), permet exactement ce réordonnancement d’une lecture avant une écriture précédente vers une adresse différente. Les architectures ARM et RISC-V ont des modèles encore plus relâchés, qui permettent presque tous les réordonnancements, en échange de meilleures performances.
Le programmeur rétablit l’ordre quand il le faut avec des barrières (fences), instructions qui forcent les opérations précédentes à se terminer avant les suivantes, et avec des opérations atomiques (lecture-modification-écriture comme le compare-and-swap), sur lesquelles se construisent les verrous et les structures de données concurrentes. Les langages modernes (C11, C++11, Java, Rust) définissent leur propre modèle mémoire et traduisent les opérations atomiques en barrières adaptées à chaque processeur : un programme sans course aux données, qui protège chaque donnée partagée par un verrou ou une opération atomique, se comporte comme si la cohérence était séquentielle.



Sono l'autore di questa pagina su «Coerenza delle cache e consistenza della memoria». Se qualcosa non è chiaro, se vi serve un esempio in più o volete approfondire un punto, scrivetelo qui sotto nei commenti: rispondo personalmente. Se la pagina vi è stata utile, lasciate un voto con le stelle in cima all'articolo.I am the author of this page on “Cache coherence and memory consistency”. If something is unclear, if you need another example or want to go deeper into a point, write it in the comments below: I answer personally. If the page was useful, leave a star rating at the top of the article.