Coerenza delle cache e consistenza della memoria
Protocollo MESI e snooping, protocolli a directory, falsa condivisione, consistenza sequenziale con dimostrazione, buffer delle memorizzazioni e modello TSO, barriere e operazioni atomiche.
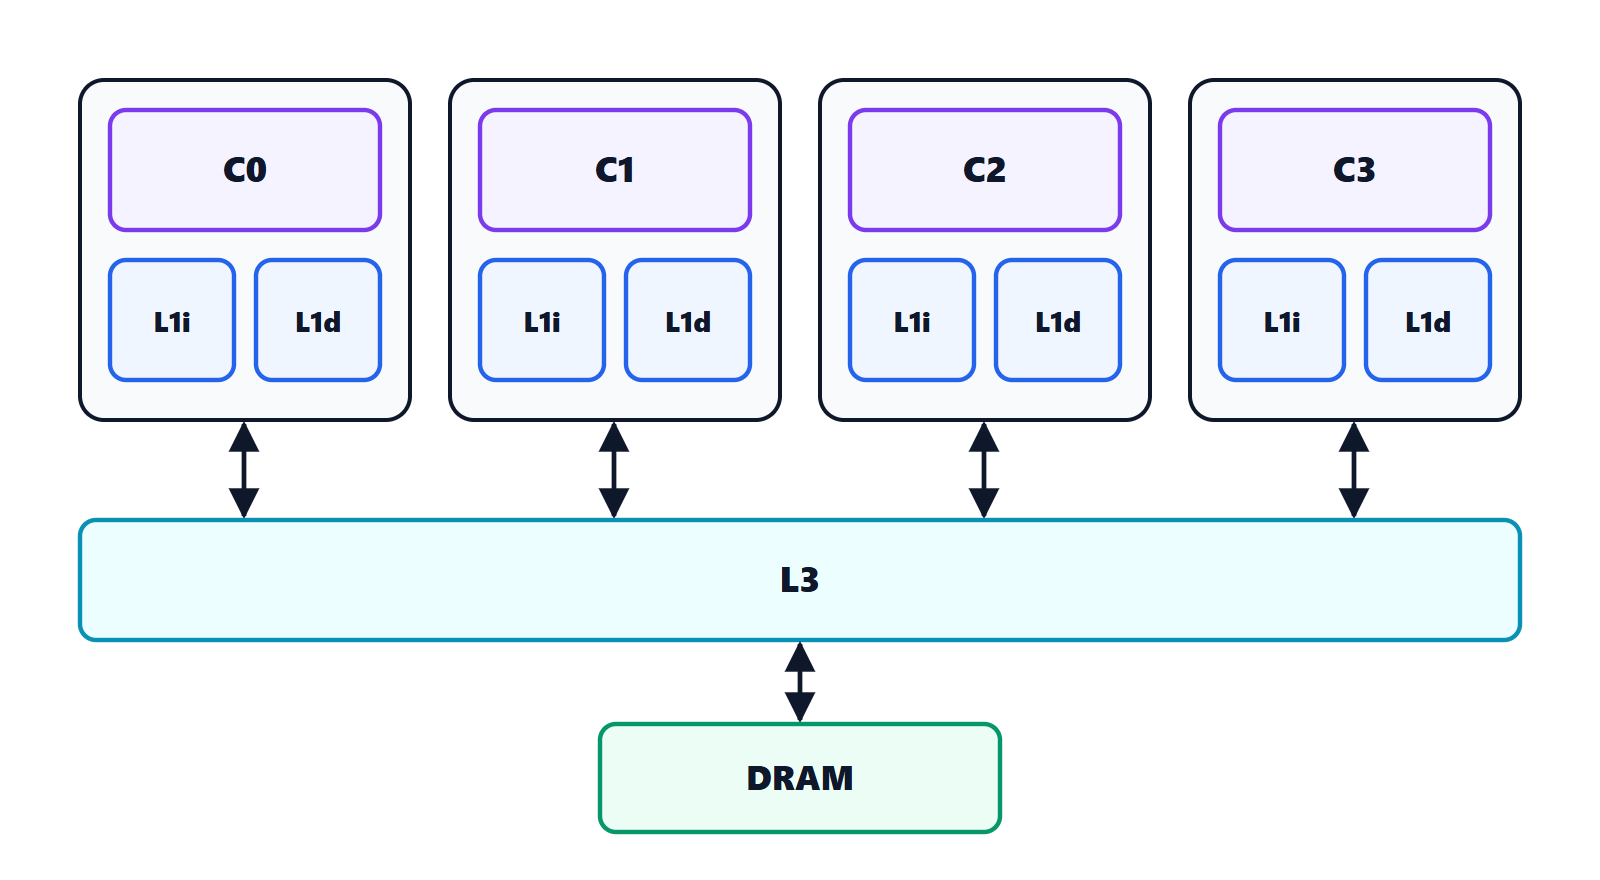
In un processore multicore ogni core ha le proprie cache, ma la memoria è condivisa: quando un core modifica un dato, gli altri devono vedere il valore nuovo e non una copia vecchia rimasta nelle loro cache. Due questioni diverse vanno tenute distinte: la coerenza, che riguarda un singolo indirizzo, e la consistenza, che riguarda l’ordine con cui diventano visibili le operazioni su indirizzi diversi. In questa lezione vediamo il protocollo MESI, i protocolli a directory, la falsa condivisione, il modello di consistenza sequenziale con la dimostrazione di una sua proprietà, e perché i processori reali la violano.
Il problema della coerenza
Il core 0 legge la variabile  , che finisce nella sua cache; il core 1 la legge e la modifica nella propria. Se il core 0 rilegge dalla sua cache, ottiene il valore vecchio. Un sistema è coerente se, per ogni indirizzo, tutti i core vedono le scritture nello stesso ordine e una lettura restituisce sempre l’ultimo valore scritto secondo quell’ordine. Il corso di Sistemi di elaborazione ha introdotto il problema; qui vediamo come lo risolve l’hardware.
Il protocollo MESI
Nei sistemi con pochi core le cache sono collegate a un mezzo comune che tutte osservano (snooping): ogni cache “ascolta” le richieste delle altre. Ogni blocco in una cache è in uno di quattro stati:
- M (modificato): solo questa cache ha il blocco, ed è diverso dalla memoria;
- E (esclusivo): solo questa cache ha il blocco, uguale alla memoria;
- S (condiviso): il blocco può essere in più cache, tutte uguali alla memoria;
- I (invalido): il blocco non è valido.
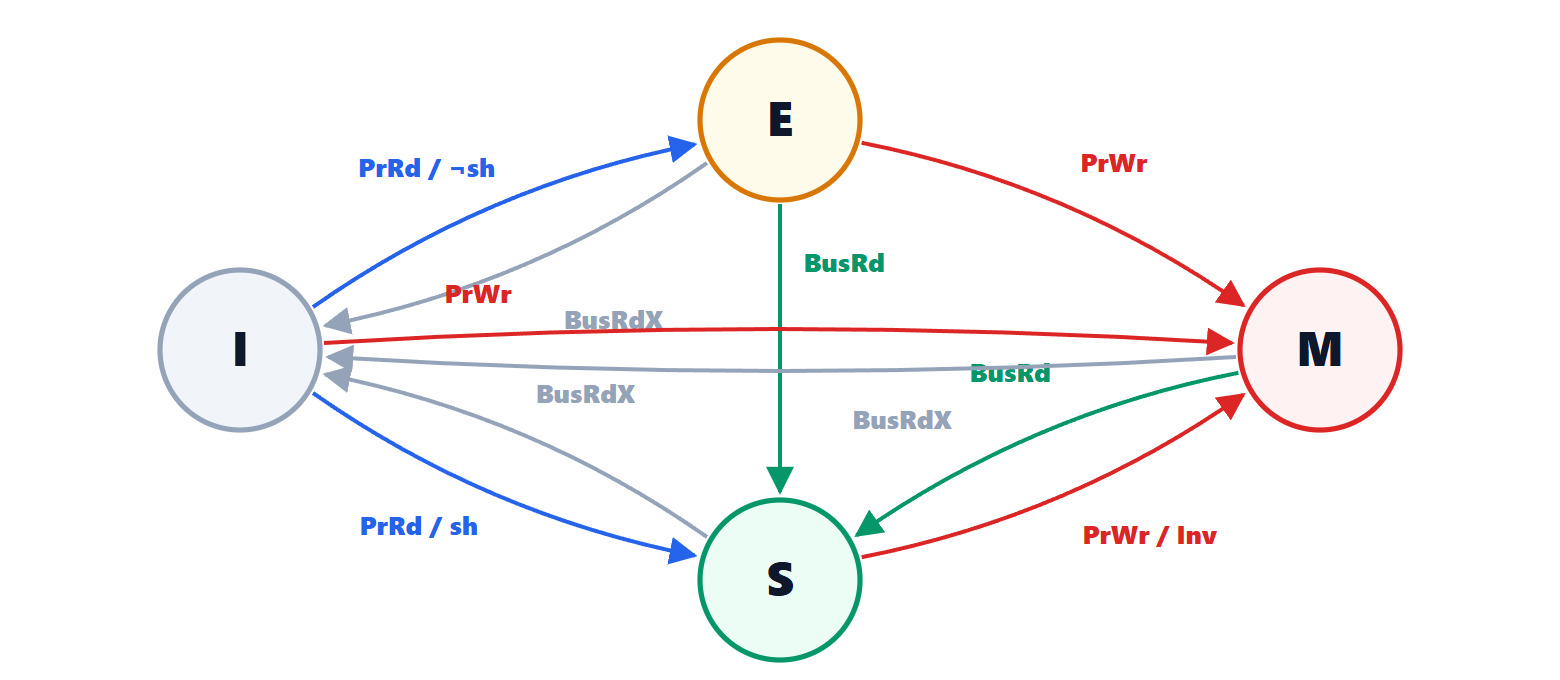
La regola fondamentale è un solo scrittore o molti lettori. Per scrivere un blocco una cache deve averlo in stato M o E: se lo ha in S, prima manda una richiesta di invalidazione, e tutte le altre copie passano a I. Quando un’altra cache chiede di leggere un blocco che è in M, il possessore fornisce il dato aggiornato e passa a S. Lo stato E è un’ottimizzazione importante: un dato letto da un solo core, caso frequentissimo, si può poi scrivere senza nessun messaggio sul bus, passando direttamente a M.
I protocolli a directory
Lo snooping richiede che ogni richiesta raggiunga tutte le cache: con  core ogni fallimento genera
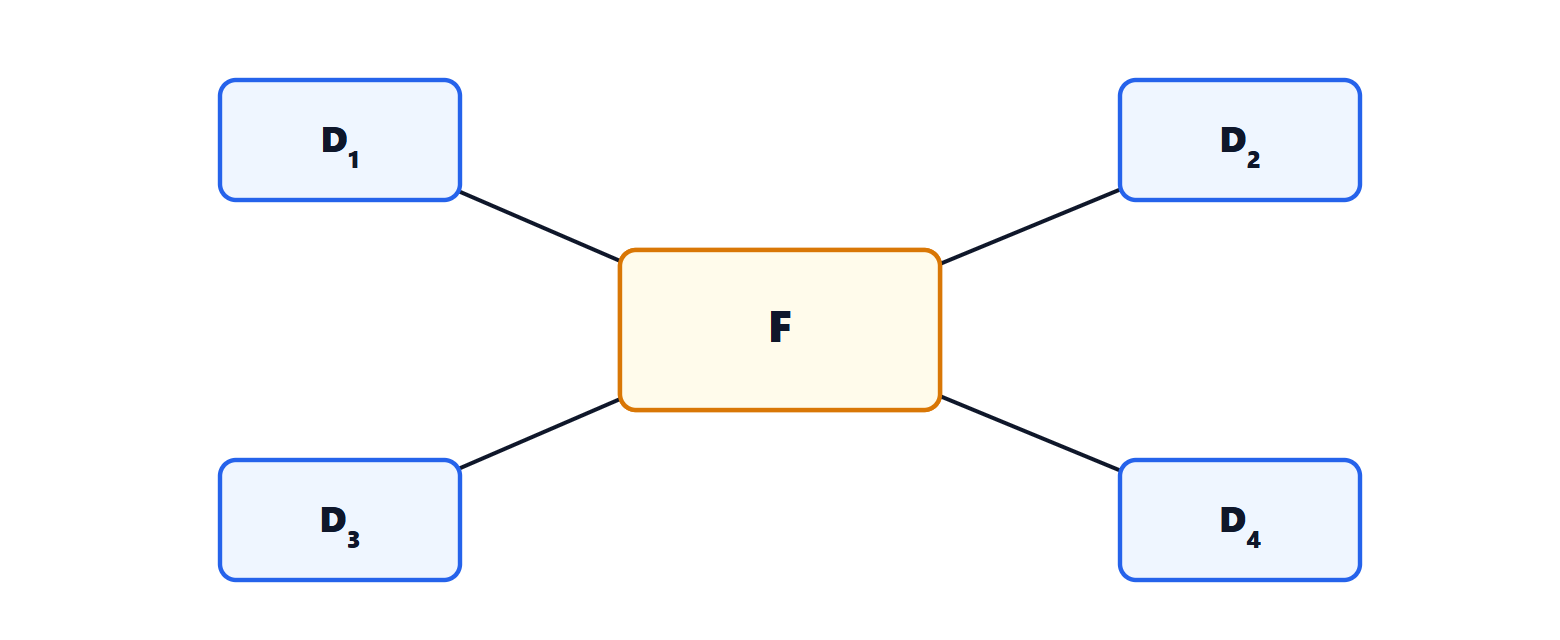
 controlli, e con decine di core il mezzo comune diventa il collo di bottiglia. I sistemi grandi usano una directory: per ogni blocco di memoria un registro dice quali cache ne hanno una copia e in che stato. Le richieste vanno alla directory, che inoltra le invalidazioni solo alle cache interessate. Il traffico non cresce più con il numero di core ma con il numero di copie effettive, al prezzo della memoria occupata dalla directory e di un passaggio in più.
La falsa condivisione
La coerenza lavora a blocchi, tipicamente di 64 byte, non a variabili. Se due core modificano due variabili diverse che stanno nello stesso blocco, per esempio due contatori adiacenti in un vettore, ogni scrittura di uno invalida la copia dell’altro, e il blocco rimbalza continuamente tra le due cache, anche se i due core non condividono nessun dato. È la falsa condivisione (false sharing): un programma parallelo corretto può andare più lento di quello sequenziale. Si risolve distanziando i dati usati da thread diversi di almeno un blocco.
La consistenza sequenziale
La coerenza non basta. Si considerino due thread, con  all’inizio:
- thread 1:
 ; poi

- thread 2:
 ; poi

Il modello più intuitivo è la consistenza sequenziale (Lamport, 1979): il risultato deve essere quello di un qualche intreccio delle operazioni di tutti i thread in un unico ordine, in cui ogni thread mantiene il proprio ordine di programma.
Teorema. Con la consistenza sequenziale, il risultato  è impossibile.
Dimostrazione. Si consideri l’ultima delle quattro operazioni nell’ordine globale. Non può essere una scrittura, perché in ciascun thread la scrittura precede la lettura. Se è , allora è avvenuta prima, e  . Se è , allora è avvenuta prima, e
 . In ogni caso almeno uno dei due vale 1. ∎
Perché i processori la violano
Eppure su un processore x86 il risultato si osserva davvero. Il motivo è il buffer delle memorizzazioni: per non fermarsi, ogni core mette la propria scrittura in un buffer e prosegue subito con la lettura, che va alla cache. Entrambe le letture possono avvenire mentre entrambe le scritture sono ancora nei buffer, invisibili all’altro core: entrambe leggono 0. Il modello di x86, detto TSO (total store order), permette proprio questo riordino di una lettura prima di una scrittura precedente a un altro indirizzo. Le architetture ARM e RISC-V hanno modelli ancora più rilassati, che permettono quasi tutti i riordini, in cambio di prestazioni migliori.
Il programmatore ristabilisce l’ordine quando serve con le barriere (fence), istruzioni che obbligano a completare le operazioni precedenti prima di quelle successive, e con le operazioni atomiche (lettura-modifica-scrittura come compare-and-swap), su cui si costruiscono lock e strutture dati concorrenti. I linguaggi moderni (C11, C++11, Java, Rust) definiscono un proprio modello di memoria e traducono le operazioni atomiche nelle barriere giuste per ogni processore: un programma senza corse critiche (data-race-free), che protegge ogni dato condiviso con un lock o un’operazione atomica, si comporta come se la consistenza fosse sequenziale.