Gerarchie di cache: tempo medio multilivello, prefetching e blocking
Tempo medio di accesso a più livelli con dimostrazione, tassi locali e globali, cache inclusive ed esclusive, write-back, cache non bloccanti e prelievo anticipato, suddivisione a blocchi dimostrata.
Un processore moderno può eseguire un’istruzione in un terzo di nanosecondo, mentre un accesso alla DRAM ne richiede un centinaio. Tra i due c’è una gerarchia di cache a più livelli, e dalla sua efficacia dipendono le prestazioni più che da qualsiasi altra cosa. Il corso di Sistemi di elaborazione ha introdotto la cache, la località e il tempo medio di accesso. In questa lezione vediamo le gerarchie a più livelli con la dimostrazione della formula del tempo medio, i tassi di fallimento locali e globali, le politiche di scrittura, le cache non bloccanti e il prelievo anticipato, e la tecnica della suddivisione a blocchi con la dimostrazione del traffico risparmiato.
La gerarchia a più livelli
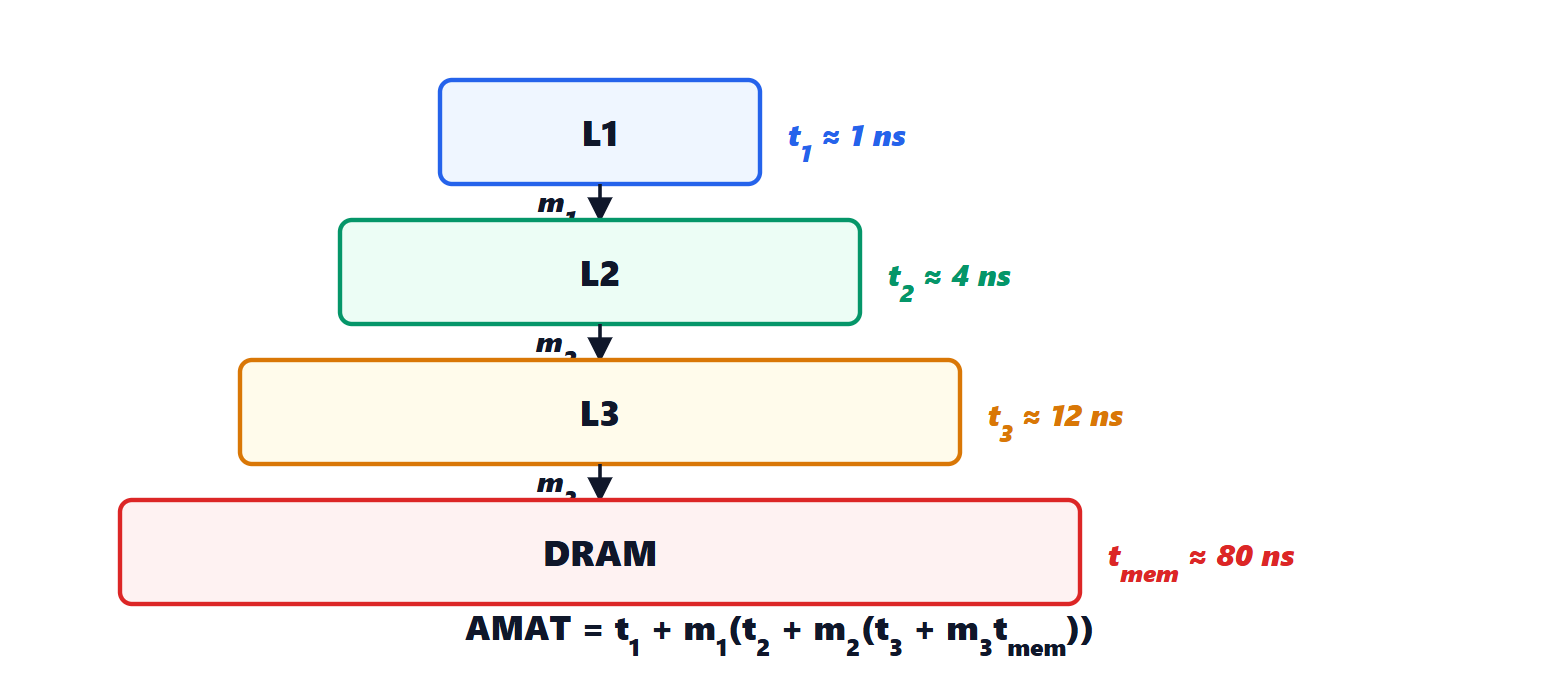
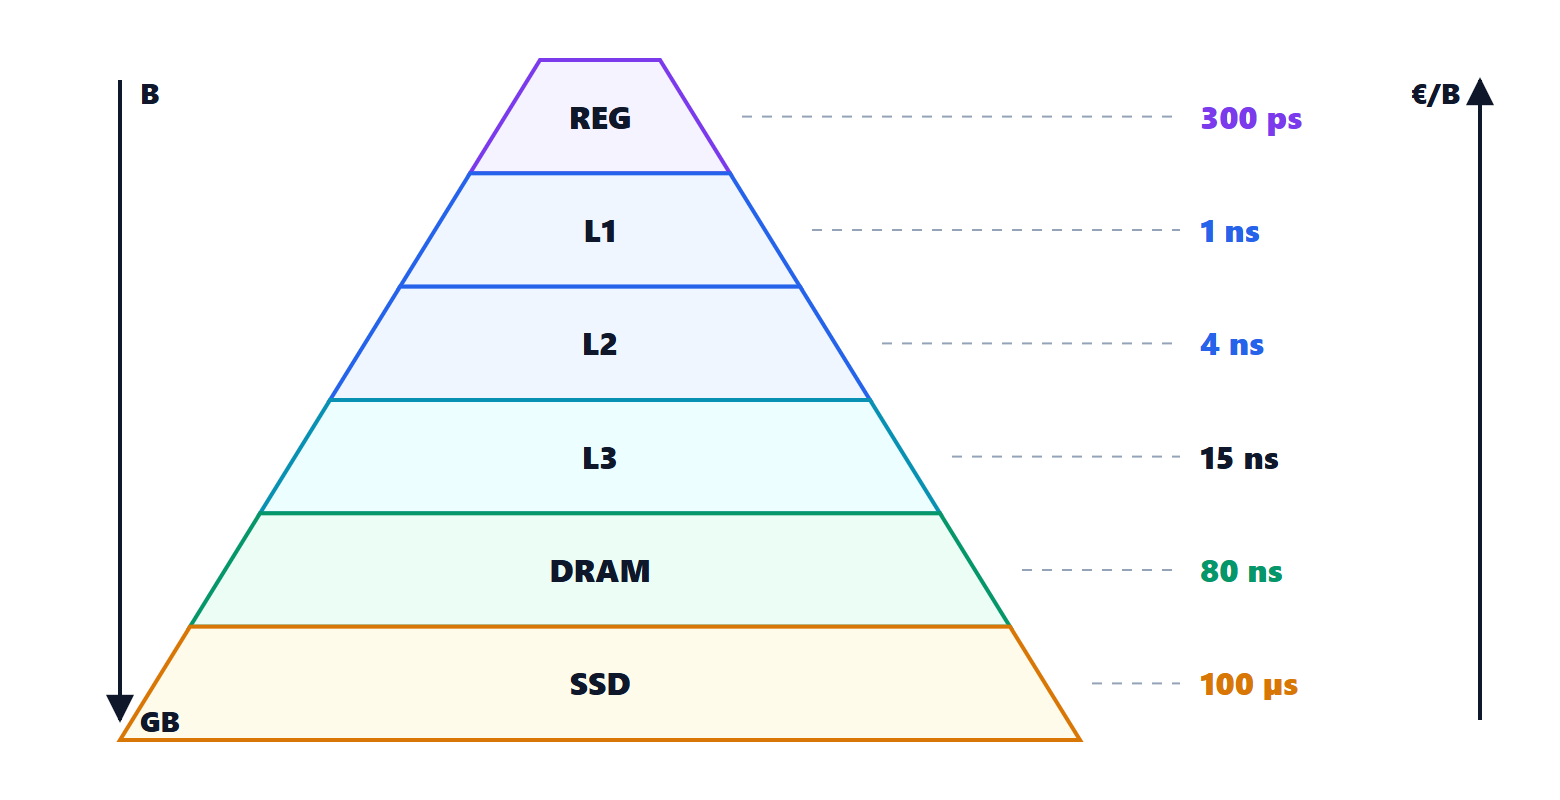
Un processore tipico ha una cache di primo livello (L1) da 32-64 KB per i dati e una per le istruzioni, accessibili in 4-5 cicli; una L2 privata del core da 1-2 MB, in una quindicina di cicli; una L3 condivisa tra i core da decine di megabyte, in 40-60 cicli; poi la DRAM.
Teorema. Con tempi di accesso  e tassi di fallimento locali
 (la frazione degli accessi che arrivano al livello
 e non vi trovano il dato), il tempo medio di accesso di una gerarchia a tre livelli è
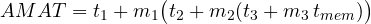
Dimostrazione. Ogni accesso spende  nella L1. Con probabilità
 non trova il dato e prosegue: da quel punto il tempo atteso è il tempo medio di accesso della gerarchia che parte dalla L2, cioè
 più, con probabilità
 , il tempo medio della gerarchia che parte dalla L3, e così via fino alla memoria, dove il dato c’è sempre. Applicando la stessa regola a ogni livello si ottiene l’espressione annidata. ∎
Esempio. Con  ns,
 ,
 ns,
 ,
 ns,
 ,
 ns:
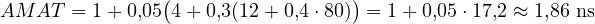
Il tempo medio è vicino a quello della L1, anche se la DRAM è 80 volte più lenta.
Tassi locali e globali
Il tasso locale di un livello sembra spesso alto: il 30-40 % per una L2 o una L3. Non è un difetto: a quei livelli arrivano solo gli accessi che la L1 ha già mancato, cioè quelli difficili. Conta il tasso globale, la frazione di tutti gli accessi del processore che arrivano alla memoria:  , nell’esempio
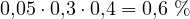 . Per confrontare due L2 bisogna guardare quanti accessi globali risparmiano.
Le cache si dicono inclusive se ogni dato di un livello è anche in quello inferiore (semplifica la coerenza), esclusive se un dato sta in un solo livello (sfrutta meglio la capacità totale).
Le scritture
Una cache write-through scrive ogni modifica anche nel livello inferiore: semplice e sempre coerente, ma genera molto traffico, attenuato da un buffer di scrittura che accoda le scritture. Una cache write-back scrive nella memoria solo quando il blocco modificato viene espulso, segnandolo con un bit “sporco”: molto meno traffico, perché un dato modificato cento volte viene scritto una volta sola. Quasi tutte le cache dei processori sono write-back; la coerenza tra i core diventa allora il problema della lezione dedicata.
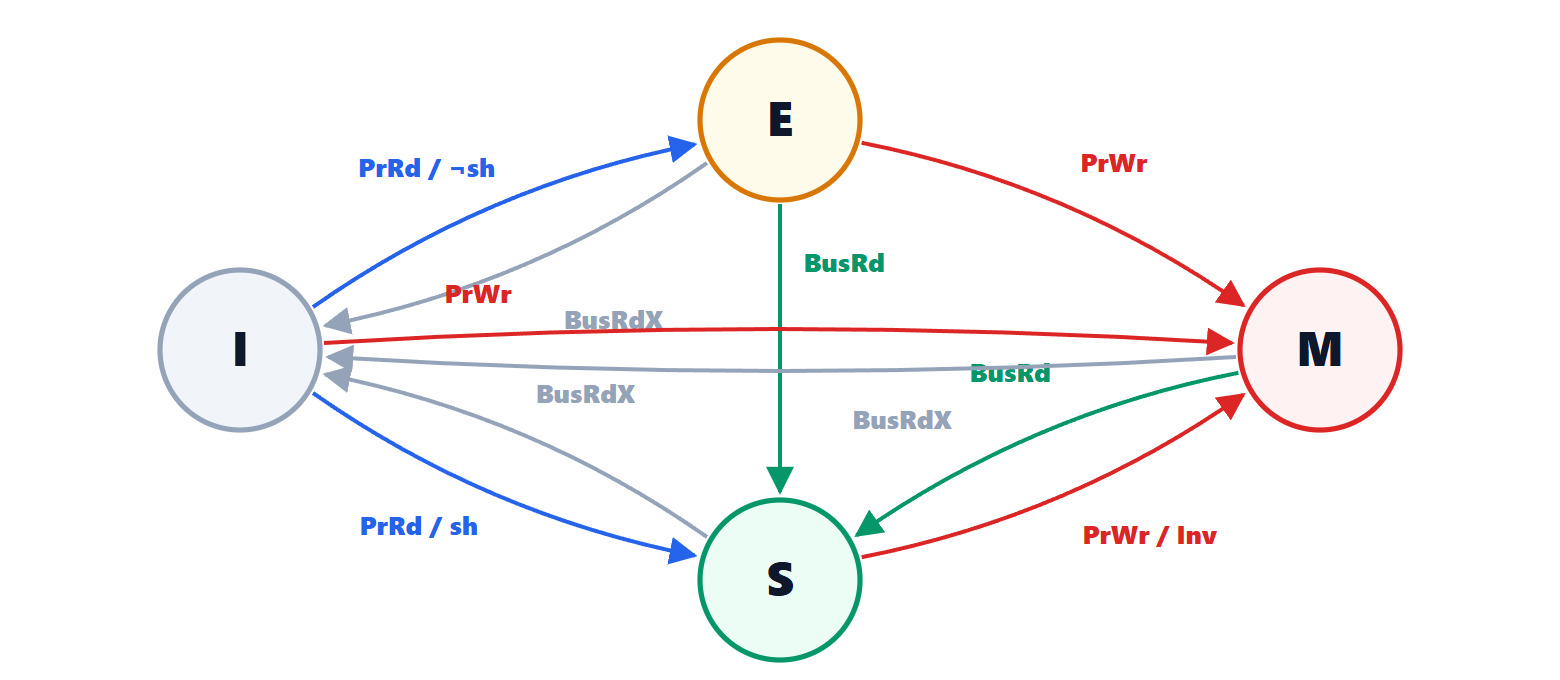
Alle tre cause classiche di fallimento (obbligatori, di capacità, di conflitto) si aggiunge nei multicore la quarta: i fallimenti di coerenza, quando un altro core ha invalidato il blocco.
Cache non bloccanti e prelievo anticipato
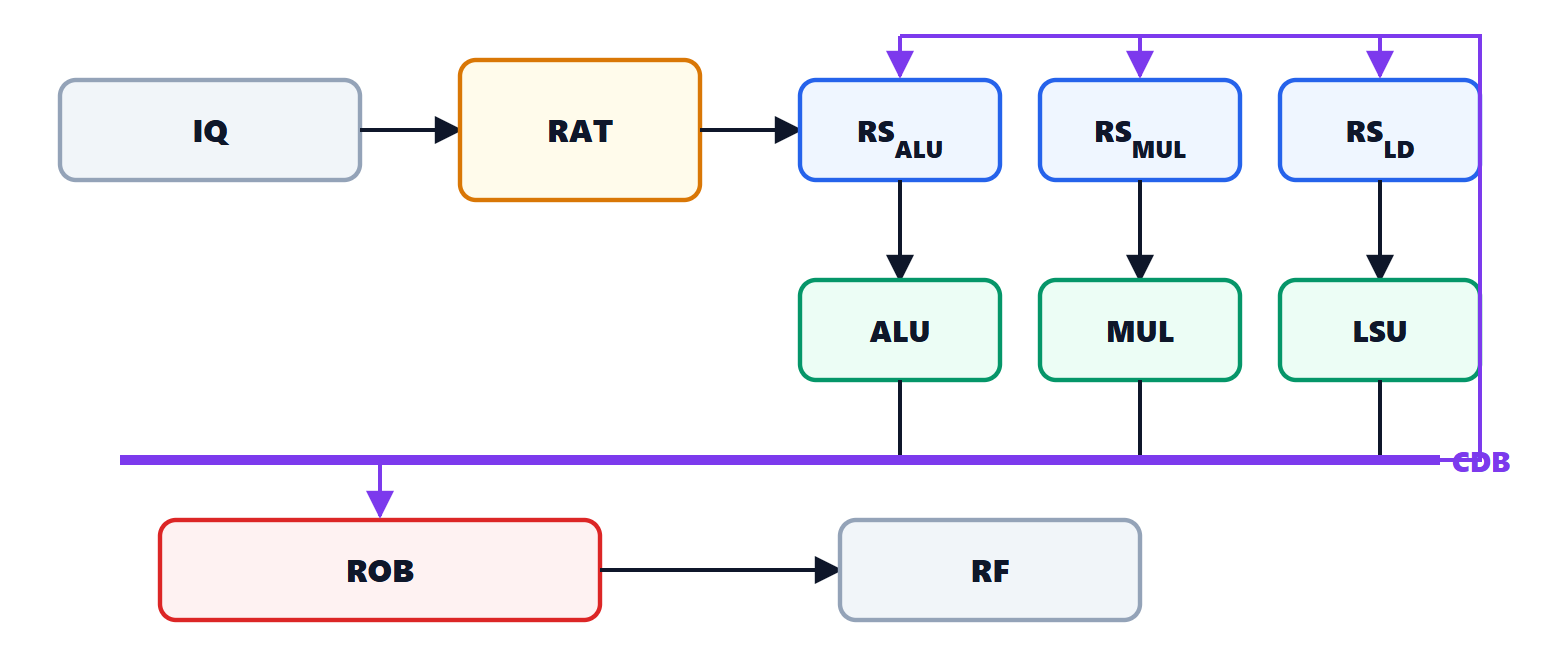
Un processore fuori ordine non si ferma a un fallimento: continua con le istruzioni indipendenti, e può generare altri accessi. Le cache non bloccanti gestiscono più fallimenti contemporaneamente, tenendone traccia in appositi registri (MSHR): le attese si sovrappongono e il tempo perso per ciascuna si riduce. Il parallelismo a livello di memoria conta quanto quello a livello di istruzione.
Il prelievo anticipato (prefetching) porta i dati in cache prima che servano. I prelevatori hardware riconoscono gli accessi a passo costante (un vettore letto in sequenza, una colonna di una matrice) e chiedono in anticipo i blocchi successivi. I compilatori possono inserire istruzioni di prefetch esplicite. Funziona se è tempestivo (il dato arriva in tempo) e preciso (non espelle dati utili per dati inutili).
Scrivere codice amico della cache
Il programmatore può fare molto. Il prodotto di due matrici  nella forma classica a tre cicli legge una delle due matrici per colonne: se
 è grande, ogni elemento letto sta in un blocco diverso, e il numero di fallimenti è dell’ordine di
 .
La suddivisione a blocchi (blocking, o tiling) divide le matrici in sottomatrici  abbastanza piccole da stare in cache insieme (
 elementi minori della capacità) e calcola il prodotto blocco per blocco.
Teorema. Con la suddivisione a blocchi il numero di elementi trasferiti dalla memoria è dell’ordine di  , invece di .
Dimostrazione. Il prodotto si scompone in  prodotti di blocchi : per ogni blocco del risultato si sommano
 prodotti, e i blocchi del risultato sono
 . Ogni prodotto di blocchi carica un blocco di ciascuna matrice,
 elementi, e poi lavora in cache, eseguendo
 moltiplicazioni senza altri trasferimenti. Il totale è
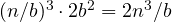 , più gli
 elementi del risultato. ∎
Il traffico si riduce di un fattore proporzionale a  : con una L1 da 32 KB e numeri a 8 byte,
 , un ordine di grandezza in meno. Le librerie di algebra lineare ottimizzate applicano la suddivisione a più livelli, uno per cache, e raggiungono quasi le prestazioni massime del processore. È lo stesso principio dell’intensità aritmetica del modello roofline (lezione su SIMD e GPU).